Otwórz plik PDF wygenerowany przez Microsoft Word lub Excel, przewiń go strona po stronie i nic nie wygląda nietypowo. Wczytaj go do programu Delphi, odczytaj liczbę stron i liczba jest prawidłowa. Włącz szyfrowanie i zapisz go ponownie, a krok zapisu rzuca wyjątek albo plik wyjściowy otwiera się z ostrzeżeniem o uszkodzonych odsyłaczach. Plik nigdy nie był uszkodzony. Jest to plik hybrydowy (hybrid-reference) i właśnie ta struktura, która pozwala piętnastoletniej przeglądarce go otworzyć, jest tą, która pokonuje program wczytujący, który przestaje czytać zbyt wcześnie
To jeden z najczęstszych sposobów, w jaki potok obróbki PDF, który przeszedł każdy wewnętrzny test, spotyka plik, którego nie potrafi przetworzyć w pełnym cyklu (round-trip). Wszystkie dane wejściowe były generowane wewnętrznie, więc nigdy nie były hybrydowe. Pierwszy plik hybrydowy pojawia się w dniu, w którym klient przekazuje fakturę wyeksportowaną z arkusza kalkulacyjnego
Co Word i Excel faktycznie zapisują
ISO 32000-1 opisuje układ hybrydowych odsyłaczy w §7.5.8.4. Aplikacja, która chce korzystać z funkcji PDF 1.5, takich jak strumienie obiektów (object streams), jednocześnie pozwalając czytnikowi PDF 1.4 otworzyć plik, zapisuje informacje o odsyłaczach dwukrotnie. Istnieje klasyczna tabela odsyłaczy (cross-reference table), wiersze ASCII o stałej szerokości, które kończyły każdy PDF aż do wersji 1.4, oraz istnieje strumień odsyłaczy (cross-reference stream), który indeksuje resztę. Zwiastun (trailer) klasycznej sekcji zawiera wpis /XRefStm, którego wartość jest przesunięciem bajtowym tego strumienia
Ten podział pracy jest celowy. Obiekty, do których stary czytnik musi mieć dostęp, wśród nich katalog i drzewo stron, są adresowalne z klasycznej tabeli. Obiekty, które zostały złożone w skompresowane strumienie obiektów, są oznaczone jako wolne (free) w klasycznej tabeli, wpisem typu f, więc czytnik 1.4 przeskakuje wprost za nie i nigdy nie potyka się o strukturę, której nie potrafi przetworzyć. Ich rzeczywiste położenia znajdują się tylko w strumieniu odsyłaczy. Sygnaturą takiego pliku jest jego koniec: krótka klasyczna sekcja obejmująca wyłącznie obiekty, których potrzebuje stary czytnik, której zwiastun wskazuje na /XRefStm, gdzie leżą rzeczywiste dane do odzyskania
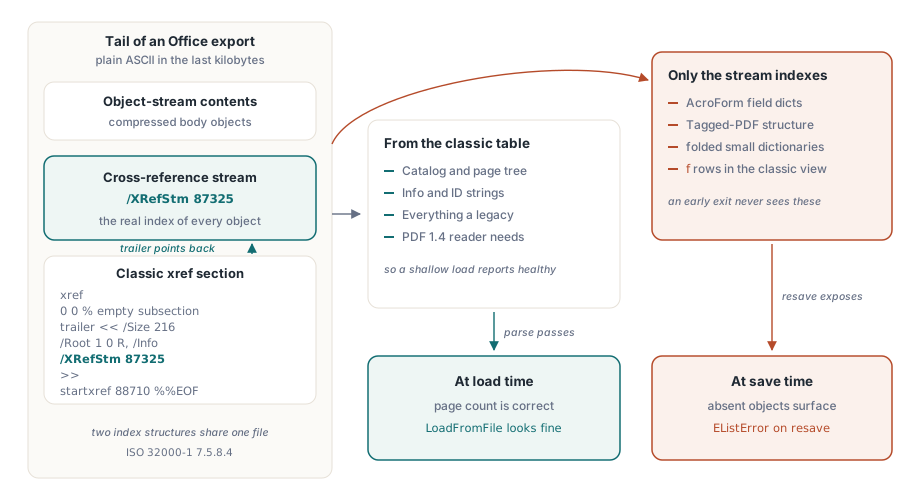
/XRefStm w jego zwiastunie prowadzi do strumienia, który trzyma resztę indeksu obiektówDlaczego prawidłowa liczba stron niczego nie dowodzi
Ponieważ katalog i drzewo stron są celowo osiągalne z klasycznej tabeli, program wczytujący, który czyta tylko tę tabelę, znajduje /Root, przechodzi drzewo stron i zgłasza prawidłową liczbę stron. Wszystko, czego potrzebuje stary czytnik, jest obecne, więc plik wydaje się zdrowy. Obiekty, które zniknęły, to te upakowane w strumieniach obiektów: słowniki pól AcroForm, elementy struktury tagged-PDF, długi ogon małych słowników, które nigdy nie musiały być widoczne dla starszej przeglądarki
Nie zauważasz tej luki, dopóki coś nie dotknie tych obiektów, a pełny ponowny zapis dotyka ich wszystkich. Przejście dokumentu w celu ponownego zaszyfrowania lub przepisania go jest dokładnie operacją, która żąda po kolei każdego numeru obiektu, dlatego objaw ujawnia się w czasie zapisu, a nie w czasie wczytywania, z dala od swojej przyczyny
Pułapką jest detektor, który widzi xref i się zatrzymuje
Tani sposób na zdecydowanie, jak plik jest indeksowany, to podążanie za startxref i sprawdzenie pierwszych bajtów, na które wskazuje. Słowo kluczowe xref oznacza klasyczną tabelę; obiekt strumienia oznacza strumień odsyłaczy. Ten test jest poprawny dla każdego pliku, który zobowiązuje się do jednego schematu. Jest błędny dla pliku hybrydowego, którego startxref celuje w klasyczną sekcję wyłącznie po to, by zadowolić stare czytniki, podczas gdy /XRefStm w zwiastunie tej sekcji to miejsce, w którym większość dokumentu jest faktycznie indeksowana. Detektor, który zwraca „klasyczny” na pierwszym napotkanym xref, nigdy nie czyta /XRefStm, a każdy obiekt, który żyje tylko w strumieniu, staje się niewidoczny
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // strony są osiągalne z klasycznej tabeli
    // sprawdź lub edytuj wczytany dokument tutaj
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // potrzebuje każdego obiektu, także tych wyłącznie ze strumieni
  finally
    Pdf.Free;
  end;
end;
Uruchom tę sekwencję na programie wczytującym zbudowanym wokół detektora z wczesnym wyjściem, a wczytywanie wygląda dobrze; to ponowny zapis jest miejscem, w którym brakujące obiekty dają o sobie znać. Rozwiązaniem nie jest odczytanie większej liczby bajtów na początku; jest nim rozpoznanie hybrydowego zwiastuna i podążenie za /XRefStm przed uznaniem pliku za gotowy
Kolejność scalania nie podlega negocjacji
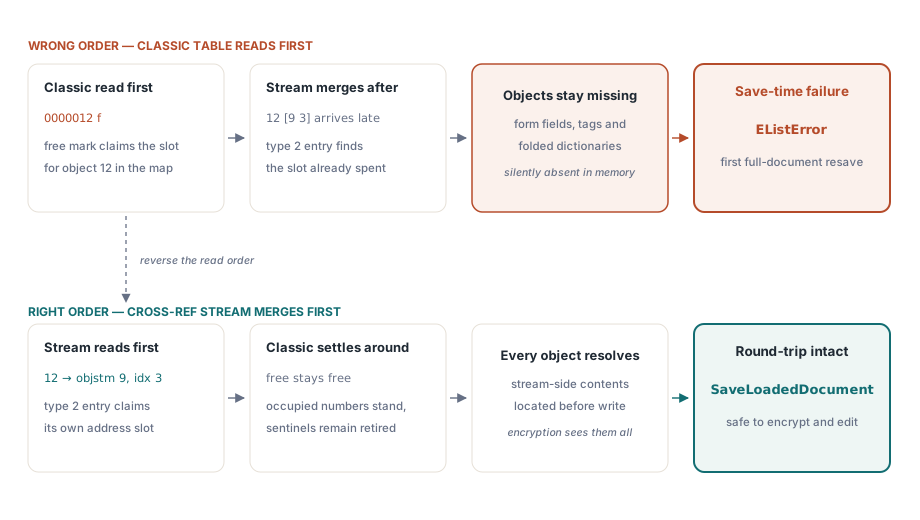
Gdy oba indeksy zostaną odczytane, można je połączyć tylko w jednym kierunku. Strumień odsyłaczy musi zostać scalony jako pierwszy, z klasycznymi wpisami wypełnionymi wokół niego. Powodem jest małe oszustwo leżące u podstaw formatu. Plik hybrydowy oznacza swoje skompresowane obiekty jako wolne w klasycznej tabeli, aby stare czytniki je zignorowały. Program wczytujący, który stosuje zasadę „pierwszy widziany wygrywa” (first-seen-wins) i czyta klasyczną tabelę jako pierwszą, zapisze te numery obiektów jako wolne, a następnie odrzuci wpisy strumienia, które faktycznie je lokalizują, ponieważ sloty są już zajęte. Odwróć kolejność, a wpisy typu 2 ze strumienia, z których każdy to numer strumienia obiektów plus indeks, wygrywają sloty, które mają posiadać, a klasyczne wpisy układają się wokół nich
Ta sama dyscyplina chroni przed wskrzeszeniem usuniętego obiektu przez starszą rewizję. Aktualizacje przyrostowe (incremental updates) łączą się wstecz przez /Prev, a wolny wpis typu 0 jest wartownikiem (sentinel) sygnalizującym, że nowsza sekcja wycofała numer obiektu. Późniejsza, starsza sekcja w łańcuchu nie może zostać dopuszczona do nadpisania tego wartownika przestarzałym położeniem. Traktuj zasadę „pierwszy widziany” jako miarodajną dla znaczników wolnych i usunięty obiekt pozostaje usunięty; traktuj ją niedbale, a własna historia pliku wskrzesi treść, którą najnowsza rewizja usunęła
Jak oba widoki przestają się zgadzać
Cała ta mechanika zakłada, że oba indeksy się zgadzają. Prosto z Worda — zgadzają się: każdy widok opisuje ten sam dokument w obrębie zakresu, który deklaruje. Kłopoty zaczynają się, gdy plik przechodzi przez narzędzie rozumiejące tylko jeden z nich. Tradycyjnymi podejrzanymi są narzędzia nakładające pieczęcie. Jedno dopisuje przyrostową aktualizację w starym stylu: garść nowych obiektów, nową sekcję xref, łącze /Prev wstecz do poprzedniej sekcji i świeży zwiastun. Jeśli ten zwiastun gubi /XRefStm, widok strumienia zostaje osierocony. Jeśli kopiuje starą wartość dalej, widok strumienia wciąż opisuje dokument sprzed nałożenia pieczęci. W obu przypadkach indeksy przestają się zgadzać
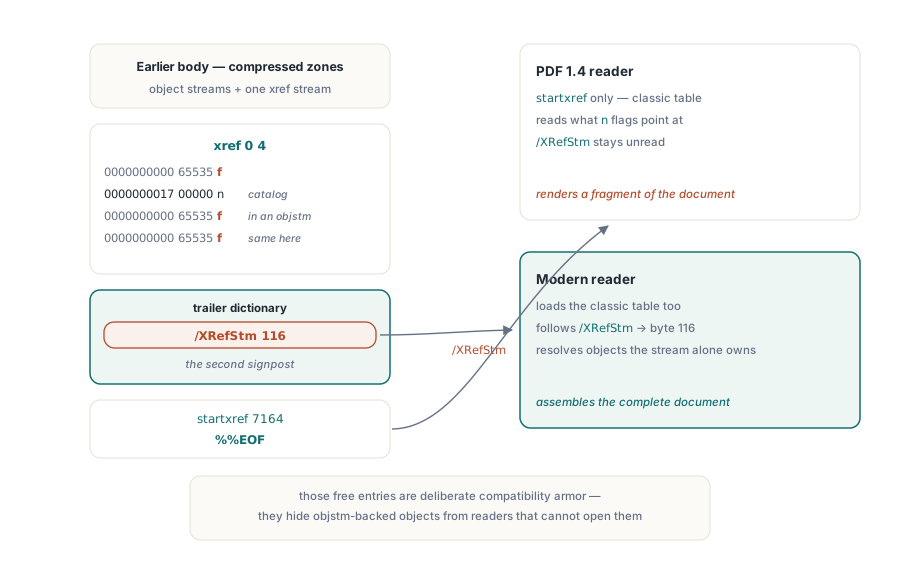
Sygnaturę łatwo rozpoznać, gdy się już ją zna. Obiekty widoczne przez jeden widok w drugim znikają albo są nieaktualne. Czytnik rozwiązujący przez strumień znajduje wersję obiektu sprzed edycji albo w ogóle nie znajduje wpisu za obiekt dopisany. Czytnik ufający wyłącznie tabeli widzi edycję, ale traci każdy skompresowany obiekt, który mógł zlokalizować tylko strumień. Użytkownicy opisują to jako pola formularzy, które pojawiają się w jednej przeglądarce i znikają w innej, adnotacje, które przebieg nakładania pieczęci podobno usunął, albo odwołania lądujące na zupełnie innym obiekcie
To Adobe Acrobat sprawia, że tropienie tych plików jest takie kosztowne. Gdy zadeklarowany indeks rozmija się z bajtami, Acrobat zwykle po cichu przebudowuje dane odsyłaczy, skanując w poszukiwaniu nagłówków obiektów, więc ten, kto wyprodukował zepsuty plik, otwiera go, nie widzi niczego niepokojącego i odsyła dalej. Awaria wychodzi później i gdzie indziej — w walidatorze preflight, w usłudze podpisującej, w zadaniu przyjmowania archiwów — w każdym konsumencie, który ufa zadeklarowanej strukturze i zgłasza brakujące obiekty albo niezgodność odsyłaczy. „W Acrobacie otwiera się bez zarzutu” — tak zaczyna się niemal każde zgłoszenie dotyczące desynchronizacji pliku hybrydowego
Co to oznacza w HotPDF
Silnik rozwiązuje pliki hybrydowe za ciebie i robi to na każdej ścieżce, która musi przetworzyć dane odsyłaczy. Wczytaj dokument za pomocą LoadFromFile lub LoadFromStream, wprowadź swoje zmiany i wywołaj SaveLoadedDocument; lub uruchom operację jednoetapową, taką jak EncryptFile, która czyta wejście i zapisuje wyjście. Tak czy inaczej, odzyskiwanie czyta /XRefStm, scala sekcję strumienia przed klasycznymi wpisami i rozwiązuje obiekty żyjące w strumieniach, zanim zapis je wyliczy. Ścieżka szyfrowania AES-256 jest miejscem, gdzie widać to najwyraźniej, ponieważ szyfrowanie dokumentu przepisuje każdy obiekt, a więc wymaga, aby każdy obiekt został już zlokalizowany
// Jednorazowo: odczytaj hybrydowe wejście, zapisz kopię zaszyfrowaną AES-256
Pdf.EncryptFile('Letter_DOC.pdf', 'Letter_secured.pdf',
  'owner-secret', '', aes256, [prPrint, prFillAnnotations]);
Szczegół warty zapamiętania znajduje się powyżej samego API. Pliki, które przychodzą z Worda, Excela, PowerPointa oraz z długiej listy potoków „Zapisz jako PDF”, są rutynowo hybrydowe, więc program wczytujący, który testujesz tylko na wyjściu własnego generatora, może nigdy nie spotkać takiego pliku podczas testów. Zaszczep swoje zestawy testowe dokumentami wyeksportowanymi z prawdziwych aplikacji Office, a nie tylko plikami wyprodukowanymi przez twój własny kod
Sprawdzanie pliku, który podejrzewasz
Dwie inspekcje szybko rozstrzygają kwestię. Otwórz plik w widoku szesnastkowym i odczytaj bajty po ostatnim startxref; plik hybrydowy pokazuje krótką klasyczną sekcję, której słownik zwiastuna zawiera /XRefStm. Albo porównaj liczbę obiektów zgłaszaną przez pełne przetworzenie z najwyższym numerem obiektu, który /Size deklaruje w zwiastunie. Duża różnica oznacza, że obiekty ukrywają się w strumieniach, których program wczytujący nie otworzył, co jest tym samym niedoborem, który później zamienia się w awarię w czasie zapisu
Koniec typowego eksportu z Excela czyni pierwsze sprawdzenie konkretnym. Wszystko po ostatnim słowie kluczowym xref jest zwykłym ASCII, więc sygnatura jest czytelna wprost z widoku szesnastkowego (przesunięcia poglądowe, adnotacje dodane)
xref
0 16                         % obiekty 0-15: to, czego potrzebuje stary czytnik
0000000000 65535 f
0000000017 00000 n
...                          % 14 dalszych wierszy; reszta mieszka w strumieniach obiektów
trailer
<< /Size 216                 % jeden więcej niż najwyższy używany numer obiektu
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % bajtowy offset strumienia odsyłaczy
>>
startxref
88710                        % wskazuje klasyczną sekcję powyżej
%%EOF
Klucz /XRefStm w zwiastunie to właśnie ta wskazówka. Klasyczna sekcja powyżej wymienia 16 z 216 numerów obiektów, jakich plik używa; wszystko upakowane w strumienie obiektów jest z niej albo nieobecne, albo oznaczone jako wolne. Detektor, który zatrzymuje się na słowie kluczowym xref, widział w tym momencie tylko ten częściowy indeks. Gdy wolisz zeskryptować sprawdzenie niż oglądać je na oko, znacznik siedzi w ostatnich kilku kilobajtach pliku, więc ograniczony odczyt wsteczny wystarczy. Jeśli plik był później aktualizowany przyrostowo, koniec trzyma więcej niż jeden zwiastun, a liczy się ten ostatni
// Zwraca offset /XRefStm z najnowszego zwiastuna w końcówce pliku,
// albo -1, gdy znacznika nie ma (plik nie jest hybrydowy albo w ogóle nie jest PDF-em)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P, Q: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // zwiastun mieszka w końcówce
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // ograniczony odczyt wsteczny: maks. 2 KB
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := 0;                               // zachowaj ostatni znacznik: aktualizacje
  Q := Pos(AnsiString('/XRefStm'), Tail); // dopisują nowsze zwiastuny
  while Q > 0 do
  begin
    P := Q;
    Q := Pos(AnsiString('/XRefStm'), Tail, P + 1);
  end;
  if P = 0 then
    Exit;                               // brak znacznika hybrydowego w końcówce
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // pomiń białe znaki po kluczu
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// Użycie: nieujemny wynik nazywa bajt, od którego zaczyna się strumień
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
Traktuj tę sondę jako triaż, a nie jako parser: mówi ci, które pliki w partii zasługują na uwagę przed uruchomieniem zadania ponownego zapisu, i nic więcej
Skieruj ją na folder prawdziwych danych wejściowych, a pliki ułożą się w trzy grupy. Plik wyłącznie klasyczny ma słowo kluczowe trailer w końcówce, ale nie ma /XRefStm, więc sonda zwraca -1. Plik, który w całości przeszedł na strumienie odsyłaczy, również zwraca -1 i słusznie. Nie ma w nim wcale słowa kluczowego trailer, bo jego klucze zwiastuna mieszkają w słowniku strumienia. Tylko układ podwójnie indeksowany daje offset. Jeśli twój raport triażu musi rozróżnić pierwsze dwie grupy, poszukaj w tej samej końcówce słowa trailer, zanim ją odłożysz; załatwia to jedno dodatkowe wywołanie Pos
Zanim sonda ruszy bez nadzoru, utwardź ją w dwóch miejscach. Offset to tylko deklaracja. Skocz pod ten adres i potwierdź, że siedzi tam naprawdę obiekt, którego słownik mówi /Type /XRef, bo uszkodzony albo ucięty plik może wciąż nieść ten klucz, mimo że wskazany przez niego strumień już zniknął. Taki plik wpada do innej szuflady niż zdrowy hybrydowy. To sprawdzenie to kilka linijek na wierzchu tego samego przetwarzania pliku
// Offset to wartość zwrócona przez FindXRefStm; FS to TFileStream otwarty
// tak samo, a Head to AnsiString (Min pochodzi z System.Math)
if Offset >= FS.Size then
  Exit(False);                          // klucz przetrwał, strumień nie
FS.Position := Offset;
SetLength(Head, Integer(Min(Int64(512), FS.Size - Offset)));
FS.ReadBuffer(Head[1], Length(Head));
Result := (Pos(AnsiString('/Type /XRef'), Head) > 0) or
  (Pos(AnsiString('/Type/XRef'), Head) > 0);  // składnia PDF dopuszcza obie pisownie
Potem zrób z okna 2 KB parametr. Dwa kilobajty obejmują zwykłe wyjście z Office, ale wyjątkowo duży słownik zwiastuna potrafi wypchnąć znacznik poza zakres, a poszerzenie okna jest lepsze niż przypadkowe uznanie pliku za klasyczny
Routing plików hybrydowych przez potok
Detekcja procentuje wtedy, gdy zmienia miejsce, w które plik trafi dalej. A które to miejsce, zależy od tego, co potok zamierza z nim zrobić
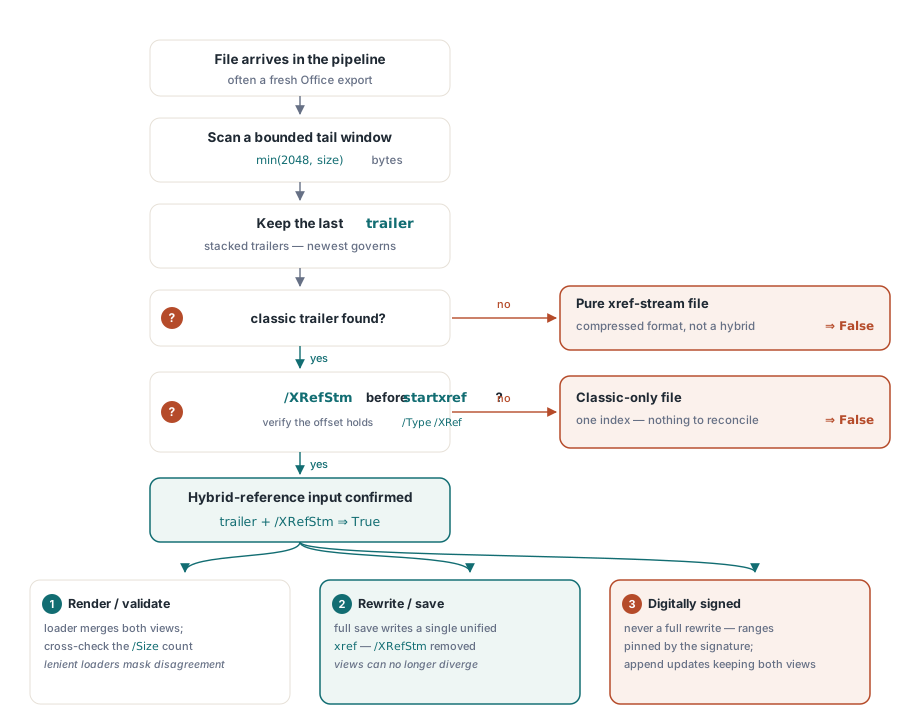
Pliki, które są wyłącznie czytane, renderowane albo walidowane, powinny trafiać do programu wczytującego rozwiązującego oba widoki. PDFium Component przetwarza łańcuch /XRefStm już podczas wczytywania, więc tabela obiektów, którą widzi twój kod, jest od razu scalona, a sprawdzenia opisane w naszym artykule o walidacji strumieni obiektów i odsyłaczy działają bez zmian. Gdy zdesynchronizowany plik hybrydowy jest uszkodzony na tyle mocno, że odmawia wczytania, silnik zgłasza to swoim kodem błędu wczytywania, a uszkodzenie struktury sygnalizuje właśnie FPDF_ERR_FORMAT. Czyste wczytanie jest słabszym dowodem. PDFium z założenia jest pobłażliwy i większość niespójnych plików przebudowuje bez słowa komentarza, więc sukces dowodzi jedynie, że plik dało się odratować, i nie mówi nic o tym, czy jego dwa widoki się zgadzają. Na to pytanie wróć do porównania tego, co znajduje pełne przejście po obiektach, z /Size w zwiastunie
Pliki modyfikowane przez potok to inna historia. Nasza preferencja jest tu radykalna: pozbaw je w ogóle cech hybrydowych. Wczytaj dokument przez HotPDF i zapisz go w całości, a wyjście dostanie jedną, wewnętrznie spójną strukturę odsyłaczy w jednej postaci. Żadnego /XRefStm, żadnego drugiego widoku, który mógłby się rozjechać, każdy obiekt ma dokładnie jeden wpis indeksu. Taka normalizacja jest tym, czego chcesz przed przyjmowaniem do archiwum, przed restrykcyjnym RIP-em albo usługą podpisującą dalej w potoku i po każdej edycji zadanej hybrydowemu wejściu. Opiera się w całości na opisanym wcześniej scalaniu ze strumieniem najpierw, bo pełny zapis może wypisać tylko obiekty, które wczytanie zdołało zlokalizować
Dokumenty podpisane są wyjątkiem. Pełne przepisanie przesuwa każdy bajt, co unieważnia każdy podpis liczony po oryginalnych zakresach bajtów. Zmiana w podpisanym pliku hybrydowym musi wejść jako porządna aktualizacja przyrostowa, która utrzymuje oba widoki w zgodzie, a podpisany plik, który ma być tylko wczytany, powinien przejść przez potok nietknięty
Strona pisarza tej historii, czyli jak w ogóle powstają strumienie obiektów i skompresowane odsyłacze, jest opisana w naszym artykule o strumieniach obiektów i aktualizacjach przyrostowych. Gdy dany plik hybrydowy jest również bardzo duży, techniki wczytywania z przewodnika po Direct File API dla dużych przepływów pracy z PDF pozwalają go zbadać bez wczytywania całości do pamięci. Oba naturalnie łączą się z odzyskiwaniem opisanym tutaj, które jest częścią HotPDF Delphi Component dla Delphi i C++Builder, obok API do wczytywania, edycji, szyfrowania i podpisywania omówionych w innych miejscach na tym blogu