Pierwszy obiekt zlinearyzowanego PDF musi podać dokładną długość pliku, w którym siedzi, co do bajta, i musi wystąpić w pierwszych 1024 bajtach. Aneks F ISO 32000-1 nazywa ten wpis /L, a czytnik, który znajdzie go w sprzeczności z realnym rozmiarem pliku, dostaje rozkaz traktowania dokumentu jako zwykłego PDF-a i ignorowania wszystkich podpowiedzi linearyzacji w środku. Writer musi więc wydrukować długość pliku, którego jeszcze nie skończył pisać, obok offsetu strumienia podpowiedzi, końca pierwszej strony i pozycji tabeli odwołań krzyżowych blisko końca pliku. Wszystkie cztery liczby się ruszają, kiedy cokolwiek przed nimi zmienia rozmiar
Payoffem jest Fast Web View. Zwykły PDF trzyma tabelę odwołań krzyżowych na końcu, więc przeglądarce, której podano 200-stronicowy skanowany raport, nie uda się zlokalizować strony 1, dopóki nie przyjedzie ostatni bajt; zlinearyzowany plik przenosi stronę 1 i małą sekcję odwołań krzyżowych na przód, więc klient używający żądań zakresowych HTTP maluje pierwszą stronę wcześnie. Dalej jest strona zapisu. Obraz od strony czytania jest w objaśnieniu linearyzacji PDF i Fast Web View
Jak HotPDF układa zlinearyzowany plik
HotPDF zapisuje wyjście zlinearyzowane, gdy THotPDF.LinearizeOutput ma True, a plik podąża za fizycznym porządkiem, który przepisuje aneks F, część po części. Po nagłówku idzie słownik parametrów linearyzacji, potem sekcja odwołań krzyżowych pierwszej strony z jej trailerem, katalog z pozostałymi obiektami poziomu dokumentu, główny strumień podpowiedzi, pierwsza strona z każdym obiektem, którego potrzebuje, pozostałe strony po kolei, obiekty współdzielone między późniejszymi stronami, wszystko inne i na końcu główna tabela odwołań krzyżowych
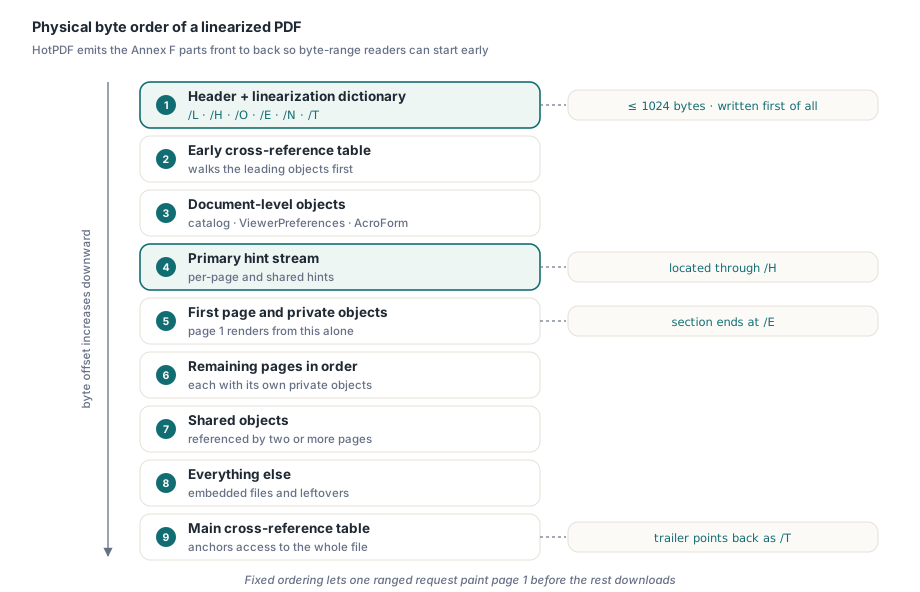
Nic w modelu dokumentu nie mówi, do której części należy obiekt. Writer wylicza to z grafu odwołań, gdy EndDoc zapisuje, chodząc od każdego obiektu strony i licząc, ile stron sięga do każdego obiektu pośredniego. Obiekt osiągany z jednej strony wpada do sekcji tej strony. Obiekt osiągany z kilku stron jest współdzielony, z jednym zakrętem, który szybka lektura specyfikacji gubi: gdy strona 1 jest wśród stron go używających, obiekt i tak wpada do sekcji pierwszej strony, bo strona 1 musi renderować się z samych wiodących bajtów. Tylko obiekty współdzielone czysto między późniejszymi stronami czekają w części współdzielonej. Katalog — cokolwiek wskazują jego wpisy /ViewerPreferences, /OpenAction, /Threads i /AcroForm — i słownik szyfrowania chronionego dokumentu składają się na grupę poziomu dokumentu. Węzły drzewa stron są wpychane do części ogonowej, żeby nigdy nie napychały pierwszej strony
Otwórz wyjście w edytorze heksowym, a numeracja wygląda od tyłu. Przedni blok, od słownika linearyzacji po strumień podpowiedzi, niesie najwyższe numery obiektów w pliku, a wszystko po nim jest numerowane od 1. Mała sekcja odwołań krzyżowych na przodzie pokrywa dokładnie ten wysoki blok, a główna tabela pokrywa od 1 do N
Pułapka inicjalizacji rekordów na listach podziału
Listy takie jak ta naturalnie zapisuje się jako rekord trzymający tablicę dynamiczną plus osobny licznik, i ten kształt chowa pułapkę Delphi. Kompilator inicjalizuje zarządzane pola lokalnego rekordu. Gołe Integer siedzące obok nie dostaje nic. Pod Win32 slot stosu często z przypadku trzyma zero, więc pierwszy append ląduje na indeksie 0 i każdy test przechodzi; pod Win64 slot może trzymać resztki, a pierwszy append pisze pod przypadkowy indeks
type
  TPartList = record
    Values: TArray<Integer>;  // zarządzane: czyszczone przez kompilator
    Count: Integer;           // niezarządzane: cokolwiek trzymał stos
  end;

procedure Append(var List: TPartList; Value: Integer);
begin
  if List.Count = Length(List.Values) then
    SetLength(List.Values, List.Count * 2 + 16);
  List.Values[List.Count] := Value;
  Inc(List.Count);
end;

procedure BuildParts;
var
  FirstPage, Shared: TPartList;
begin
  FirstPage := Default(TPartList);   // wymagane, nie kosmetyka
  Shared := Default(TPartList);
  Append(FirstPage, 12);
  Append(Shared, 40);
end;
Writer HotPDF przypisuje Default każdej liście podziału przed pierwszym dotknięciem. Zielony przebieg na Win32 nie mówi nic o tym, czy taki rekord został zainicjalizowany
Dlaczego układ musi zbiec, zanim spłynie pierwszy bajt?
Bo przód pliku trzyma offsety wskazujące ku tyłowi, a liczba cyfr w tych offsetach przesuwa wszystko za nimi. Trailer pierwszej strony niesie wpis /Prev z bajtowym offsetem głównej tabeli odwołań krzyżowych. Zapisz ten offset jako 99998, potem odkryj, że tabela naprawdę ląduje na 100003, i trailer rośnie o jedną cyfrę. Sekcja odwołań krzyżowych pierwszej strony rośnie z nim, każdy obiekt za nią przesuwa się o bajt, a główna tabela siedzi teraz na 100004. Pojedynczy przebieg trafia to tylko z przypadku
HotPDF zrywa cykl dwoma ruchami. Słownik parametrów wpada do stałego slotu 384 bajty wyściełanego spacjami, więc /L, /H, /E i /T mogą brać dowolnie dużo cyfr, nie ruszając ani jednego obiektu; gdyby tekst słownika potrzebował kiedyś ponad 384 bajty, zapis podniósłby wyjątek zamiast przesuwać plik. Zostaje /Prev jako jedyna wolna zmienna, i przechodzi przez pętlę punktu stałego. Każdy obiekt jest najpierw serializowany do strumienia liczącego, który notuje długości i nie trzyma bajtów. Przebieg układu przydziela potem offsety sekcja po sekcji i zgłasza, gdzie wyląduje główna tabela, a ta odpowiedź staje się wejściem następnego przebiegu. Pętla stopuje, gdy proponowany offset przestaje się ruszać, i poddaje się wyjątkiem po ośmiu próbach
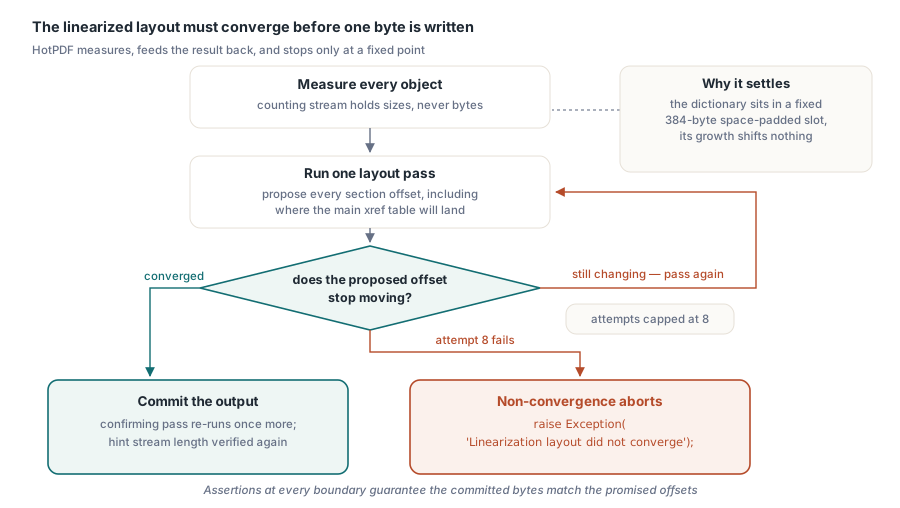
Rusza tylko zmiana liczby cyfr, więc trzeci przebieg jest potrzebny tylko blisko granicy potęgi dziesięciu, jak w przypadku 99998. Po zbieżności writer robi jeden potwierdzający przebieg, przebudowuje strumień podpowiedzi z prawdziwymi offsetami i sprawdza, że jego długość się nie zmieniła; offsety siedzą w polach o stałej szerokości, więc wersja zastępcza i finalna muszą się zgadzać. Potem wyjście leci prosto do strumienia docelowego bez buforowanej drugiej kopii, a przy każdej granicy sekcji zapisane bajty są porównywane z obiecanym offsetem. Niedopasowanie podnosi wyjątek z EndDoc
Tabele podpowiedzi i miejsca, gdzie aneks F czyta się dwojako
Główny strumień podpowiedzi niesie dwie tabele. Tabela podpowiedzi offsetów stron notuje dla każdej strony, ile obiektów trzyma jej sekcja, jak długo jest ta sekcja w bajtach i od których obiektów współdzielonych zależy. Tabela podpowiedzi obiektów współdzielonych wypisuje długość każdej grupy obiektów współdzielonych. Mając obie, czytnik może zażądać strony 37 bezpośrednio, a wpis /S strumienia podaje pozycję wewnątrz strumienia, gdzie startuje tabela współdzielona
Dwa szczegóły w aneksie F.4 łatwo zepsuć. Pierwszy: offsety trzymane w tabelach podpowiedzi to offsety logiczne, liczone tak, jakby główny strumień podpowiedzi nie istniał. Obiekt pierwszej strony i pierwszy obiekt współdzielony siedzą fizycznie za strumieniem podpowiedzi, więc writer odejmuje długość obiektu podpowiedzi przed zapisaniem ich offsetów. Writer zapisujący offsety fizyczne ląduje każdym powstałym żądaniem zakresowym dokładnie o rozmiar obiektu podpowiedzi za daleko
Drugi to prawdziwa niejednoznaczność. Tekst F.4 opisuje każdą tabelę jako jeden ciągły strumień bitów, najpierw bit najbardziej znaczący, i wypisuje grupy współdzielone pierwszej strony oraz późniejsze grupy współdzielone jako dwie osobne sekwencje. Strumienie podpowiedzi w obiegu padują każdą kolumnę do granicy bajtu i traktują grupy współdzielone jako jedną połączoną listę — i ta forma jest znana jako przyjmowana przez czytniki konsumujące podpowiedzi. HotPDF zapisuje układ wyrównany do bajtu i połączony. To właściwa strona do wybrania: tabela spełniająca literę F.4, ale rozjechana dla klientów ją czytających, zawodzi dokładnie tam, gdzie linearyzacja miała się opłacać, a pobranie całego pliku nigdy problemu nie odsłoni
Włączanie zlinearyzowanego wyjścia z Delphi
Po stronie API przełącznik to jeden Boolean. LinearizeOutput domyślnie ma False, a writer zagląda do niego, gdy EndDoc serializuje dokument, więc ustaw go razem z pozostałymi opcjami wyjścia przed BeginDoc i zostaw w spokoju. Każda z opisanych wyżej porażek — brak zbieżności, przesadzony słownik parametrów, niedopasowanie na granicy, limit 4 GiB omówiony niżej — wychodzi jako wyjątek z EndDoc, co czyni fallback bezpośrednim
procedure WriteReport(const FileName: string; Linearize: Boolean);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    PDF.FileName := FileName;
    PDF.Version := pdf17;
    PDF.LinearizeOutput := Linearize;   // ustaw przed BeginDoc
    PDF.BeginDoc;                       // tworzy stronę 1
    PDF.CurrentPage.TextOut(72, 72, 0, 'Quarterly summary');
    PDF.AddPage;
    PDF.CurrentPage.TextOut(72, 72, 0, 'Details');
    PDF.EndDoc;                         // układ i zapis dzieją się tutaj
  finally
    PDF.Free;
  end;
end;

procedure PublishReport(const FileName: string);
begin
  try
    WriteReport(FileName, True);
  except
    on E: Exception do
    begin
      LogWarning('Linearization failed: ' + E.Message);  // twój własny logger
      WriteReport(FileName, False);                       // zamiast tego zwykły PDF
    end;
  end;
end;
Fallback produkuje zwykły PDF, który otworzy każda przeglądarka; traci tylko szybką pierwszą stronę. Dla pipeline'u raportów to łatwy handel, bo wolny pierwszy malunek to irytacja, a brakujący raport to incydent
Strona wdrożenia przewyższa stronę kodu. Linearyzacja opłaca się tylko, gdy serwer honoruje żądania HTTP Range; endpoint strumieniujący plik w całości kupuje ci wolniejszy zapis i większy plik bez niczego w zamian. Zostaw LinearizeOutput wyłączone dla plików, które idą mailem, załącznikiem albo do pobrania, zanim ktokolwiek je zobaczy. Włącz je dla dokumentów otwieranych przez przeglądarkę prosto z URL-a — po potwierdzeniu, że odpowiedź niesie Accept-Ranges: bytes
Dlaczego LinearizeOutput wyłącza strumienie obiektów?
Bo każdy wpis tabeli podpowiedzi opisuje zakres bajtów, a obiekt spakowany do kontenera /ObjStm nie ma własnego zakresu bajtów; istnieje tylko jako plasterek innego skompresowanego strumienia, który trzeba pobrać i rozpompować w całości. Przy włączonym LinearizeOutput HotPDF zapisuje tradycyjne tekstowe tabele odwołań krzyżowych i rozpakowane obiekty pośrednie, nawet gdy ustawione jest też UseXRefStream albo UseObjectStreams. Ścieżka zlinearyzowana bierze górę w chwili zapisu, więc twój kod nie ma konfliktu do rozwiązywania
Ceną jest rozmiar pliku, bo małe słowniki, które strumień obiektów scisnąłby razem, teraz zostają luźne. Jeśli kompaktowe wyjście znaczy dla ciebie więcej niż opóźnienie pierwszej strony, kompromis jest rozpisany w strumieniach obiektów i aktualizacjach przyrostowych w HotPDF. Eksporterzy Office spotykają to samo napięcie z drugiej strony — dlatego niektórzy z nich emitują układ opisany w hybrydowych strumieniach odwołań krzyżowych w PDF-ach z Office
Linearyzacja potrzebuje też PDF 1.2 albo nowszego. Przy niższej Version HotPDF awansuje dokument do 1.2 przy zapisie. Przy ustawionym StrictVersionLock podnosi zamiast tego wyjątek, bo wersja przypięta celowo nie powinna zmieniać się za twoimi plecami
Sufit 4 GiB na wyjściu zlinearyzowanym
Tabele podpowiedzi trzymają offsety i długości w polach 32-bit, więc zlinearyzowany plik nie adresuje niczego poza 4 GiB, a HotPDF odmawia produkcji takiego pliku zamiast zapisywać offsety, które zawiną się dookoła. Sufit bierze się z szerokości pól zdefiniowanych w aneksie F
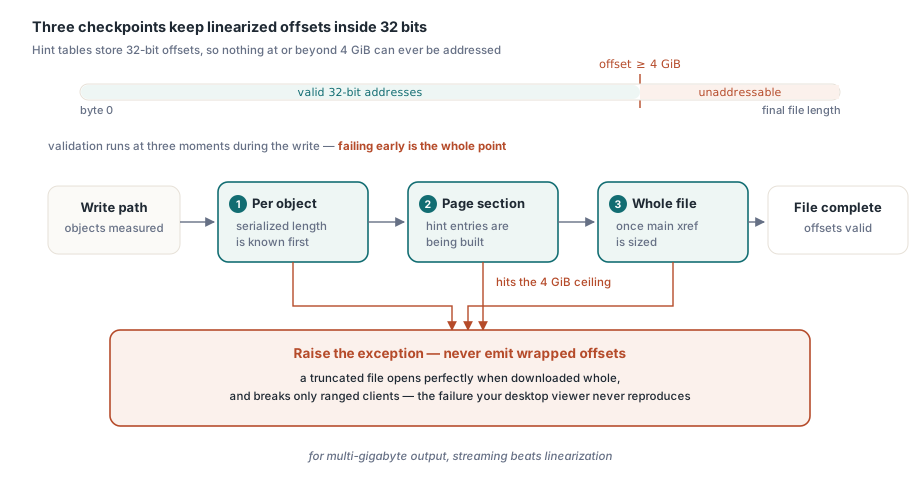
Kontrola biegnie w trzech punktach, wszystkie przed tym, zanim pierwszy bajt dotrze do celu: na każdym obiekcie, gdy jego zserializowana długość jest już znana, na długości każdej sekcji strony podczas budowania wpisów podpowiedzi i na finalnej długości pliku, gdy główna tabela odwołań krzyżowych została już zwymiarowana. Zawinięte offsety byłyby najgorszym sposobem porażki: przeglądarka pobierająca cały plik może zignorować podpowiedzi, podczas gdy klient zakresowy skacze do złych bajtów, więc testowanie desktopowe nigdy nie odtworzy usterki. Dla wyjścia wielogigabajtowego szukaj ścieżki strumieniowania w Direct File API dla dużych workflow PDF
Sprawdzanie, czy przychodzący plik jest zlinearyzowany
THotPDF.IsLoadedLinearized zgłasza, czy wczytany dokument deklaruje się jako zlinearyzowany. Sprawdzenie dzieje się przed parsowaniem: HotPDF czyta do 1024 bajtów od pozycji zero źródła, znajduje pierwszy obiekt i zagląda wewnątrz niego za /Linearized z wartością 1. Komentarze, literały łańcuchowe i łańcuchy hex są pomijane, więc nazwa pojawiająca się wewnątrz łańcucha się nie liczy, a skan stopuje na stream albo endobj. Przyjmowane jest wyłącznie 1 albo odpowiednik jak 1.0
Odpowiedź jest cache'owana w chwili wczytania, bo gdy kod aplikacji pyta, parser zdążył przenieść pozycję strumienia, a LoadFromFile już zwolnił swój strumień źródłowy
Flaga zgłasza to, co plik twierdzi. Aneks F dodaje drugi warunek: /L musi pasować do faktycznej długości pliku, a aktualizacja przyrostowa dopisana po linearyzacji zrywa to dopasowanie, więc czytniki wracają do traktowania pliku jako zwykłego. Pipeline przyjmujący pliki od edytorów dopisujących swoje zapisy może porównać obie liczby samodzielnie
// Twój własny pomocnik, nie część HotPDF: porównuje /L z realnym rozmiarem
// Uproszczony parse; zakłada pojedynczą spację po /L
function DeclaredLengthMatches(const FileName: string): Boolean;
var
  FS: TFileStream;
  Head: AnsiString;
  ActualSize: Int64;
  P, Q: Integer;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    ActualSize := FS.Size;
    SetLength(Head, 1024);
    SetLength(Head, FS.Read(Head[1], 1024));
  finally
    FS.Free;
  end;
  P := Pos(AnsiString('/L '), Head);
  Result := P > 0;
  if not Result then
    Exit;
  Inc(P, 3);
  Q := P;
  while (Q <= Length(Head)) and (Head[Q] in ['0'..'9']) do
    Inc(Q);
  Result := StrToInt64Def(string(Copy(Head, P, Q - P)), -1) = ActualSize;
end;

procedure InspectUpload(const FileName: string);
var
  PDF: THotPDF;
begin
  PDF := THotPDF.Create(nil);
  try
    if PDF.LoadFromFile(FileName) <= 0 then
      Exit;
    if not PDF.IsLoadedLinearized then
      Writeln('Not linearized')
    else if not DeclaredLengthMatches(FileName) then
      Writeln('Linearized, but modified after linearization')
    else
      Writeln('Ready for Fast Web View');
  finally
    PDF.Free;
  end;
end;
LinearizeOutput i IsLoadedLinearized są częścią HotPDF Delphi Component dla Delphi i C++Builder, a jego strona produktu dokumentuje, jak współgrają ze strumieniami odwołań krzyżowych, strumieniami obiektów i blokadą wersji