"value":-.25 to to, co produkuje writer JSON, gdy kopiuje całkowicie legalny token liczby PDF jak leci, a ścisły parser RFC 8259 poddaje się w punkcie tuż za znakiem minus. Jego sąsiedzi +1.5 i 007.5 z tej samej tablicy PDF zawodzą tak samo. Zamiana liczb PDF na JSON znaczy przeliterowanie każdego tokena cyfra po cyfrze, zapisanie null dla NaN i Infinity oraz trzymanie regionalnego przecinka dziesiętnego poza wyjściem
Cztery zapisy, które PDF przyjmuje, a JSON odrzuca
Te dwie gramatyki różnią się w czterech drobnych szczegółach. ISO 32000-1 §7.3.3 pozwala liczbie zaczynać się od znaku plus, pomijać część całkowitą (.5), kończyć się gołą kropką (4.) i nieść wiodące zera (007.5). RFC 8259 §6 nie pozwala na nic z tego. Liczba JSON ma opcjonalny minus, część całkowitą będącą 0 albo zaczynającą się cyfrą od 1 do 9, i co najmniej jedną cyfrę po każdej kropce dziesiętnej. Producenci mają prawo do postaci PDF, i generatory wypisujące liczby własnym kodem formatowania, razem z plikami poprawianymi ręcznie w edytorze tekstu, z nich korzystają
Kolizja ostrzeje się w bibliotece, która szanuje tekst źródłowy. PDF Library for Delphi (PDFlibPas) trzyma dokładne znaki, które sparsowała, dla każdej liczby rzeczywistej, więc skalibrowana wartość koloru zapisuje się z powrotem niezmieniona zamiast być zaokrąglana do domyślnych czterech miejsc; rozumowanie jest w zachowywaniu sparsowanej precyzji dziesiętnej PDF. Tokenizer już łata .5 w 0.5 i 4. w 4.0 podczas czytania, a liczby całkowite są przebudowywane z ich wartości, więc +3 wraca jako 3. Trzy zapisy docierają do writera dosłownie: kropka wiodąca ze znakiem (-.25), jawny plus przy rzeczywistej (+1.5) i wiodące zera (007.5)
Writer, który wkleja te zapisane znaki prosto do JSON, produkuje plik wyglądający dobrze w edytorze. Kłopoty startują w drodze z powrotem. SetObjectJSON zwraca 0, a LastErrorCode zgłasza PDFLIB_ERROR_OBJECT_JSON_INVALID, czyli 105
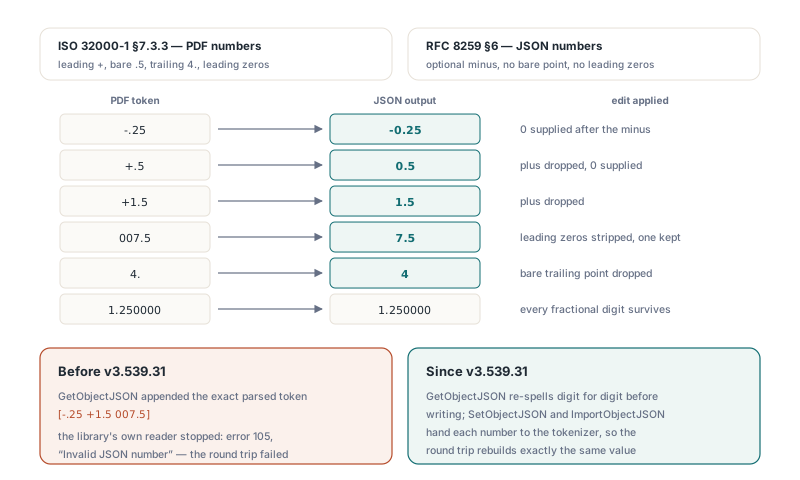
Podróż w obie strony niżej to najszybszy sposób, by zobaczyć, co GetObjectJSON faktycznie emituje. Każda liczba przychodzi opakowana jako {"type":"number","value":...}, a trzy niewygodne tokeny wychodzą jako -0.25, 1.5 i 7.5
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  JSON: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('legacy-drawing.pdf', '') = 0 then
      raise Exception.Create('load failed');

    // Obiekt 12 to tablica zapisana jako [-.25 +1.5 007.5]
    JSON := Lib.GetObjectJSON(12, 0);
    if JSON = '' then
      raise Exception.CreateFmt('export failed, error %d',
        [Lib.LastErrorCode]);
    // Każdy element czyta {"type":"number","value":-0.25} i tak dalej

    // SetObjectJSON zwraca 1 przy sukcesie; podaj 0 dla Options
    if Lib.SetObjectJSON(12, JSON, 0) = 0 then
      raise Exception.CreateFmt('round trip rejected, error %d',
        [Lib.LastErrorCode]);

    Lib.SaveToFile('legacy-drawing-roundtrip.pdf');
  finally
    Lib.Free;
  end;
end;
Przeliterowanie tokenu zamiast przeliczania go
GetObjectJSON edytuje zapisane znaki zamiast formatować sparsowane Double. Czyta opcjonalny znak, zbiera cyfry po obu stronach pojedynczej kropki dziesiętnej, a potem robi tylko zmiany, na których JSON nalega: plus znika, wiodące zera są ścinane do jednego, pusta część całkowita staje się 0, goła końcowa kropka jest zrzucana, a minus wraca z przodu. Token zawierający jakikolwiek inny znak albo żadnych cyfr jest formatowany ze swojej sparsowanej wartości z dziesięcioma miejscami, i ta ścieżka pisze null, gdy wartość nie jest skończona
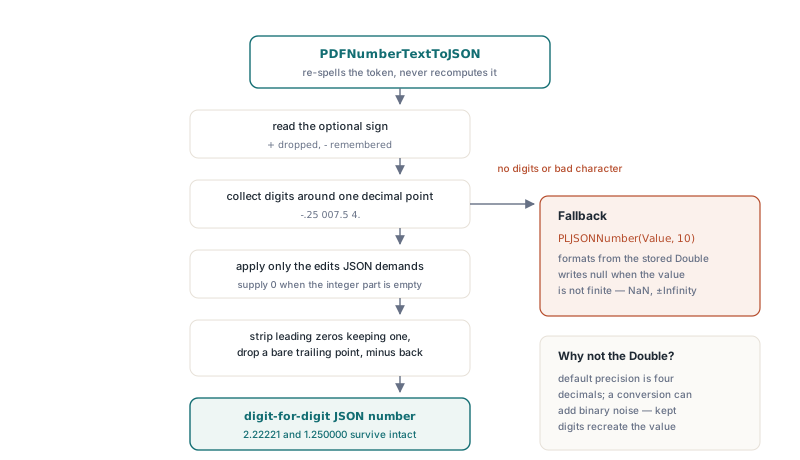
-.25staje się-0.25, a+.5staje się0.5+1.5staje się1.5007.5staje się7.5, a0.75zostaje takie, jakie jest4.staje się4, gdyby taki token kiedykolwiek dotarł do writera2.22221i1.250000zachowują każdą cyfrę ułamkową, łącznie z końcowymi zerami
Formatowanie z Double byłoby jednolinijkowcem i byłoby złe na dwa sposoby. Domyślna precyzja wyjścia dokumentu to cztery miejsca, więc 2.22221 straciłoby cyfrę. Podniesienie precyzji też tego nie ratuje: 0.1 nie ma dokładnej postaci binarnej, a konwersja z 17 cyframi znaczącymi wypisuje 0.10000000000000001. Trzymanie oryginalnych cyfr znaczy, że SetObjectJSON i ImportObjectJSON, które oddają każdą liczbę JSON z powrotem tokenizerowi PDF, przebudowują dokładnie wartość, którą plik zadeklarował
Ta obietnica pokrywa wartość. Bajty to inna sprawa. Po ponownym imporcie -.25 jest przechowywane i zapisywane jako -0.25; oba zapisy są równe w świetle §7.3.3, a jednak diff na poziomie bajtów flaguje zmianę. Na dokumencie, którego zakresy bajtów pokrywa podpis, nie puszczalibyśmy obiektów przez cykl eksportu i importu wcale, chyba że planem jest ponowne podpisanie później
Co znaczy null w wyjściu GetDocumentJSON?
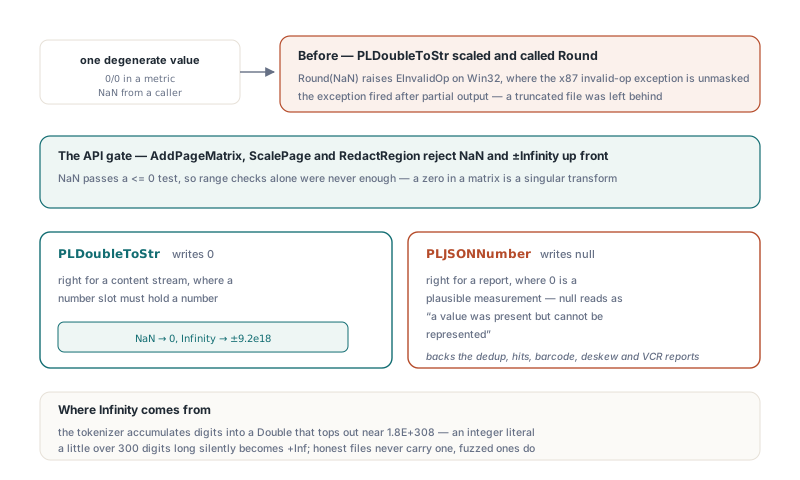
GetDocumentJSON pisze null dla każdej liczby, która jest NaN albo nieskończona, bo RFC 8259 §6 nie ma składni ani na jedno, ani na drugie. Nieskończoność jest łatwiejsza do wyprodukowania, niż brzmi. Tokenizer PDF akumuluje cyfry powtarzanym mnożeniem do Double, który dobija sufitu koło 1.8 × 10308, więc literał całkowity trochę ponad 300 cyfr długości staje się +Inf podczas parsowania. Zwyczajni producenci nigdy takiego literału nie zapiszą; pliki fuzzowane i wrogie tak, dlatego 400-cyfrowa liczba całkowita należy do tego samego korpusu testowego co przypadki z hartowania parsera PDF w Pascalu przeciw złośliwym plikom
Sprawdzenie skończoności musi przyjść najpierw. GetDocumentJSON wypisuje wartości całkowite poniżej MaxInt jako liczby całkowite, a wszystko inne paskalowym Str(D:0:6), co jest w porządku dla 1.25 i śmiertelne dla +Inf, bo Str pisze wtedy tekst +Inf, a żaden konsument JSON tego nie sparsuje. Formatowanie sześciomiejscowe zaznacza też, po co jest JSON dokumentu. To przegląd całego pliku. Gdy potrzebujesz dokładnych cyfr jednego obiektu, proś GetObjectJSON o ten obiekt
null jest z premedytacją stratne i dzieli swoją pisownię z czymś innym. Obiekt null PDF również wychodzi jako null w JSON dokumentu, więc konsument nie odróżni "plik powiedział null" od "plik powiedział liczbę za dużą dla Double" patrząc na tę jedną wartość. GetObjectJSON trzyma je rozdzielone: obiekt null PDF jest zapisywany jako {"type":"null"}, a liczba zachowuje swoje opakowanie "type":"number". Kod czytający JSON dokumentu powinien akceptować null wszędzie tam, gdzie może pojawić się liczba, logować numer obiektu i traktować plik jako podejrzany, zamiast podstawiać 0
Dlaczego pojedyncze NaN może przerwać eksport SVG albo JSON?
Formatter liczb, który skaluje swoje wejście i woła Round, trafia na Round(NaN), a na Win32, gdzie Delphi zostawia wyjątek niepoprawnej operacji x87 odmaskowany, to podnosi EInvalidOp. Wyjątek strzela po tym, jak writer zdążył już wyemitować część swojego wyjścia. Jedna zdegenerowana miara — 0/0 wewnątrz metryki albo NaN podany przez wołającego — zostawia ucięty plik na dysku
PLDoubleToStr w PDFlibExtra, niezmienny formatter, którego biblioteka używa dla strumieni treści, SVG, XML, CSV i większości swojego JSON, zwraca 0 dla NaN. Jego gałąź całkowita przycina przeskalowaną wartość do ±9.2 × 10¹⁸ tak jak gałąź ułamkowa, więc Infinity również wychodzi jako skończony literał. W strumieniu treści to właściwy ruch. Slot operandu musi trzymać liczbę, a przeglądarka, która spotyka +Inf w środku ścieżki, nie ma sensownego niczego do narysowania
W raporcie zero to zły ruch i mamy do tego mocny stosunek: 0 to zupełnie wiarygodny kąt deskew albo błąd pikselowy, więc zapisanie go za "brak odpowiedzi" psuje dane niezauważone przez nikogo. Writery raportów używają zamiast tego PLJSONNumber(Value, Decimals) z tej samej jednostki, które pisze null dla NaN albo Infinity i niezależne od locale cyfry inaczej. GetSimilarImageDeduplicationReportJSON, GetAnnotationHitsJSON oraz raporty barcode, deskew, structured text i PDF/VCR przechodzą przez nie wszystkie, więc nieskończony kąt deskew dociera do konsumenta jako null
Ta sama funkcja jest publiczna, więc twój własny JSON obok JSON-a biblioteki może podążać za tą samą regułą. Szkic niżej buduje mały rekord skosu; kształt rekordu jest nasz, wywołanie formatowania jest biblioteki
uses
  SysUtils, PDFlibTypes, PDFlibExtra;

// Twój własny writer raportów, z regułą liczb biblioteki
function SkewReportJSON(Page: Integer; Angle, Confidence: Double): string;
var
  B: PLStringBuilder;
begin
  B := PLStringBuilder.Create(128);
  try
    // Najpierw zamień każde Double na tekst; PLJSONNumber pisze null
    // dla NaN albo Infinity i zawsze używa kropki dziesiętnej
    B.Append('{"page":').Append(Page)
     .Append(',"angle":').Append(string(PLJSONNumber(Angle, 4)))
     .Append(',"confidence":').Append(string(PLJSONNumber(Confidence, 4)))
     .Append('}');
    // Nigdy B.Append(Angle): na Delphi to przeciążenie podąża za locale użytkownika
    Result := B.ToString;
  finally
    B.Free;
  end;
end;
Gdzie locale użytkownika przemyca się do JSON
Każdy formatter zaglądający do ustawień regionalnych potrafi wstawić przecinek tam, gdzie JSON potrzebuje kropki. PLFloatToStr w PDFlibExtra to cienki wrapper nad FloatToStr, i dokładnie to robi. Napisz pole takie jak maxAcceptedMeanError nim na niemieckim albo francuskim pulpicie, a dostaniesz "maxAcceptedMeanError":1,5. Parser JSON czyta to jako wartość 1, po której idzie zbłąkany token. To pole raportuje najgorszy zaakceptowany błąd pikselowy z percepcyjnej deduplikacji obrazów, a GetSimilarImageDeduplicationReportJSON zapisuje je przez PLJSONNumber(Stats.MaxAcceptedMeanError, 6), więc separator zostaje kropką, cokolwiek maszyna ma ustawione
Druga droga jest cichsza. Na Delphi PLStringBuilder to goły alias System.SysUtils.TStringBuilder, którego przeciążenie Append(Double) formatuje przez locale użytkownika. Buildy Free Pascal używają zamiast tego małej klasy budującej Unicode z PDFlibTypes, bo własny TStringBuilder runtime'u FPC jest tylko-ANSI. Skompiluj to samo źródło oboma i build Delphi może się różnić z buildem FPC. Test biegnący tylko na Free Pascalu albo tylko na maszynie en-US nie zobaczy przecinka
Test niżej odtwarza pulpit z przecinkiem wewnątrz procesu i podaje raport ścisłemu parserowi. Wybierz wejście, które naprawdę zawiera niemal-duplikaty obrazów; bez trafień średni błąd wynosi 0, a wartość bez części ułamkowej chowa problem separatora
uses
  System.SysUtils, System.JSON, PDFlibrary;

var
  Lib: TPDFlib;
  Report: WideString;
  Parsed: TJSONValue;
begin
  // Każ ten proces zachowywać się jak niemiecki albo francuski pulpit
  FormatSettings.DecimalSeparator := ',';
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('scanned-batch.pdf', '') = 0 then
      raise Exception.Create('load failed');
    // Próba na sucho z progami 2, 2, 4: dokument nie jest modyfikowany
    Lib.GetSimilarImageDeduplicationReportJSON(2, 2, 4, Report);
    Parsed := TJSONObject.ParseJSONValue(Report);
    // To sprawdzenie nil dodajesz sam, nie jest częścią biblioteki
    if Parsed = nil then
      raise Exception.Create('report is not valid JSON on a comma locale');
    Parsed.Free;
  finally
    Lib.Free;
  end;
end;
Trzy wejścia warte trzymania w zestawie testów
Obsługa liczb w JSON jest tania do zepsucia i tania do pilnowania. Jedna strona niosąca -.25, +1.5 i 007.5 pokrywa lukę gramatyczną; sprawdź, że wyjście GetObjectJSON się parsuje i że SetObjectJSON zwraca 1. Jeden obiekt trzymający 400-cyfrową liczbę całkowitą pokrywa przepełnienie; JSON dokumentu powinien pokazać null na tej pozycji. Jeden raport wyprodukowany z DecimalSeparator ustawionym na przecinek pokrywa locale. Puszczaj każdy przez ścisły parser zamiast czytać wyjście okiem, bo 1,5 i 1.5 łatwo przeoczyć w długiej linii JSON
JSON obiektów, JSON dokumentów i raporty analityczne dzielą te reguły liczb między buildami Delphi, C++Builder i Free Pascal. Strona produktu PDF Library for Delphi wylicza edycje i resztę API na poziomie obiektów oraz raportowania