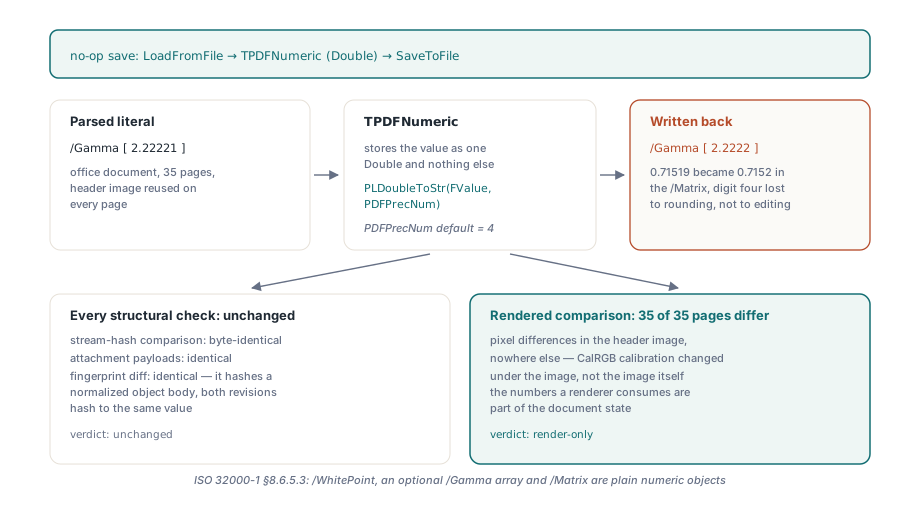
Wczytaj skalibrowany PDF, nie zmień niczego, zapisz pod nową nazwą i porównaj słowniki przestrzeni kolorów: weszło /Gamma [2.22221 2.22221 2.22221], wyszło /Gamma [2.2222 2.2222 2.2222]. Writer przeformatował liczbę, której nigdy nie musiał ruszać, i strona renderuje się teraz w lekko innych kolorach. Leczenie to traktowanie każdej sparsowanej liczby dziesiętnej jako dwóch rzeczy naraz: wartości do arytmetyki i literału do wyjścia — i wypuszczanie literału dalej, dopóki ktoś faktycznie nie przypisze nowej wartości
Dlaczego zapis bez zmian potrafi przesunąć kolory CalRGB
Piksele się przesuwają, bo renderer dostaje lekko inne dane kalibracji, podczas gdy bajty obrazu zostają identyczne. ISO 32000-1 §8.6.5.3 definiuje przestrzeń kolorów CalRGB przez wymagane /WhitePoint, opcjonalną trzyelementową tablicę /Gamma i opcjonalną dziewięcioelementową /Matrix, a wszystko to są zwykłe obiekty numeryczne w słowniku przestrzeni kolorów. Przepuść je przez Double i formatter przybity do czterech miejsc po przecinku, a 2.22221 stanie się 2.2222, a wpis macierzy 0.71519 stanie się 0.7152. Wartość gamma to wykładnik stosowany do każdej składowej każdego piksela przechodzącego przez tę przestrzeń, więc zmiana wychodzi wszędzie tam, gdzie przestrzeń jest używana
Dla pliku, który deklaruje jedną przestrzeń CalRGB dla obrazu nagłówka używanego na 35 stronach, wszystkie 35 nagłówków renderuje się z przesuniętymi kolorami i nic więcej na tych stronach się nie zmienia. Sprawdziany, po które ludzie sięgają pierwsi, wychodzą czyste. Hash zdekodowanych bajtów strumieni porównuje dane obrazu, a dane obrazu naprawdę są identyczne; szkody siedzą w słowniku. Diff rewizji opisany w artykule o poziomach modyfikacji bierze odcisk znormalizowanego ciała obiektu, więc obie rewizje haszują się tam do tej samej wartości. Złapie go dopiero porównanie wyrenderowanych stron. Dla każdego potoku, który przepisuje PDFy wyprodukowane przez inne oprogramowanie, postawilibyśmy porównanie renderów per strona przed każdym sprawdzeniem strukturalnym
Jak może wyglądać liczba rzeczywista w PDF
ISO 32000-1 §7.3.3 definiuje liczbę rzeczywistą jako łańcuch dziesiętny: opcjonalny znak, cyfry, kropka, dalej cyfry. Żadnej notacji podstawowej. Żadnej postaci wykładniczej. Annex C, który wylicza limity implementacji, oczekuje, że w części ułamkowej uszanowanych zostanie około pięć znaczących cyfr dziesiętnych. Domyślna precyzja wyjściowa czterech miejsc siedzi więc już cyfrę poniżej tego, co specyfikacja każe czytnikom zachować, a plik niczego złego nie zrobił, używając pięciu
Blisko zera naiwny formatter robi się gorszy niż traci cyfrę. Zwykły sposób wypisania Double na N miejsc to pomnożyć przez 10^N, zaokrąglić do liczby całkowitej i wypisać cyfry — a gdy ta liczba całkowita jest zerem, wyjście to 0. Daj mu pierwszy operand 0.00001 0 0 1 0 0 cm na czterech miejscach, a wynik to 0 0 0 1 0 0 cm, macierz osobliwa, która sprawia, że wszystko rysowane pod nią znika. Wpis /Matrix o wartości -0.000012345 idzie tą samą drogą
Gdy PDF Library for Delphi (PDFlibPas) musi sama sformatować Double, zachowuje żądaną liczbę znaczących cyfr dla wartości niezerowej mniejszej od kroku precyzji, zamiast pisać 0. Na czterech miejscach 0.00001 wychodzi jako 0.00001 i 0.0000123 jako 0.0000123; dopiero wielkości poniżej około 5E-16 wychodzą jako 0. Dzięki temu nowo pisane liczby mają sens. Sparsowana liczba, która nigdy nie potrzebowała przeformatowania, to inna sprawa — i biblioteka załatwia ją tym, że w ogóle jej nie przeformatowuje
Jak PDFlibPas zachowuje literał, który sparsował
TPDFStructure.Decode zachowuje tekst źródłowy każdej standardowej liczby rzeczywistej, którą tokenizuje — czyli tokenu z kropką dziesiętną i bez znacznika wykładniczego — tuż obok przekonwertowanego Double. TPDFNumeric.Output zapisuje ten tekst z powrotem, ilekroć jest obecny, i formatuje Double według PDFPrecNum struktury tylko wtedy, gdy nie jest. TPDFNumeric.SetTo wyrzuca tekst, bo edytowana liczba to nowa liczba i powinna słuchać bieżącej precyzji wyjściowej
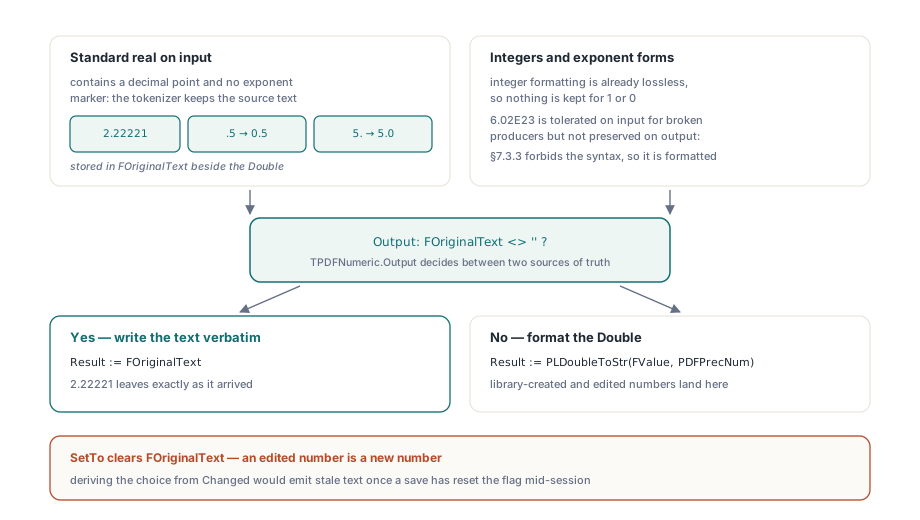
Przywiązanie resetu do SetTo było świadome. Kuszący skrót to wypuszczać tekst oryginalny, dopóki flaga Changed obiektu nie jest ustawiona — flaga już istnieje na każdym obiekcie. Potok zapisu czyści jednak Changed, gdy tylko obiekt został zapisany, więc wartość edytowana, zapisana i znowu edytowana w tej samej sesji wróciłaby na drugim zapisie do wypuszczania nieaktualnego literału. Czyszczenie tekstu wewnątrz samego przypisania znaczy, że literał i wartość nie mogą się nigdy rozjechać
Kilka granic jest celowych. Liczby całkowite nie są trzymane jako tekst, bo ich formatowanie jest już bezstratne. Postacie wykładnicze jak 6.02E23 są przyjmowane na wejściu dla producentów, którzy i tak je piszą, ale na wyjściu są formatowane jak każda liczba wygenerowana przez bibliotekę, bo odesłanie ich z powrotem utrwalałoby składnię, którą §7.3.3 wyklucza. Tokenizer stosuje też przed zapisaniem tekstu swoją zwykłą drobną naprawę: literał z wiodącą kropką jak .5 jest trzymany jako 0.5, a literał z końcową kropką jak 5. jako 5.0. Każdy czytnik traktuje każdą parę jako tę samą liczbę, a naprawiona pisownia jest przyjmowana znacznie szerzej
Poniższy snippet przepuszcza wartości CalRGB przez warstwę obiektową wprost, więc każdą regułę widać bez otwierania pliku PDF. Linijki Assert to sprawdzenia, które sugerujemy dodać we własnych testach; nie są to wywołania biblioteki
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Własne sprawdzenie: nieedytowane wejście przeżywa dosłownie, łącznie z
    // wartością, którą naiwny formatter czterech miejsc zawaliłby do 0
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Edycja wyrzuca tekst oryginalny i słucha PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // Malutkie nowe wartości zachowują cyfry znaczące zamiast stawać się 0
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // Obniżenie precyzji później nie sięga nieedytowanego wejścia
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Jedna pułapka przy pisaniu takich asercji: Round w Delphi używa zaokrąglania bankiera, a 0.000012345 * 1e8 wychodzi w binarnej arytmetyce jako 1234.4999…, nie 1234.5. Wpadliśmy na tę wartość prosto przy sprawdzaniu ścieżki formatowania blisko zera. Wybieraj wejścia testowe, które nie są binarnymi punktami środkowymi, ilekroć asercja zależy od tego, jak zaokrągli się ostatnia cyfra
Co kontroluje SetPrecision?
TPDFlib.SetPrecision ustawia miejsca dziesiętne liczb, które pisze biblioteka: grafiki rysowane przez painter, liczby tworzone z Double, na przykład przez NewNumeric, oraz sparsowane wartości zmienione potem przez SetTo. Przyjmuje wartości od 2 do 8 i zwraca 0 dla czegokolwiek poza tym zakresem. Sparsowana liczba dziesiętna, której nikt nie edytował, trzyma swój tekst wejściowy niezależnie od ustawienia, a zmiana ustawienia po LoadFromFile nie sięga w nią wstecz. Źródło podane do SetObjectFromString przechodzi przez ten sam tokenizer i jest trzymane tak samo
Nasza rekomendacja to zostawić SetPrecision w spokoju, chyba że generowana geometria potrzebuje drobniejszych kroków. Podnoszenie go dla ochrony plików wejściowych nie daje nic, bo nietknięte wejście już zachowuje własne cyfry, a każdą rysowaną liczbę robi dłuższą. Pięć miejsc to sensowny wybór do pracy rysunkowej poniżej punktu; osiem głównie nadmuchuje strumienie zawartości
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Rządzi liczbami pisanymi od tego momentu; sparsowane tablice /Gamma,
    // /Matrix i /WhitePoint zachowują swój tekst oryginalny
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // rysowane liczby używają pięciu miejsc
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Strumienie zawartości: edycje zachowują operandy, normalizacja jest opt-in
Edytowalny model zawartości zachowuje tekst operandów domyślnie i kanonizuje liczby tylko wtedy, gdy kanoniczne wyjście jest celem wywołania. TPDFContentProgram.CanonicalNumbers ma domyślnie False, więc warstwa zwrócona przez ParsePageContentLayer — ten sam model, na którym zbudowany jest tracker stanu grafiki — wypuszcza każdy nietknięty operand liczbowy dokładnie tak, jak był zapisany. Edycje strony przepisujące całą warstwę, w tym ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths i własny program zapisany z powrotem przez WritePageContentLayer, zmieniają tylko operandy, których edycja dotknęła
Drugi domyśl wygląda schludniej: kanonizuj przy każdym parsowaniu, żeby ścieżka edycji i NormalizeContentStreams zawsze produkowały tę samą pisownię. Uważamy go za zły domyśl dla edycji. ScalePage na warstwie zawierającej 0.123456 w zapisałoby z powrotem 0.1235 w, a każdy inny operand w warstwie zostałby przepisany, mimo że wołający prosił tylko o skalowanie. Forma kanoniczna należy do operacji, których celem jest porównywalne wyjście
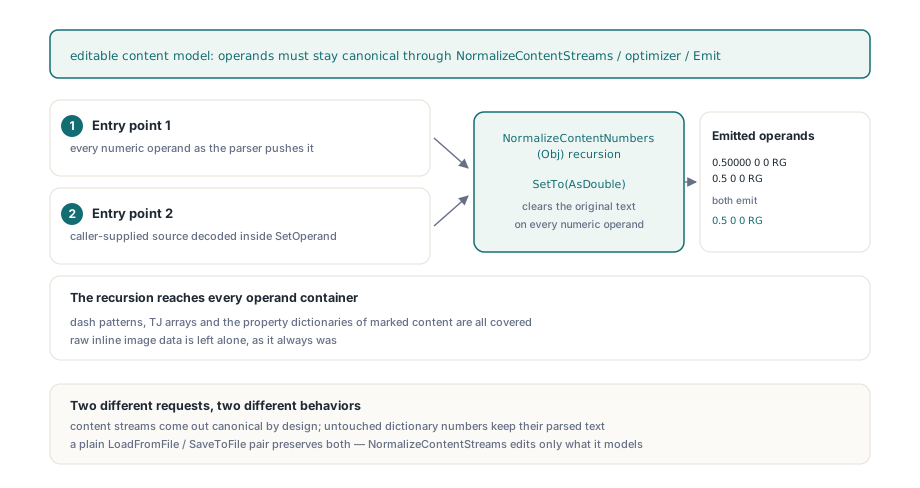
Te operacje nadal ją dostają. NormalizeContentStreams i optymalizator zawartości przy zapisie parsują z CanonicalNumbers ustawionym na True, bo ich robotą jest stabilne wyjście z dowolnego wejścia; gdyby 0.50000 0 0 RG i 0.5 0 0 RG wypisywały się różnie, każde porównanie dalej w potoku dryfowałoby z nawykami formatowania producenta. Kanonizacja rekurencyjnie przechodzi tablice i słowniki, więc obejmuje wzory kreskowania, tablice TJ i słowniki właściwości treści oznaczonych, podczas gdy surowe dane obrazów inline zostają nietknięte. Operandy podane przez SetOperand są kanonizowane niezależnie od flagi. Program zawartości niesie własny magazyn liczb przybity do czterech miejsc po przecinku, niezależny od SetPrecision, więc edytowany operand wychodzi z czterema. Flagę czyta tylko Parse, co znaczy, że trzeba ją ustawić przed parsowaniem; dla programu, który ParsePageContentLayer już sparsował, ustaw flagę i wołaj Parse(Emit)
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Zmień jedną grubość linii; każdy inny operand zachowuje swój tekst źródłowy
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // emitowane jako 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Kanoniczna kopia tylko do porównania, nie zapisywana z powrotem:
      // Parse to jedyny czytelnik flagi, więc po jej ustawieniu parsuj ponownie
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit pisze teraz 0.50000 i 0.5 tak samo
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Złożone razem, reguła dla wołających jest krótka. Zwykłe LoadFromFile i potem SaveToFile zostawiają nietknięte strumienie zawartości i nietknięte liczby w słownikach takie, jakie były. Strona edytowana przez model zawartości zachowuje tekst każdego operandu, którego edycja nie zmieniła. NormalizeContentStreams, optymalizator biegnący przy kompresji zawartości na zapisie i każdy program sparsowany z CanonicalNumbers na True produkują liczby kanoniczne z założenia, a reszta dokumentu pozostaje zachowana
Ile to kosztuje i gdzie kończy się gwarancja
Każdy TPDFNumeric niesie jedną dodatkową referencję AnsiString, a każda sparsowana liczba dziesiętna trzyma swój tekst źródłowy przy życiu przez cały czas życia obiektu. W dokumencie z milionami liczb rzeczywistych to mierzalna pamięć i należy ją wpisać w każdy benchmark dużych dokumentów, jaki uruchamiasz. Gwarancja jest też ograniczona do dokumentu, do którego liczba należy. Kopiowanie obiektów między dokumentami albo przebudowywanie wartości przez API obiektowe produkuje nowe liczby, a nowe liczby słuchają precyzji wyjściowej
Zachowane liczby i wyjście identyczne bajt w bajt to osobne własności. Wczytanie i zapis nietkniętego dokumentu zachowuje liczby kalibracji, które konsumuje renderer, ale identyczność bajtów zależy też od numeracji obiektów, kompresji strumieni i identyfikatora w przyczepie, opisanych w artykule o deterministycznym ID PDF. Diff odcisków dalej haszuje znormalizowane ciało, co znaczy, że różnice zaokrągleń w plikach od innych narzędzi wypadają poza to, co porównuje; porównanie renderów pozostaje na nie sprawdzeniem
Obsługa liczb i dokładna semantyka SetPrecision są opisane w dokumentacji losLab PDF Developer Library, razem z wywołaniami modelu zawartości użytymi powyżej