PDF Library for Delphi potrafi scalić obrazy wewnątrz PDF, które wyglądają tak samo, ale nie są identyczne bajtowo, za pomocą DeduplicateSimilarImages. Dokładna deduplikacja scala tylko obrazy, których słowniki i zakodowane ładunki się zgadzają; ta porównuje to, jak obrazy faktycznie wyglądają, wykorzystując hash percepcyjny plus dwa progi błędu pikseli, i przekierowuje każde odwołanie do jednego kanonicznego obiektu
Pliki, w których to się opłaca, to te, które urosły przypadkiem. Zeskanowana partia, w której każda strona niesie to samo logo ponownie zakodowane przez inny skaner. Raport złożony ze źródeł, z których każde osadziło ten sam wykres w nieco innej jakości JPEG. Katalog, którego miniatury zostały ponownie wygenerowane przez dwa narzędzia. W każdym przypadku plik zawiera wiele kopii jednego obrazu, a dokładna deduplikacja nie może dotknąć żadnej z nich
Co musi znaczyć „wystarczająco podobne”
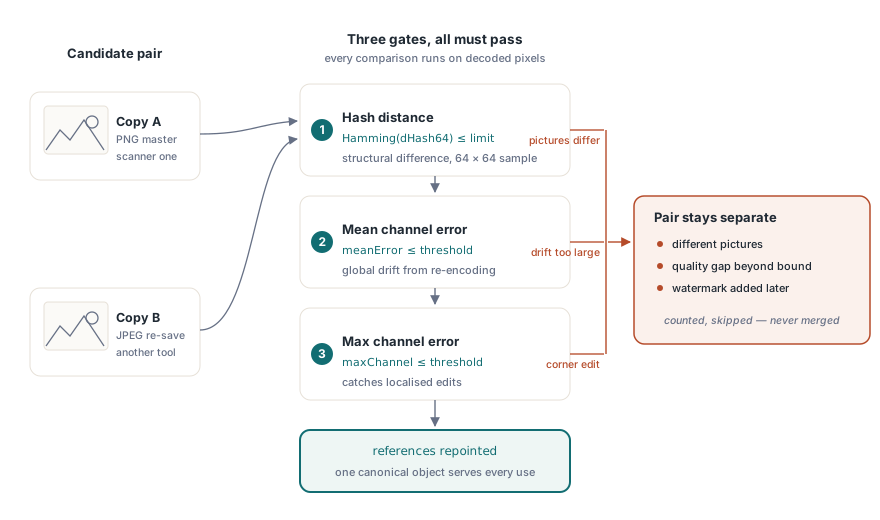
Muszą być spełnione wszystkie trzy progi, zanim dwa obrazy zostaną scalone, a każdy wyłapuje inny rodzaj różnicy. Odległość hasha percepcyjnego ogranicza różnicę strukturalną: 64-bitowy hash różnicowy jest obliczany z próbki 64 na 64 zdekodowanego obrazu, a dozwolona odległość Hamminga wynosi od 0 do 7. Średni błąd kanału ogranicza ogólny dryf, który jest efektem ponownego kodowania. Maksymalny błąd pojedynczego kanału ogranicza zlokalizowaną różnicę, będącą efektem drobnej edycji
To wymóg wszystkich trzech sprawia, że scalenie jest uzasadnione. Obraz różniący się znakiem wodnym w jednym rogu ma niski średni błąd i wysoki błąd maksymalny, więc bramka błędu maksymalnego go odrzuca. Obraz, który został ponownie skompresowany, ma niewielki błąd wszędzie, więc przechodzi. To dokładnie to rozróżnienie, które musi wyznaczyć optymalizator rozmiaru
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Odległość hasha 2, średni błąd 2, błąd pojedynczego kanału 4.
    // Opcje mogą zażądać przebiegu próbnego, dzięki czemu nic nie jest modyfikowane
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
Tożsamość semantyczna przed podobieństwem wizualnym
Zanim porówna się jakiekolwiek piksele, obrazy kandydujące muszą się zgadzać semantycznie. Biblioteka buduje stabilną sygnaturę z pełnego słownika obrazu z wyłączeniem /Length, /Filter i /DecodeParms, więc wymiary, przestrzeń kolorów, głębia bitowa, maski, tablica /Decode, interpolacja, przynależność do treści opcjonalnej i metadane muszą się wszystkie zgadzać
Ta kolejność zapobiega całej klasie błędnych scaleń. Dwa obrazy mogą wyglądać identycznie w próbce 64 na 64, a zachowywać się różnie na stronie: jeden z /Interpolate ustawionym na true, a drugi bez tego będą inaczej wygładzane przy skalowaniu, a ten należący do grupy treści opcjonalnej zniknie, gdy ta warstwa zostanie ukryta. Scalanie ponad tymi granicami daje dokument mniejszy i błędny
Skanowane są tylko pośrednie obiekty Image XObject. Obrazy osadzone w tekście (inline) to inna konstrukcja o innej ekonomii, a obrazy, których nie da się zdekodować, są ostrożnie pomijane i liczone, a nie scalane na wiarę — bez dowodu na poziomie pikseli nie ma scalenia
Jak przeszukiwanie pozostaje tanie
Porównywanie każdego obrazu z każdym innym jest kwadratowe, co jest nieakceptowalne w dokumencie zawierającym tysiące obrazów. Hash jest więc dzielony na osiem 8-bitowych pasm, z uporządkowanym indeksem dla każdego z nich
Resztę robi zasada szufladkowa: jeśli dwa hashe różnią się co najwyżej o 7 bitów, muszą się dokładnie zgadzać na co najmniej jednym z ośmiu pasm. Wyszukiwanie kandydatów pasmo po paśmie znajduje więc każde dopuszczalne dopasowanie bez wyczerpującego przeszukiwania parami, a opublikowany limit 7 istnieje właśnie dlatego, że gwarancja obowiązuje tylko do tej odległości
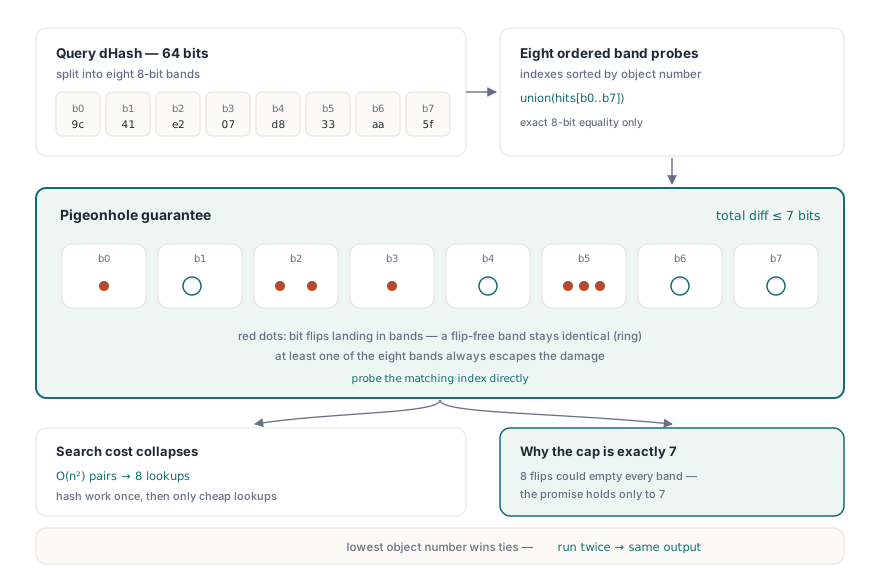
Kandydaci i trafienia pasm są uporządkowani deterministycznie według numeru obiektu i generacji, a najniższy numer obiektu staje się kanoniczny. To sprawia, że wynik jest odtwarzalny: dwukrotne uruchomienie optymalizatora na tym samym wejściu daje te same kanoniczne wybory, co ma znaczenie, gdy wynik jest porównywany albo podpisywany
Przebiegi próbne i uczciwe raportowanie
Ponieważ jest to optymalizacja stratna w tym sensie, że scalane obrazy nie były identyczne, sensownym sposobem pracy jest najpierw spojrzeć, zanim się skoczy. Opcja przebiegu próbnego zgłasza, co zostałoby scalone i ile ładunku zostałoby odzyskane, bez modyfikowania grafu obiektów, więc zadanie wsadowe może logować efekt, a człowiek może zatwierdzić progi raz, zamiast dla każdego pliku z osobna
Warto wspomnieć o dwóch uczciwych uwagach w raportowaniu. Liczba możliwa do odzyskania szacuje wyłącznie zakodowany ładunek duplikatów strumieni; nie liczy narzutu słownika, obiektu pośredniego i odsyłaczy krzyżowych, więc rzeczywista redukcja rozmiaru pliku jest nieco większa niż zgłoszona, a nie mniejsza. A raport ujawnia maksymalny zaakceptowany błąd i nakład porównań, więc widać, jak blisko progów znalazły się scalenia
Stała siatka próbkowania 64 na 64 to celowe przybliżenie, i ma konsekwencję wartą jasnego wypowiedzenia: różnica mniejsza niż jedna komórka próbki może pozostać niezauważona nawet przy zerowym progu. Pojedyncze zmienione słowo na zeskanowanej stronie może nie przetrwać takiego próbkowania. Gdy wymagany jest dowód na poziomie bajtów, użyj zamiast tego ścieżki dokładnej deduplikacji — scala ona wyłącznie zasoby naprawdę identyczne i w ogóle nie dokonuje oceny wizualnej
Gdzie to pasuje w potoku redukcji rozmiaru
Uporządkuj przebiegi według ryzyka. Uruchom najpierw dokładną deduplikację zasobów, ponieważ jest bezstratna i darmowa. Potem tworzenie podzbioru czcionek, które również jest bezstratne i zwykle stanowi pojedynczy największy zysk w dokumentach bogatych w tekst, co opisano w optymalizacji rozmiaru pliku PDF i tworzeniu podzbiorów czcionek. Potem ponowna kompresja obrazów albo zmniejszenie rozdzielczości, jeśli medium docelowe na to pozwala. Deduplikacja percepcyjna należy do etapu po tych, ponieważ jest jedynym krokiem, którego wynik zależy od oceny wymagającej osądu
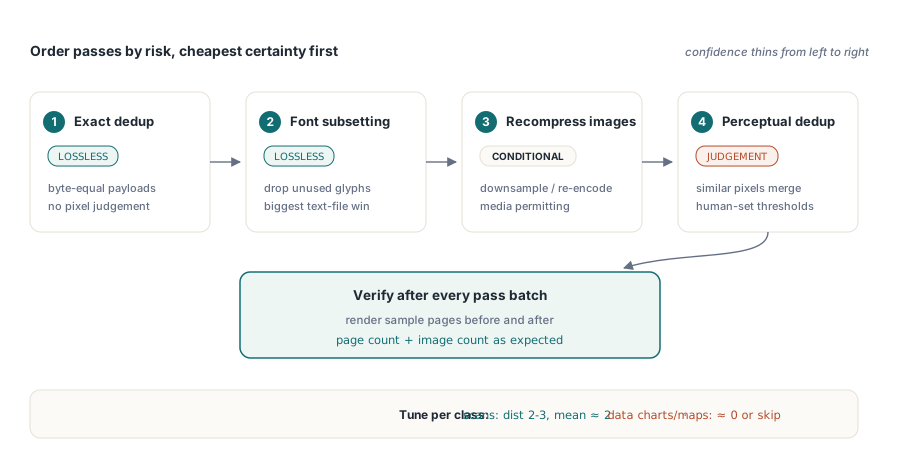
Wybieraj progi według klasy dokumentu, a nie globalnie. Dla zeskanowanych partii, w których każda strona niesie ten sam papier firmowy, odległość hasha 2 do 3 ze średnim błędem około 2 niezawodnie scala papier firmowy. Dla dokumentów, w których obrazy niosą dane — wykresy, mapy, obrazowanie medyczne — użyj progów zerowych albo bliskich zeru, albo całkowicie pomiń ten przebieg, ponieważ dwa wykresy różniące się jednym naniesionym punktem to dwa różne wykresy, bez względu na to, jak podobne wyglądają przy próbkowaniu 64 na 64
Po optymalizacji zweryfikuj. Wyrenderuj próbkę stron przed i po i porównaj je, a także sprawdź, czy liczba stron i liczba obrazów zmieniły się tak, jak oczekiwałeś. Ścieżkę inspekcji tego, co dokument faktycznie zawiera, opisano w audytowaniu rozmiaru pliku PDF według kategorii, co jest też najszybszym sposobem, by w ogóle sprawdzić, czy problemem są obrazy
Deduplikacja percepcyjna, dokładna deduplikacja zasobów i audyt rozmiaru działają na tym samym grafie obiektów dla Delphi, C++Builder i Free Pascal; pełną listę funkcji znajdziesz na stronie PDF Library for Delphi