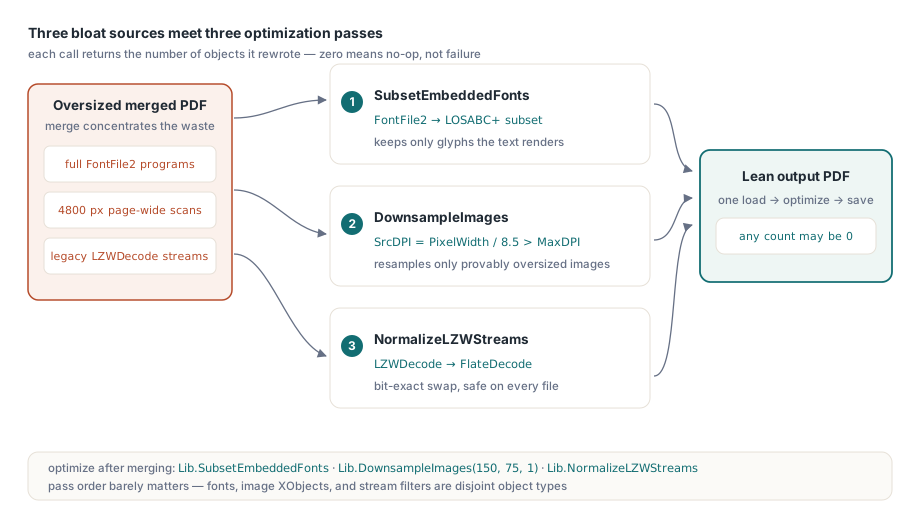
Żeby zmniejszyć rozmiar pliku PDF w Delphi, losLab PDF Library dostarcza trzy API, które uderzają w trzy największe źródła rozdęcia: SubsetEmbeddedFonts przepisuje każdy osadzony program fontu TrueType w dół do glifów, które dokument faktycznie renderuje, DownsampleImages resampluje obrazy rastrowe przekraczające docelowe DPI, a NormalizeLZWStreams zastępuje przestarzałą kompresję LZWDecode FlateDecode. Każde zwraca liczbę zmienionych obiektów, więc zero mówi ci, że przebieg był no-opem, a nie cichym niepowodzeniem
Dlaczego mój scalony plik PDF jest większy niż pliki źródłowe?
Scalony albo generowany programowo PDF jest zwykle przesadnie duży z jednego z trzech powodów: w pełni osadzone fonty, obrazy próbkowane daleko ponad swoją rozdzielczość wyświetlania i strumienie wciąż skompresowane przestarzałym filtrem LZW. ISO 32000-1 §9.9 pozwala producentowi osadzić kompletny program fontu, i większość producentów robi dokładnie to, bo to bezpieczny domyśl. Kompletny FontFile2 Ariala ciągnie setki kilobajtów; osadź go w kilkunastu plikach źródłowych, scal je, i wożysz kilkanaście kopii obrysów glifów dla znaków, których nikt nie wpisał. Samo scalenie nie tworzy tego marnotrawstwa, ono je tylko koncentruje w jednym pliku, w którym suma w końcu staje się widoczna
Obrazy są drugim winowajcą. Skan o szerokości 4800 pikseli włożony w ramkę ćwierci strony wozi jakieś 40 razy więcej danych pikselowych, niż potrafi wykorzystać drukarski potok 300 DPI. Trzeci jest cichszy: strumienie filtrowane LZWDecode. ISO 32000-1 §7.4.4 specyfikuje i LZWDecode, i FlateDecode, z notką, że Flate zwykle kompresuje co najmniej równie dobrze; w praktyce wyjście Flate jest na tych samych danych konsekwentnie mniejsze, a LZW przetrwał głównie w plikach, które w swojej historii przeszły przez narzędzia z lat 90. Reszta tego artykułu przechodzi przez trzy przebiegi losLab PDF Library, które każdy z tych problemów naprawia, po czym łączy je w jeden potok
Wydzielanie podzbiorów fontów za pomocą SubsetEmbeddedFonts
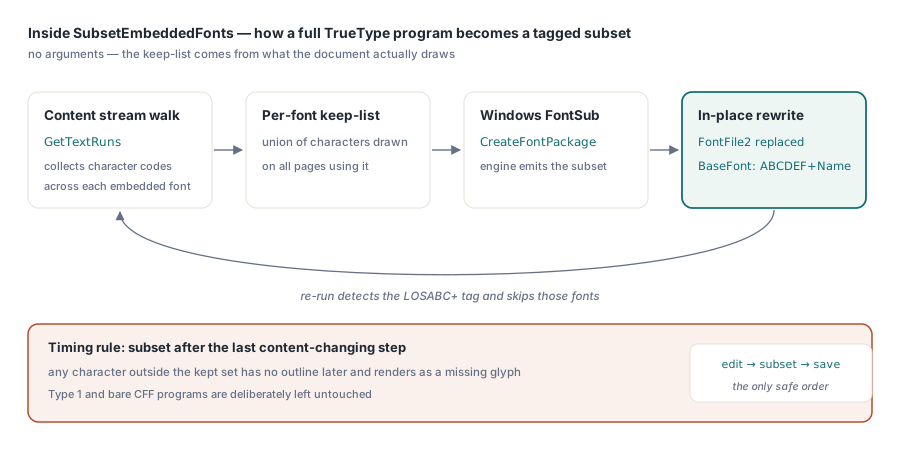
SubsetEmbeddedFonts zmniejsza każdy wbudowany font TrueType w załadowanym dokumencie do znaków, które są faktycznie używane, i nie wymaga żadnych argumentów, ponieważ pobiera listę zachowywanych znaków bezpośrednio ze strumieni zawartości. Wewnętrznie ten przebieg analizuje strumień zawartości każdej strony za pomocą GetTextRuns, zbiera kody znaków powiązane z każdym zasobem fontu, buduje listę zachowywanych znaków i przekazuje oryginalny program fontu do silnika Windows FontSub (CreateFontPackage) w celu utworzenia podzbioru. Przepisany program zastępuje w miejscu strumień FontFile2, a nazwa BaseFont zyskuje znacznik LOSABC+ według konwencji sześciu wielkich liter i znaku plus, którą ISO 32000-1 §9.6.4 definiuje dla fontów z wydzielonym podzbiorem. Ten prefiks sprawia również, że wywołanie jest idempotentne: uruchom ten przebieg dwukrotnie, a już przetworzone fonty zostaną rozpoznane i pominięte, co czyni bezpiecznym wpięcie tej metody do zadania wsadowego, które może ponownie odwiedzać pliki
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = liczba przepisanych programów FontFile2;
      // 0 oznacza, że niczego nie osadzono albo wszystko już zredukowano do podzbioru
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Dwa szczegóły implementacyjne są warte poznania, bo wyjaśniają granice API. Po pierwsze, przebieg celuje w FontFile2, więc obejmuje osadzone programy TrueType; fonty osadzone jako Type 1 albo gołe CFF zostają nietknięte, zamiast ryzykować. Po drugie, opiera się na FontSub, co czyni SubsetEmbeddedFonts rozwiązaniem wyłącznie na Windows. Subtelniejszy punkt z implementacji: o tym, czy font się kwalifikuje, decyduje faktyczne rozwiązanie łańcucha referencji FontDescriptor → FontFile2, a nie wiara w heurystykę flagi osadzenia, bo fonty w wczytanym dokumencie nigdy nie przeszły przez księgowość strony tworzącej, która takie flagi ustawia. Jeśli rozwiązany strumień istnieje, font jest kandydatem; jeśli nie, jest pomijany bez błędu
Uczciwy kompromis: font z wydzielonym podzbiorem zawiera tylko te glify, które były obecne w momencie wydzielania. Jeśli inne narzędzie lub Twój własny kod doda później tekst tym samym fontem, każdy znak spoza podzbioru nie będzie miał obrysu i wyrenderuje się jako brakujący glif. Wydzielaj podzbiory jako ostatni krok zmieniający zawartość, nigdy przed etapem edycji. Ta sama ostrożność obowiązuje, jeśli planujesz później wyciągnąć font do ponownego użycia; artykuł o wyciąganiu tekstu, obrazów i fontów za pomocą PDF Library for Delphi opisuje, co wyekstrahowany program podzbioru może, a czego nie może Ci dać
Jak DownsampleImages decyduje, które obrazy zmniejszyć?
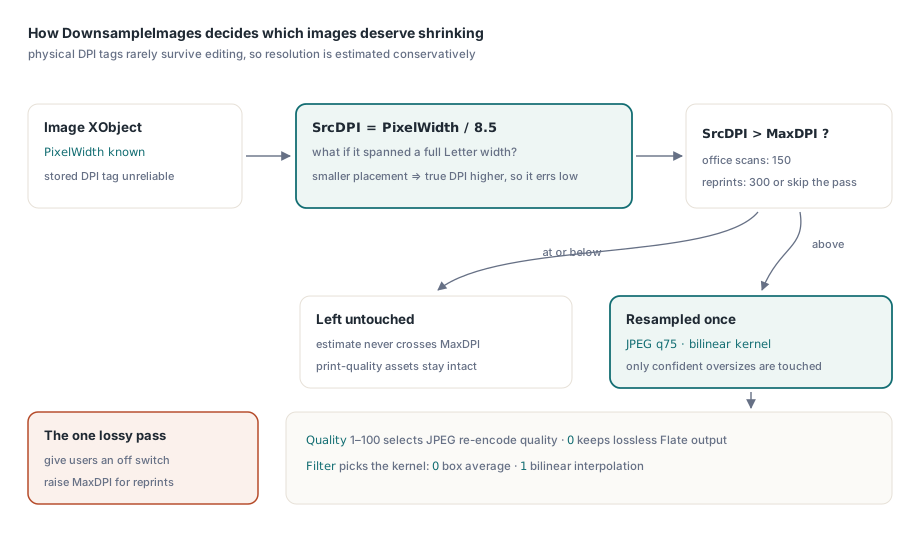
DownsampleImages(MaxDPI, Quality, Filter) resampluje wyłącznie obrazy, które potrafi z pewnością nazwać przewyższonymi, używając celowo konserwatywnego szacunku DPI. Obrazowy XObject w PDF przechowuje wymiary pikselowe, ale nie wiarygodną fizyczną rozdzielczość, a jakakolwiek etykieta DPI z obrazu źródłowego rzadko przeżywa cykl wczytaj-edytuj-zapisz. Dlatego przebieg szacuje SrcDPI = PixelWidth / 8.5, w efekcie pytając: gdyby ten obraz rozpiął się na pełną szerokość strony Letter, jaka byłaby jego rozdzielczość? Dotykane są tylko obrazy, których szacunek przekracza MaxDPI. Ta stronniczość jest intencjonalna: obraz umieszczony mało na stronie ma prawdziwe DPI wyższe niż szacunek, więc przebieg odpala się rzadziej, zamiast degradować zasób o jakości drukarskiej, którego nie potrafi zmierzyć
Quality od 1 do 100 wybiera jakość ponownego kodowania JPEG, a 0 zostawia wyjście jako bezstratny Flate w stylu PNG; Filter wybiera jądro resamplingu, 0 dla średniej pudełkowej i 1 dla dwuliniowej. Dla skanowanej biurowej papierologii rozsądnym punktem startu jest DownsampleImages(150, 75, 1); dla czegokolwiek, co może zostać wydrukowane ponownie, podnieś MaxDPI do 300 albo pomiń ten przebieg w całości. Zmniejszanie rozdzielczości to jedyny stratny krok z trzech, więc należy go schować za ustawieniem, które twoi użytkownicy mogą wyłączyć
Konwertowanie przestarzałych strumieni LZW za pomocą NormalizeLZWStreams
NormalizeLZWStreams to darmowa wygrana: bezstratnie dekompresuje każdy strumień LZWDecode i kompresuje go ponownie za pomocą FlateDecode na miejscu, zwracając liczbę przekonwertowanych strumieni. Obsługuje zarówno pojedynczy wpis /Filter /LZWDecode, jak i LZW pojawiające się w tablicy łańcucha filtrów, gdzie zastępowane jest tylko ogniwo LZW, a reszta łańcucha pozostaje zachowana. Parametry predyktora (Predictor, Columns, Colors, BitsPerComponent) są odczytywane z DecodeParms strumienia i przekazywane do dekompresora, dzięki czemu dane obrazu zakodowane z predyktorem przechodzą proces bezproblemowo. Ponieważ oba filtry są kodekami bitowo dokładnymi, zdekodowane bajty są identyczne przed i po; zmienia się tylko kompresja kontenera, co czyni ten przebieg bezpiecznym do uruchomienia bezwarunkowo na każdym pliku
Na dokumencie bez strumieni LZW wywołanie po prostu zwraca 0 i niczego nie dotyka, więc świeżo utworzony plik wyłącznie Flate raportuje zero konwersji. Ta gwarancja no-op ma znaczenie, gdy przebieg siedzi w potoku przetwarzającym tysiące niejednorodnych plików, niektóre z 2024, a niektóre z 1998 roku
Kompletny potok optymalizacji rozmiaru w Delphi
Trzy przebiegi łączą się w jedną funkcję wczytaj-optymalizuj-zapisz, a kolejność ma mniejsze znaczenie, niż można by się spodziewać, ponieważ działają one na rozłącznych typach obiektów: fontach, obiektach graficznych XObject i filtrach strumieni. Uruchomienie najpierw wydzielania podzbiorów jest nadal najbardziej uporządkowanym wyborem, ponieważ jest to przebieg z ograniczeniem kolejności edycji
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> subset
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilinear
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Log Fonts/Images/Streams: trzy zera oznaczają, że plik był już odchudzony
  finally
    Lib.Free;
  end;
end;
Zweryfikuj potok pełnym obiegiem: utwórz dokument, zapisz go, wczytaj ponownie, uruchom optymalizację, zapisz jeszcze raz, po czym sprawdź trzy rzeczy: wyjście jest mniejsze, zwrócone liczniki zgadzają się z oczekiwaniami, a ponowne wczytanie zoptymalizowanego pliku nadal parsuje się i renderuje. Odtworzenie tej pętli utwórz-optymalizuj-wczytaj na próbce własnych plików produkcyjnych, z porównaniem ekstrahowanego tekstu przed i po, to godzinna inwestycja, która łapie błędy integracji na długo, zanim klient otworzy zepsutą fakturę
// Kontrola round-trip: zoptymalizowany plik nadal musi wczytać się bez błędów
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Gdzie potok pasuje do przepływu pracy scalania? Po scaleniu, a nie w jego trakcie. Najpierw scalenie, a następnie optymalizacja pojedynczego wyniku oznacza, że każdy wbudowany font jest dzielony na podzbiory tylko raz dla sumy wszystkich użytych znaków, a nie dla każdego pliku źródłowego z osobna. Jeśli przepustowość scalania jest wąskim gardłem, PDF Library for Delphi oferuje szybką ścieżkę na poziomie bajtów, która unika pełnego parsowania obiektów, opisaną w artykule o szybkim scalaniu PDF z przesunięciem referencji bajtowych; w przypadku danych wejściowych zbyt dużych, by zmieścić je w pamięci, artykuł o bezpośrednim dostępie do łączenia i dzielenia dużych plików PDF opisuje ścieżkę strumieniową. Obie te metody naturalnie łączą się z końcowym przebiegiem optymalizacji scalonego wyniku
Do czego ograniczają się te trzy przebiegi
Tercet optymalizacyjny losLab PDF Library trzyma się z dala od czegokolwiek, co zmienia semantykę dokumentu. SubsetEmbeddedFonts szczupli każdy osadzony font niezależnie; ujednolicanie zduplikowanych fontów ze scalonych źródeł do jednego programu to inna, ryzykowniejsza transformacja. DownsampleImages działa tylko wtedy, gdy jego konserwatywny szacunek DPI przekracza próg, więc obraz graniczny zachowuje swoje piksele nawet wtedy, gdy człowiek by powiedział, że jest za duży do swojej ramki. A przebiegi pracują na poziomie strumieni, więc plik rozdęty przez tysiące osieroconych obiektów woła o zapis w stylu przepisywania. W tych granicach kombinacja wydzielania podzbiorów fontów, zmniejszania obrazów i normalizacji LZW na Flate usuwa trzy klasyczne źródła rozdęcia PDF, każde jednym przewidywalnym wywołaniem API. Te trzy funkcje są dostarczane w składzie losLab PDF Library dla Delphi, C# i VB.NET, obok omawianych wyżej API scalania, ekstrakcji i renderowania