HotPDF Delphi Component kan søke og erstatte tekst inne i en eksisterende PDF fra Delphi og C++Builder. SearchLoadedPageText og SearchLoadedDocumentText finner hver forekomst av en streng med presisjon på glyfnivå, og ReplaceLoadedPageText og ReplaceLoadedDocumentText skriver om de treffende bytene på stedet — forutsatt at hvert erstatningstegn kan kodes på nytt gjennom den opprinnelige skriften, en fysisk begrensning denne artikkelen behandler ærlig i stedet for å gjemme bort i en fotnote
Ønsket bak denne funksjonen er alltid hverdagslig. Et selskap skifter navn, og tre tusen arkiverte fakturaer bærer fortsatt det gamle. En kontraktsmal ble sendt ut med fjorårets utløpsdato. En produktkode ble pensjonert, og hvert datablad som nevner den, trenger etterfølgerkoden i stedet. I et tekstbehandlingsprogram er hver av disse en jobb på tretti sekunder. I en PDF er det et genuint vanskelig problem, og å forstå hvorfor er forskjellen på å bruke API-et godt og å sende inn en feilrapport som egentlig er en henvisning til spesifikasjonen
Hvorfor er det så vanskelig å erstatte tekst i en PDF?
Å erstatte tekst i en PDF er vanskelig fordi en PDF-side ikke inneholder redigerbar tekst — den inneholder posisjonerte glyfer. Under modellen for tekstvisning i ISO 32000-1 §9.4 driver en innholdsstrøm operatorer som Tj og TJ, som maler sekvenser av tegnkoder i koordinater fastsatt av tekstmatrisen. De kodene er ikke Unicode; de er indekser inn i den kodingen sidens skrift oppgir, og avbildningen tilbake til lesbare tegn kan ligge i en /ToUnicode-CMap, et differansearray for kodingen eller en kjede av CID-avbildninger. Det finnes ikke noe avsnittsobjekt, ingen tekstflyt, og ingen garanti for at ett visuelt ord i det hele tatt er lagret som én streng
Erstatning legger et andre lag av vanskelighet oppå dekodingen: du må vite nøyaktig hvilke byte av den opprinnelige strømmen som produserte hver glyf, slik at du kan skjøte nye byte inn i akkurat det spennet og ingenting annet. En tekstuttrekker har råd til å kaste byteposisjonene når den har fått ut Unicode-teksten. En erstatter har ikke det. Det er derfor HotPDF delte arbeidet over to utgivelser — v2.251.0 bygde sporingen av forskyvninger og søkelaget, og v2.252.0 bygde omskrivingslaget oppå det
Å finne tekst: søk på glyfnivå med sporing av byteforskyvninger
SearchLoadedDocumentText i HotPDF finner hver forekomst av en søkestreng ved å matche mot den dekodede Unicode-glyfsekvensen på hver side, ikke mot rå strømbyte, så et treff er et treff uansett hvordan skriften kodet det. Infrastrukturen under kom i v2.251.0: tokeniseringen av innholdsstrømmen registrerer et StartOfs/EndOfs-bytespenn for hver strengoperand — inkludert ( )- eller < >-skilletegnene — og hver dekodet glyf bærer en trippel av TokenIndex/ItemIndex/ByteOffset som peker tilbake til nøyaktig den operanden, det TJ-array-elementet og den kodeenheten som lagde den. Den samme glyftolkeren driver uttrekks-API-et som er beskrevet i å trekke ut tekst fra en innlastet PDF i Delphi; søk beholder ganske enkelt den opprinnelsen uttrekk kaster
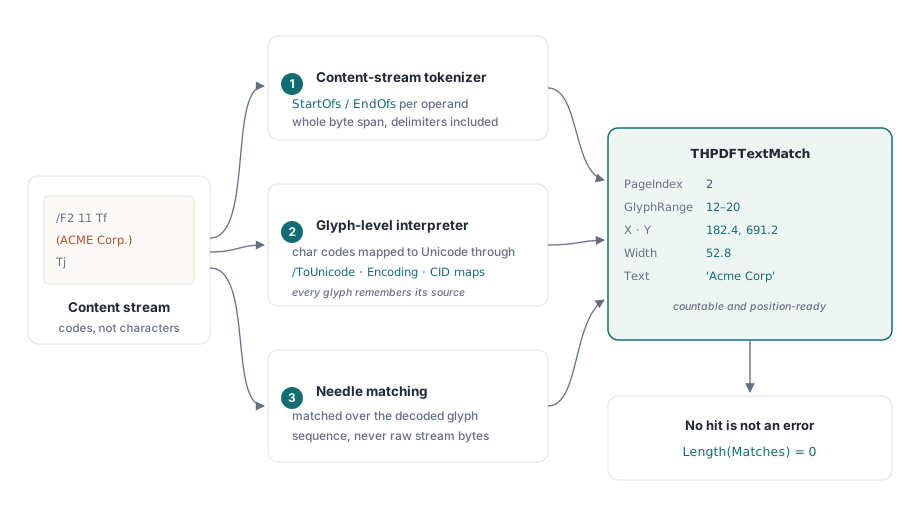
Hvert treff kommer tilbake som en THPDFTextMatch-record som bærer sideindeksen, det inkluderende glyfområdet, X/Y-origo og bredden på treffet i brukerrommet, kilde-token- og elementindeksen, og selve teksten som ble truffet. Det er nok til å drive et uthevingslag, et gjennomgangsgrensesnitt eller erstatningstrinnet. Et søk som ikke finner noe, returnerer et tomt array i stedet for å feile, så kallemønsteret forblir enkelt
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
    begin
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to Length(Matches) - 1 do
          WriteLn(Format('page %d at (%.1f, %.1f): "%s"',
            [Matches[I].PageIndex, Matches[I].X, Matches[I].Y,
             Matches[I].Text]));
    end;
  finally
    Pdf.Free;
  end;
end;
Ett bevisst designvalg fortjener en merknad. Når CaseSensitive er False, folder sammenligningen store og små bokstaver bare for ASCII-tegn, med vilje: full Unicode-folding oppfører seg ulikt på tvers av verktøykjedene fra Delphi 5 til XE som HotPDF støtter, og et søke-API som finner ulike treff avhengig av hvilken kompilator som bygde programmet ditt, er verre enn ett med en dokumentert og forutsigbar grense. For latinsk forretningstekst — navn, koder, datoer — dekker ASCII-folding de praktiske tilfellene
Å erstatte tekst: omvendt koding og kirurgisk skjøting
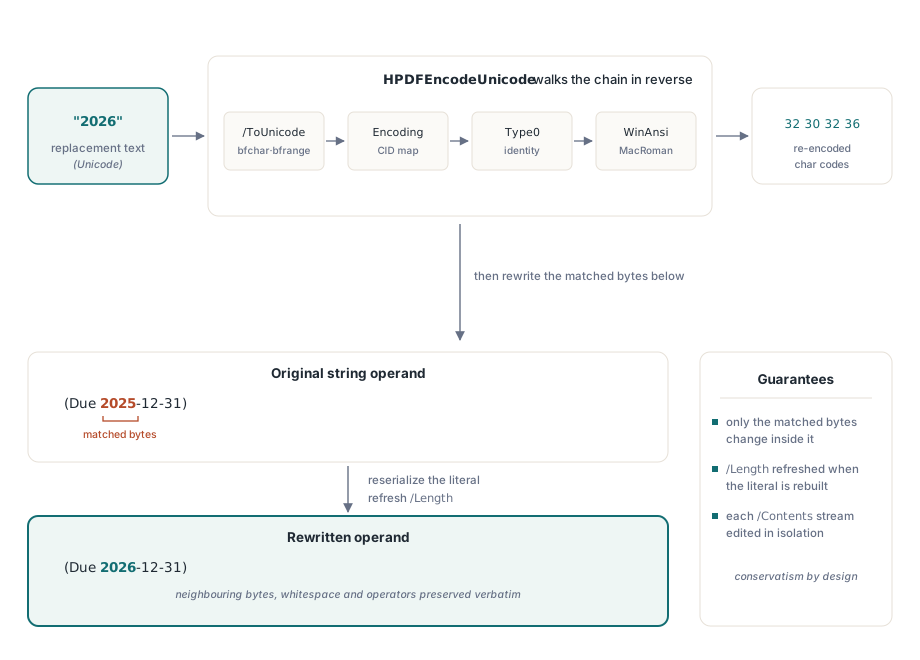
ReplaceLoadedDocumentText, som kom i HotPDF v2.252.0, skriver om hver forekomst av en søkestreng ved å kjøre dekodemaskineriet baklengs. Funksjonen HPDFEncodeUnicode er den omvendte av tegnkodedekoderen: den går gjennom den samme strategikjeden i motsatt retning — oppslag i /ToUnicode bfchar og bfrange, CID-avbildning fra kodingsstrømmen, Type0-identitetsavbildninger, og de forhåndsdefinerte WinAnsi- og MacRoman-tabellene — for å gjøre hvert erstatningstegn tilbake til de tegnkodebytene den opprinnelige skriften venter. De omkodede bytene serialiseres så inn i en velformet strengliteral eller heksstreng, som speiler tokeniseringens egne escape-regler slik at en rundtur med tolking → reserialisering er stabil
Selve skjøtingen er kirurgisk heller enn grovkornet. Bare kodebyteområdet som treffet dekker, erstattes inne i strengoperanden; byte i den samme operanden som ikke ble truffet, tomrommet mellom symboler og hver omkringliggende operator bevares ordrett, byte for byte. Å erstatte bca inne i abcabc gir a + erstatningen + bc, ikke en ødelagt operand. Erstatninger kan være kortere eller lengre enn søkestrengen — literalen reserialiseres og strømmens /Length oppdateres — og hver /Contents-strøm på en side med flere strømmer behandles isolert, så siden forblir velformet
var
  Pdf: THotPDF;
  ReplaceCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, ReplaceCount) then
        WriteLn(Format('%d operand rewrites performed', [ReplaceCount]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Merk hva API-et ikke gjør: det setter ikke siden på nytt. PDF har ingen reflyt, så en erstatning som er visuelt bredere enn originalen, opptar rett og slett mer vannrett plass og kan trenge seg på det som er malt til høyre for den. Erstatninger med samme eller nesten samme lengde — datoer, versjonsstrenger, delenumre, navnerettelser — er den søte flekken. Omfattende omformulering hører hjemme i kildedokumentet, ikke i PDF-en
Hvorfor kan du ikke erstatte tekst med tegn skriftdelmengden aldri inkluderte?
Du kan ikke erstatte tekst med et tegn den innebygde skriftdelmengden aldri inkluderte, fordi bytesekvensen som ville valgt det tegnet, rett og slett ikke finnes i skriftens avbildningstabeller. Når en PDF-produsent bygger inn en delmengdeskrift, dekker /ToUnicode-CMap-en og kodingsstrukturene bare de glyfene originaldokumentet faktisk brukte. HPDFEncodeUnicode kan bare snu en avbildning som er til stede: inneholdt dokumentet aldri bokstaven E i den skriften, finnes det ingen tegnkode for E å snu tilbake til. Dette er en fysisk egenskap ved filen, ikke en begrensning i noe bestemt bibliotek — ingen verktøy kan trylle fram en glyfavbildning som aldri ble bygd inn
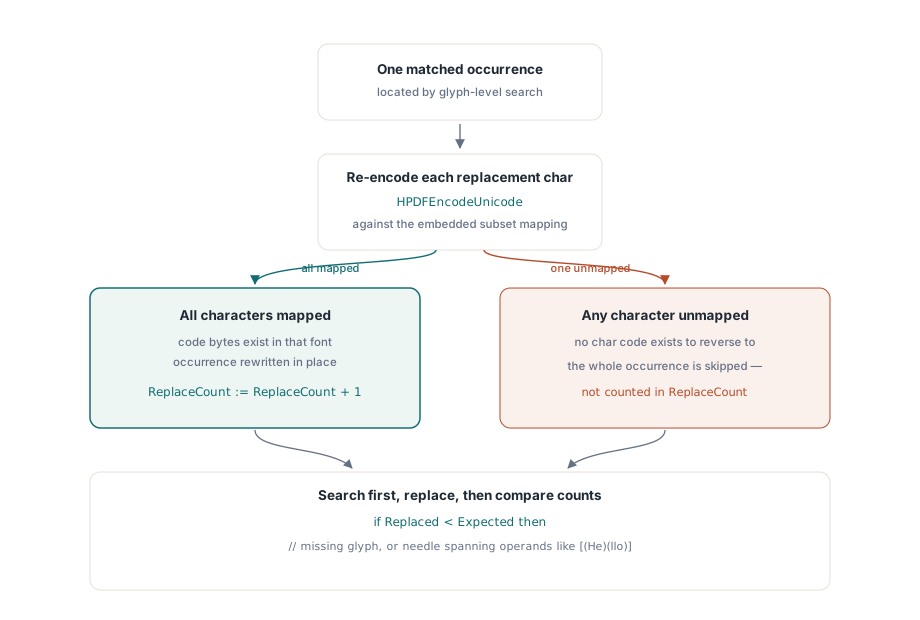
HotPDF håndterer feilen forsiktig. Kan ett eneste tegn i erstatningen ikke kodes på nytt, hoppes hele den forekomsten over — uten unntak, uten delvis søppeltekst, og forekomsten telles rett og slett ikke i ReplaceCount. Den praktiske følgen: sammenlign ReplaceCount med antallet treff fra et tidligere søk, og behandle et underskudd som et signal. I dato-eksempelet over må sifferet 6 stå et sted i dokumentets tekst i den samme skriften for at omskrivingen skal lykkes — sannsynlig i en faktura, aldri garantert generelt. Når tegnene du trenger rett og slett ikke er tilgjengelige og målet er å fjerne sensitiv tekst heller enn å omformulere den, er ekte fjerning av innhold uansett det bedre verktøyet; se sladding og omstrukturering av innlastede PDF-er i Delphi for den veien
var
  Matches: THPDFTextMatchArray;
  Expected, Replaced: Integer;
begin
  Pdf.SearchLoadedDocumentText('Acme Corp', True, Matches);
  Expected := Length(Matches);
  Pdf.ReplaceLoadedDocumentText('Acme Corp', 'Apex Corp', True, Replaced);
  if Replaced < Expected then
    WriteLn(Format('%d occurrence(s) skipped: characters missing ' +
      'from the font subset, or match spans multiple operands',
      [Expected - Replaced]));
end;
Den andre hoppebetingelsen i den meldingen er den andre dokumenterte grensen: en søkestreng som strekker seg over flere strengoperander — Hello delt over elementene [(He)(llo)] TJ, for eksempel — blir funnet av søket, fordi søket matcher den dekodede glyfsekvensen, men hoppes over av erstatningen, fordi omskriving på tvers av operandgrenser ville krevd sammenslåing av tilstøtende bytespenn. Å søke og så verifisere gjør begge grensene synlige i stedet for tause
Hva endrer seg i filen når du lagrer?
En erstattet /Contents-strøm lagres ukomprimert. Strømmer komprimert med FlateDecode dekomprimeres for redigering, og når HotPDF skriver de gjenoppbygde bytene, dropper den strømmens /Filter-oppføring og oppdaterer /Length i stedet for å komprimere på nytt. Den resulterende PDF-en er fullt gyldig og gjengis normalt i vanlige visningsprogrammer; motytelsen er en større fil for hver redigerte strøm. For en satsvis løype som behandler tusenvis av dokumenter, budsjetter for den veksten eller kjør en egen komprimeringsomgang nedstrøms. Hvordan omskrevne objekter samvirker med dokumentets kryssreferansestruktur ved lagring er et tema for seg, dekket i objektstrømmer og inkrementelle oppdateringer i HotPDF
Alt annet ved filen får være i fred. Urørte strømmer beholder komprimeringen sin, skrifter og bilder skrives ikke om, og skjøtingen på operandnivå gjør at selv de redigerte strømmene skiller seg fra originalen bare der et treff landet. Den forsiktigheten er bevisst: jo mer av et innlastet dokument et bibliotek skriver om, jo flere muligheter har det til å ødelegge et produsentsærtrekk det ikke forutså
Søk og erstatt av tekst føyer seg til uttrekk, sladding og sidegjengivelse i verktøysettet for innlastede dokumenter i HotPDF, alt drevet av den samme tolkeren for innholdsstrømmer og tilgjengelig fra Delphi 5 til dagens RAD Studio-utgivelser uten eksterne avhengigheter. Den fullstendige API-referansen og prøveversjonen finner du på produktsiden for HotPDF Delphi Component