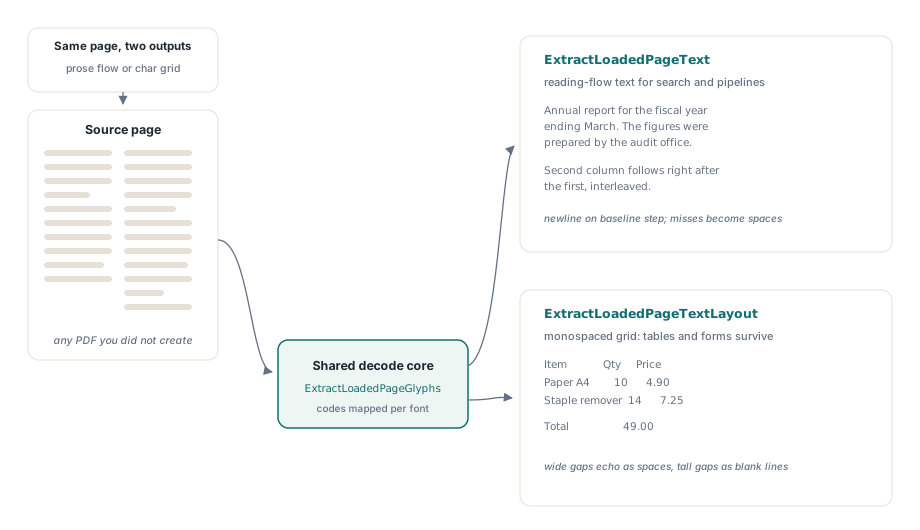
HotPDF Delphi Component trekker ut Unicode-tekst fra enhver PDF du laster inn i Delphi gjennom to kall: ExtractLoadedPageText returnerer teksten i leseflyt på en side, og ExtractLoadedPageTextLayout (kom i v2.263.0) gjenskaper sidens visuelle oppsett som ren tekst, slik at kolonner, innrykk og tabelljustering overlever i resultatet. Begge virker på dokumenter HotPDF ikke har laget, som er tilfellet det faktisk står om: fakturaen en kunde sendte deg på e-post, rapporten et skannebyrå leverte, kontrakten laget av programvare ingen lenger kan sette navn på
Å komme dit krevde mer maskineri enn de to signaturene antyder, for en PDF lagrer ikke tekst slik en tekstfil gjør. Denne artikkelen går gjennom begge uttrekksmodusene og åpner så panseret på de tre delene under — CMap-leseren, tolkeren for innholdsstrømmen og reservekjeden for skriftdekoding — fordi det å vite hvordan avbildningen virker er forskjellen på å trekke på skuldrene av et søppelresultat og å diagnostisere det
Hvorfor er tekstuttrekk vanskeligere enn å lese strenger ut av filen?
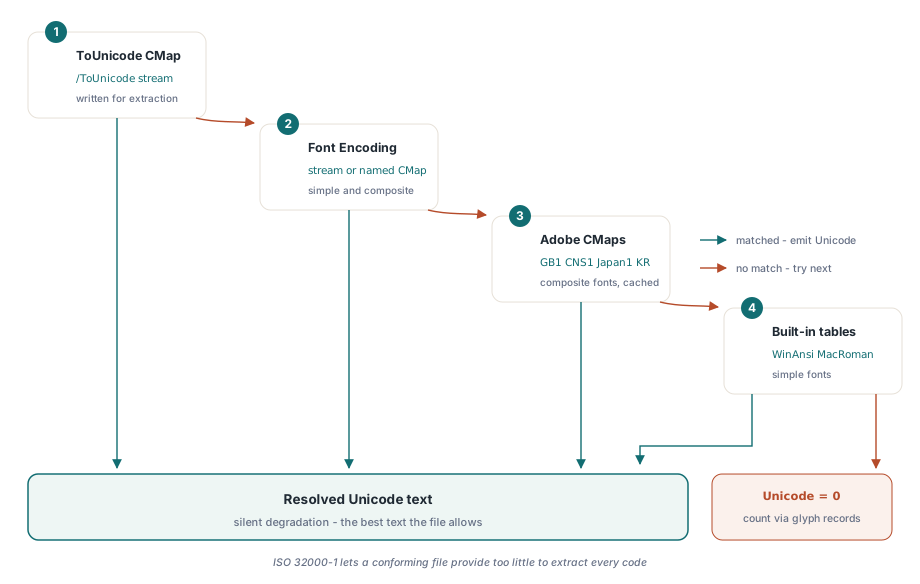
En PDF-innholdsstrøm registrerer tegnkoder, ikke tegn. Operatorene Tj og TJ (ISO 32000-1 §9.4.3) bærer strenger av byte hvis betydning avhenger fullstendig av skriften som er valgt av den foregående Tf: byten 0x41 kan være bokstaven A under WinAnsi, en vilkårlig glyf i en delmengdeskrift, eller halvparten av en tobyters CID i en sammensatt CJK-skrift. ISO 32000-1 §9.10 definerer tekstuttrekk som nøyaktig dette dekodingsproblemet — å avbilde hver kode tilbake til Unicode ved hjelp av den informasjonen skriftordboken gir — og standarden er tydelig på at en konform fil ikke er pålagt å gi nok informasjon til å gjøre det
Den siste setningen forklarer hver eneste feilrapport om "hvorfor gir kopier og lim inn fra denne PDF-en bare vrøvl" du noen gang har sett. En produsent som bygger inn en delmengdeskrift uten /ToUnicode-tabell, har skrevet en fil som gjengis perfekt og trekkes ut som tull, fordi avbildningen fra kode til glyf finnes, mens avbildningen fra kode til Unicode aldri ble levert. Ethvert ærlig uttrekks-API er derfor en kjede av beste forsøk, og det nyttige spørsmålet er hvor dypt kjeden går
Uttrekk i leseflyt med ExtractLoadedPageText
For søkeindeksering, nøkkelordtreff eller å mate tekst inn i en analyseløype er ExtractLoadedPageText kallet du vil ha. Signaturen er function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean — sideindekser er nullbaserte, resultatet kommer som en nativ Delphi-UnicodeString, og funksjonen returnerer False når siden ikke har noen lesbar innholdsstrøm, i stedet for å kaste et unntak
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
    // AllText inneholder nå dokumentets tekst i leseflyt
  finally
    Pdf.Free;
  end;
end;
Linjeskiftene i resultatet kommer fra en bevisst enkel heuristikk: når en glyfs loddrette origo flytter seg mer enn halvparten av gjeldende skriftstørrelse — signaturen til et Td- eller T*-steg i innholdsstrømmen — settes det inn et linjeskift. Tegn dekoderen ikke klarer å løse opp, blir mellomrom i stedet for å forsvinne, så ordgrenser overlever selv når enkeltglyfer ikke gjør det. Det denne modusen ikke forsøker seg på, er gruppering etter leserekkefølge eller gjenkjenning av flere spalter: en side med to spalter kommer ut flettet i innholdsstrømmens rekkefølge, som vanligvis, men ikke alltid, er den visuelle rekkefølgen
Når bør du bruke layoutbevarende uttrekk i stedet?
ExtractLoadedPageTextLayout er riktig kall når posisjonen bærer mening: tabeller, skjemaer, kodelistinger, alt du har tenkt å diffe, greppe eller tolke kolonnevis. I stedet for å flate glyfene ut i en strøm, grupperer den dem i grunnlinjer, sorterer hver grunnlinje etter X, og gjenskaper vannrett og loddrett tomrom på et rutenett av tegn med fast bredde, dimensjonert ut fra median glyfframføring og skriftstørrelse. Brede mellomrom mellom sekvenser på samme grunnlinje blir rekker av mellomrom; store hull mellom grunnlinjer blir blanke linjer. Resultatet leses slik siden ser ut
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Kolonner, innrykk og tabelljustering overlever som
  // mellomrom og blanke linjer på et rutenett av tegn
end;
De to modusene deler hver eneste byte av dekodemaskineriet og skiller seg bare i hvordan de ordner de dekodede glyfene, så valget koster ingenting i troskap. Velg ExtractLoadedPageText når bare ordene betyr noe, og ExtractLoadedPageTextLayout når oppsettet gjør det. Gjenkjenning av leserekkefølge over flere spalter er fortsatt utenfor omfanget for begge — en rutenettgjengivelse av en tospaltet side viser deg begge spaltene side om side, trofast, noe som for diffing er nøyaktig riktig og for gjenflyting av brødtekst ikke er det
Hvordan dekoder HotPDF tegnkoder til Unicode?
HotPDF Delphi Component løser hver tegnkode gjennom en prioritert reservekjede: først skriftens innebygde /ToUnicode-CMap, så /Encoding-oppføringen (strøm eller navngitt CMap), deretter — for sammensatte skrifter — Adobes standard-CMap-filer for tegnsamlinger som Adobe-GB1, Adobe-CNS1, Adobe-Japan1 og Adobe-KR, og til slutt de innebygde WinAnsi- og MacRoman-tabellene for enkle skrifter. En strategi som ikke kan levere et svar, degraderer stille til den neste i stedet for å kaste et unntak, og en kode som tømmer hele kjeden løses til 0, slik at kalleren kan telle bom i stedet for å gjette
/ToUnicode-CMap-en (ISO 32000-1 §9.10.3) kommer først fordi det er den ene avbildningen produsenten skrev nettopp for uttrekk. Stien via Adobes standard-CMap-er betyr noe for CJK-dokumenter som bruker forhåndsdefinerte CMap-er som UniGB-UTF16-H i stedet for å bygge inn noe: HotPDF leverer samlingsfilene under resources\CMap-katalogen sin, finner dem relativt til den kjørbare filen under kjøring, og hurtiglagrer hvert tolket kart per prosess — verdt å vite fordi den største av dem, Adobe-GB1-kartet, er omtrent 2 MB kildetekst du ikke vil tolke på nytt for hver side. Er katalogen fraværende, hopper dekoderen ganske enkelt over CMap-er fra disk og arbeider med innebygde tabeller pluss de innebygde kodingene. Dette er lesesidens speilbilde av formingsproblemet som er dekket i tekstforming for komplekse skriftsystemer med HotPDF, der det samme skillet mellom kode og glyf møtes på skrivetidspunktet
To CMap-syntaksfeller det er verdt å kjenne
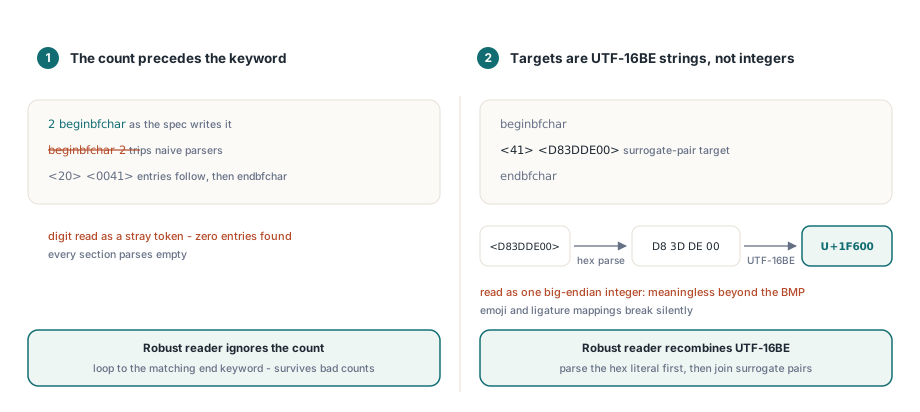
CMap-filer ser trivielle ut å tolke og er det ikke, og to detaljer står for de fleste mislykkede første forsøkene på en tolker. Den første er at antallet poster kommer før seksjonsnøkkelordet: en seksjon leses som 2 beginbfchar, ikke beginbfchar 2. En tolker som venter antallet etter nøkkelordet, sluker tallet som et løst symbol og finner så null oppføringer i hver seksjon. Den robuste framgangsmåten — den HotPDFs leser landet på — er å ignorere antallet helt og gå i løkke til det tilhørende nøkkelordet endbfchar / endbfrange, noe som i tillegg tåler virkelige filer der antallet rett og slett er feil
Den andre fellen er at målene i bfchar og bfrange er UTF-16BE-strenger, ikke heltall. Målet <D83DDE00> betyr U+1F600 — et surrogatpar som må settes sammen igjen til ett kodepunkt — og å lese de fire bytene som et big-endian-heltall gir en meningsløs verdi for hvert kodepunkt utenfor Basic Multilingual Plane. Emoji i PDF-er er ikke lenger eksotisk, så en dekoder som hopper over sammensetting av surrogater, feiler på filer brukerne dine faktisk har. HotPDF tolker den heksadesimale literalen til rå byte først, og setter så sammen UTF-16BE-kodeenhetene, noe som også dekker målene på flere tegn som ligaturavbildninger gir
Ned på glyfnivå med ExtractLoadedPageGlyphs
Begge tekstkallene er bygget på ExtractLoadedPageGlyphs, og det underliggende THPDFGlyphArray er tilgjengelig for koden din også. Hver THPDFGlyphRecord bærer det oppløste Unicode-kodepunktet ved siden av den rå tegnkoden, kodens bytebredde (1, 2 eller 4, avgjort av codespacerange i CMap-en), den aktive skriftressursnøkkelen og -størrelsen, X- og Y-origo i brukerrommet, og den vannrette framføringen. Det er nok til å bygge gjenkjenning av ordgrenser, posisjonert utheving eller en egen layoutalgoritme uten at du selv rører innholdsstrømmen
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Å telle poster med Unicode = 0, som over, er den ærlige måten å måle uttrekkskvaliteten på et gitt dokument før du stoler på teksten videre. Glyfpostene forankrer også hvert tegn til kildeoperanden i innholdsstrømmen, og det er det som gjør søk og erstatt i innlastede dokumenter mulig i HotPDF oppå det samme fundamentet
Hvilke PDF-er gir ikke fra seg teksten sin?
Noen filer beseirer enhver uttrekker, og det er bedre å oppdage dem enn å sende resultatet videre. Skannede dokumenter er det enkleste tilfellet: en side som er ett stort bilde inneholder ingen tekstoperatorer i det hele tatt, så uttrekket returnerer korrekt en tom streng — løsningen er OCR, og å trekke ut sidebildene fra den innlastede PDF-en er første steg i den løypa. Delmengdeskrifter uten /ToUnicode-tabell er det vanskeligere tilfellet: kommer også /Encoding-stien og standard-CMap-ene tomme tilbake, løses de glyfene til 0 og dukker opp som mellomrom i tekstkallene. Krypterte dokumenter trekkes ut som normalt, forutsatt at du laster dem inn med passordet via overlasten av LoadFromFile, slik at strømmene er dekryptert før tolkeren i det hele tatt ser dem
Én smalere begrensning er verdt å si rett ut: dekodekjeden leser CMap- og innholdsstrømmer gjennom Flate-stien i HotPDF, så en skrift der ToUnicode-strømmen bruker et uvanlig filter, degraderer til neste strategi i stedet for å felle siden. I praksis dekker FlateDecode nesten alt som er produsert de siste to tiårene, og degraderingen er stille med vilje — du får den beste teksten filen tillater i stedet for et unntak. Det samme objektmaskineriet på lesesiden som løser opp skriftordbøker her, driver også redigering av metadata på innlastede dokumenter, så en løype for dokumentmottak kan trekke ut, inspisere og annotere i én omgang
Tekstuttrekk, layoutbevarende gjengivelse, tilgang på glyfnivå og funksjonene for søk og erstatt som er bygget på dem, er alle en del av standardutgaven av HotPDF Delphi Component for Delphi og C++Builder — ingen eksterne DLL-er, ingen teksttjenester fra operativsystemet, bare Object Pascal du kan steppe gjennom når en merkelig fil lander i køen din