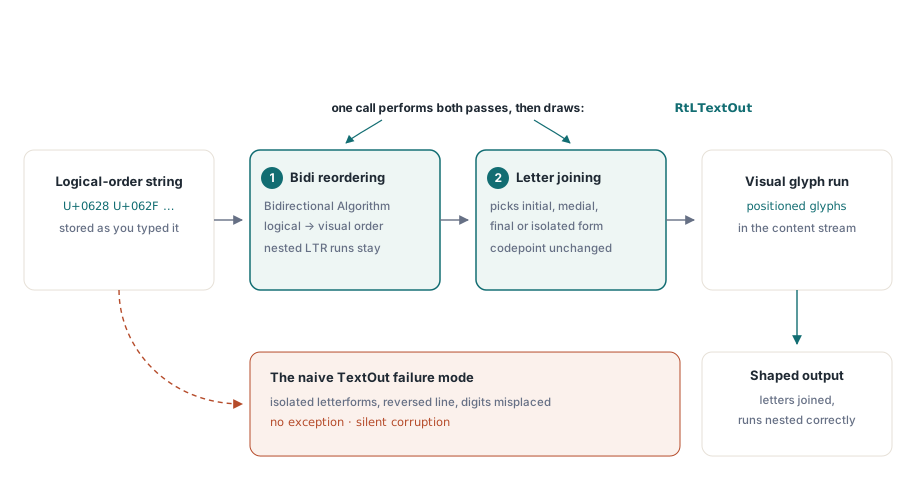
Send den arabiske frasen يوضح ملف PDF til TextOut, og åpne resultatet. Bokstavene går feil vei, og hver av dem står i sin isolerte form med et synlig mellomrom foran den neste, som om noen skrev engelsk baklengs og trykket mellomrom mellom hvert tegn. Ingen feilmelding utløses. Ingen advarsel skrives ut. Resultatet er ganske enkelt feil, og det er feil fordi to separate transformasjoner som arabisk er avhengig av, aldri fant sted. Å vite hva disse to transformasjonene er, og hvilket kall som utfører dem, er det meste av hva PDF-utdata for komplekse skript handler om
HotPDF er en native VCL PDF-komponent for Delphi og C++Builder, og den gjør høyre-til-venstre-arbeidet for deg gjennom et eget kall. Den stopper også opp på noen få bestemte steder som du bør kjenne til før du forplikter deg til et språk, så denne artikkelen kartlegger begrepene og de ærlige begrensningene; det praktiske oppsettet for selve kallet finner du i referanseartikkelen om RtLTextOut
Hvorfor en korrekt streng likevel skrives ut feil
Unicode holder tekst i logisk rekkefølge, den rekkefølgen du skriver den i og leser den høyt i. En renderer må plassere glyffer i visuell rekkefølge. For venstre-til-høyre-skript faller disse rekkefølgene sammen, og ingen tenker på det. For arabisk og hebraisk gjør de ikke det, og når én linje blander retninger — for eksempel en arabisk setning som inneholder det latinske ordet «PDF», eller en pris skrevet med sifre — avgjør Unicodes bidireksjonale algoritme (UAX #9) nøyaktig hvordan de venstre-til-høyre-fragmentene skal nøstes inn i den høyre-til-venstre-linjen. Det er den første transformasjonen, omordning, og å hoppe over den er det som snur linjen
Den andre er kontekstuell forming. En arabisk bokstav tegnes forskjellig avhengig av hvor den befinner seg i et ord: innledende, midtstilt, avsluttende, eller stående alene. Kodepunktet forblir det samme hele veien; bare glyffen endres. En rørledning som sender hvert kodepunkt rett til standardglyffen, produserer nøyaktig det frakoblede, isolerte resultatet fra det innledende avsnittet. Hebraisk hopper over dette trinnet, siden bokstavene ikke kobles sammen, men trenger likevel omordningen. Arabisk trenger begge deler, og det er derfor arabisk, ikke hebraisk, er strengen du tester med
På skrivebordet er ingenting av dette ditt problem. Når et VCL-skjema tegner arabisk inn i en TEdit, omordner og former operativsystemets tekststabel den stille og rolig, og det er nettopp derfor strengen som ser perfekt ut på skjermen, kommer ut ødelagt i en naiv PDF. En innholdsstrøm lagrer ikke redigerbar tekst. Den lagrer posisjonerte glyffer, så den som genererer strømmen, arver formingsjobben som operativsystemet pleide å ta seg av. RtLTextOut er kallet som tar tilbake den jobben
Hva RtLTextOut former for deg
HotPDF holder den latinske stien og den komplekse-skript-stien som to forskjellige metoder. TextOut skriver ut det du gir den, i den rekkefølgen du gir det. RtLTextOut utfører begge transformasjonene først — bidireksjonal omordning over hele linjen, kontekstuell analyse for de sammenkoblende skriftene — og skriver deretter ut. Hvilke skriptregler som gjelder, formidles inn gjennom fontens charset i stedet for gjennom selve kallet, så retning er et eksplisitt valg ved hvert kallsted i stedet for en gjetning basert på tegnene. Det parameter-for-parameter oppsettet, charset-verdiene, trinnene for fontregistrering, og et komplett kompilerbart eksempel finnes alle i referanseartikkelen om RtLTextOut; denne artikkelen holder seg til hva transformasjonene betyr, hvor de stopper, og hvordan du beviser at de fungerte
Én bruksregel er viktig selv på dette nivået: inndataene må være i logisk rekkefølge, fordi RtLTextOut utfører selve reverseringen, og en streng du allerede har snudd for hånd, kommer ut dobbeltreversert — referanseartikkelen går gjennom denne fellen og opprydningen etter den. Det som gjør fellen verdt å nevne her, er hvorfor den overlever testing. En dobbeltreversert, rent arabisk streng kan se helt korrekt ut, og bryter først sammen når en linje inneholder et latinsk ord eller et tall, fordi de innebygde forekomstene da ikke lenger nøstes slik UAX #9 krever. Feilen ligger ikke i renderingen; den ligger i å mate algoritmen med tekst som allerede var halvveis behandlet
Den samme oppførselen med blandet retning snubler opp anmeldere mer enn den snubler opp kode. Inne i en høyre-til-venstre-linje leses tall og innebygde latinske ord fortsatt fra venstre til høyre. Noen som ikke har jobbet med bidireksjonalt oppsett, vil se på en rendret faktura, se kontonummeret lese «feil» vei i forhold til det arabiske rundt det, og melde det inn som en feil. Det er det spesifikasjonskorrekte resultatet. En kort merknad i akseptansekriteriene dine, skrevet før den første gjennomgangen av en morsmålsbruker, sparer deg for den runden
Når omordning og sammenkobling er nok, og når de ikke er det
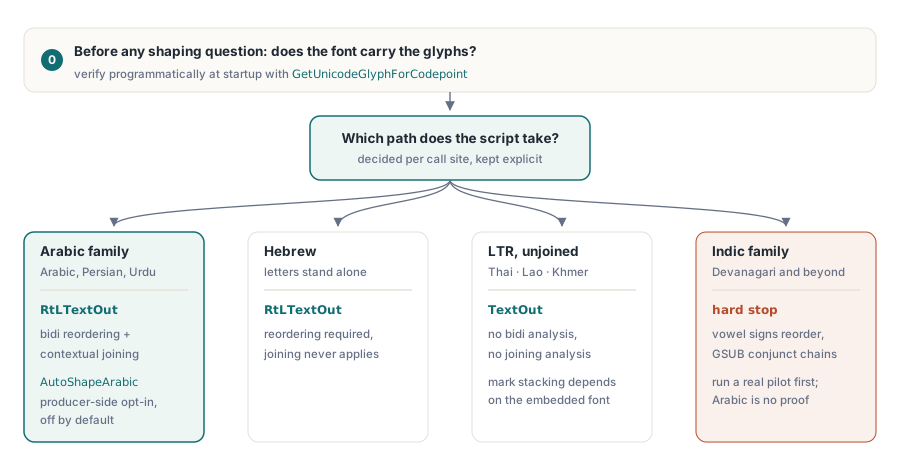
For løpende tekst på arabisk og hebraisk — rapporter, fakturaer, kontrakter, brev — er omordning pluss kontekstuell sammenkobling hele jobben, og RtLTextOut bærer den alene. Grensen dukker opp når typografien krever mer enn sammenkobling. HotPDFs svar på arabisk-siden er en valgfri, produsentsidebasert former: sett AutoShapeArabic := True, og komponenten skriver om den logisk ordnede forekomsten til Unicode-presentasjonsformer før det bidireksjonale trinnet, slik at sammenkoblingsformer beregnes mot logiske naboer og ligaturfoldinger bakes inn i kodepunktene som PDF-en faktisk bærer, i stedet for å overlates til en fremviser å løse. Bryteren er av som standard, og resultatet er byte-stabilt når den forblir av, så å slå den på er en bevisst beslutning per dokumentrørledning, ikke en global oppgradering. Den samme opt-in-modellen gjelder for de andre sammenkoblende høyre-til-venstre-skriftene HotPDF former: syrisk, N'Ko, adlam og hanifi rohingya har hver sitt eget auto-shape-flagg som speiler det arabiske
Valgfrie OpenType-funksjoner er igjen en annen mekanisme. Diskresjonære ligaturer og lignende enkeltsubstitusjonsfunksjoner går gjennom GetSingleSubstituteGlyph(GID, 'liga'), som løser én substitusjon om gangen — inndataglyff-ID først, funksjonstag deretter — og returnerer inndataglyffen uendret når funksjonen ikke gjelder. Det er nok til å drive en kjent, endelig ligaturliste du vedlikeholder selv. Det er ikke en full GSUB-motor, og forskjellen er nøyaktig der ambisiøse lokaliseringsplaner går galt: en formingsrørledning som håndterer arabisk feilfritt, har demonstrert omordning og sammenkobling, ikke noe mer
Dekning på tvers av skrift
Arabisk øver på begge transformasjonene, og det er derfor det er strengen du bør teste med, og hvorfor en arabisk gjennomgang er det sterkeste enkeltbeviset på at rørledningen fungerer. Hebraisk trenger omordningen, men ikke sammenkoblingen, siden bokstavene står for seg selv; hvis hebraisk rendres korrekt, men arabisk kommer ut frakoblet, er den bidireksjonale halvparten i orden, og den kontekstuelle halvparten kjørte aldri. Persisk og urdu bruker det arabiske skriftet og arver oppførselen dets, selv om urdus preferanse for nastaliq-stilen er en fontbeslutning med lesbarhetskonsekvenser en morsmålsbruker bør vurdere
Thai befinner seg helt på den andre siden av linjen. Det leses fra venstre til høyre, så det trenger ikke bidireksjonalt arbeid, og bokstavene kobles ikke sammen, så det trenger ingen kontekstuell analyse; thailandske strenger går gjennom den ordinære TextOut-stien akkurat som latin. Det thai derimot har, er stablede merker — vokal- og tonemerker over og under grunnkonsonanten — og om disse sitter riktig, avhenger av om fonten er bygget slik at de kombinerende merkene stables uten hjelp fra en formingsmotor. De fleste dedikerte thai-fonter gjør det. Test med den nøyaktige fonten du skal bygge inn, ikke en som bare ligner
Devanagari og resten av den indiske skriftfamilien er det ærlige stoppunktet. Vokaltegnene deres omordnes rundt konsonantklynger, og konjunktene deres dannes gjennom kjeder av kontekstavhengige substitusjoner, som er fullt GSUB-territorium, langt utover omordning og sammenkobling. Hvis et indisk språk står på veikartet, kjør en ekte pilot på ekte kundestrenger før du lover det — at arabisk fungerer, er ikke bevis på at devanagari vil gjøre det. CJK-strenger, vietnamesisk med sine stablede diakritiske tegn, og blandet europeisk tekst går alle gjennom den ordinære stien uten bidireksjonal analyse, og det lønner seg å holde de to stiene fysisk atskilt i rapportkoden, én rutine for RTL-forekomster og én for alt annet, slik at lokaliseringslogikken er synlig ved kallstedet i stedet for skjult bak et flagg noen glemmer å sette
Glyffdekning avgjøres før formingen i det hele tatt kjører
Forming velger glyffer fra en font. Hvis fonten ikke inneholder dem, er det ingenting å velge, og det er derfor den klassiske utrullingsfeilen — feilfri på utviklerens maskin, tomme bokser på kundens server etter en stille fontutbytting — er et dekningsproblem, ikke et formingsproblem. Den praktiske kuren, å registrere en font du sender med i stedet for å stole på det maskinen tilfeldigvis har installert, blir gjennomgått trinn for trinn i referanseartikkelen. Det konseptuelle poenget er at dekning må være etablert før noe formingsspørsmål i det hele tatt er meningsfullt, og at det kan etableres programmatisk i stedet for ved å se på resultatet med øynene
// Etter RegisterUnicodeTTF, kontroller dekningen for
// kodepunktene dataene dine faktisk bruker
GID := Pdf.GetUnicodeGlyphForCodepoint($0628);  // U+0628 ARABISK BOKSTAV BEH
LogGlyphAudit($0628, GID);
Selve registreringen medfører to begrensninger — et PDF 1.5-gulv for håndtering av innebygd Unicode, og fontens bits for innbyggingstillatelse — begge dekket sammen med oppsettstrinnene i referanseartikkelen om RtLTextOut. Det som hører hjemme her, er revisjonsvanen: GetUnicodeGlyphForCodepoint er ditt tidligvarslingssystem. Gå gjennom kodepunktområdene dataene dine faktisk bruker når tjenesten starter opp, og logg hvilke glyff-ID-er som kommer tilbake. Et dekningshull viser seg da som en linje i en oppstartslogg under utrulling, i stedet for som manglende tegn i en faktura som allerede har nådd en kunde
Leserekkefølgen tilhører dokumentet, ikke glyffene
Å få hver eneste glyff riktig etterlater fortsatt én ting ugjort. ISO 32000-1 §12.2 definerer en fremviserpreferanse kalt /Direction, som angir dokumentets overordnede leserekkefølge. Den berører ingen glyffer. Det den gjør, er å fortelle en fremviser hvordan den skal ordne toppslåtte oppslag, hvilken side et motstående-side-oppsett skal starte fra, og hvilken vei leseskjermbildet skal helle. Ingenting av dette vises på én enkelt side, og det er nøyaktig derfor det blir glemt
// Erklær høyre-til-venstre leserekkefølge på dokumentnivå
Pdf.Direction := RightToLeft;  // legger vpDirection til ViewerPreferences
Å sette Direction er hele jobben: egenskapens setter legger til vpDirection i dokumentets ViewerPreferences, så én linje bærer preferansen inn i filen. Hvis teksten går ut gjennom RtLTextOut, får du dette gratis, fordi kallet snur dokumentretningen som en bieffekt — referanseartikkelen dekker når et blandet dokument trenger å få dette reversert. Tilfellet der du må sette det selv, er et høyre-til-venstre-dokument produsert på en annen måte, for eksempel fra inndata du allerede har formet oppstrøms og tegnet gjennom den ordinære stien. La det stå slik, og det ensidige beviset du stirrer på, ser identisk ut uansett; så skriver noen ut et duplekshefte, oppslagene kommer ut speilvendt, og årsaken er en manglende énlinjer fra uker tidligere
Verifisere formet utdata
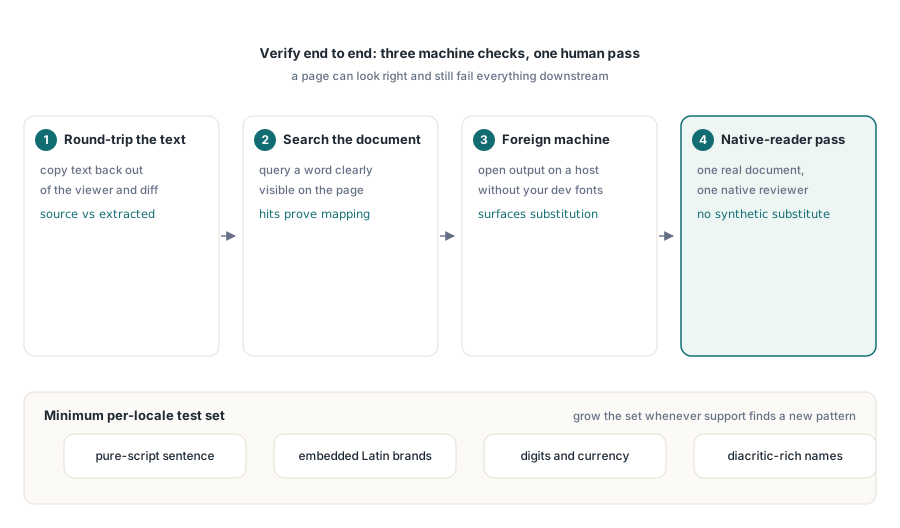
Verifiser fra ende til annen, fordi en side kan se korrekt ut og likevel være ubrukelig for alt nedstrøms. Tre kontroller finner de fleste problemene. Kopier teksten tilbake ut av Acrobat, og sammenlign kodepunktene med kildestrengen din. Kjør fremviserens søk i dokumentet etter et ord du kan se på siden. Og åpne resultatet på en maskin som ikke har utviklingsfontene dine, den som er mest sannsynlig å avsløre en utbytting. Ingenting av dette erstatter en morsmålsbruker som ser på ett ekte dokument, noe som fanger opp ting ingen syntetisk korpus vil. Få den gjennomgangen inn i kalenderen før formatet sendes ut
Velg teststrenger med hensikt i stedet for å gjenbruke hva enn en oversetter sendte i fjor. Et brukbart minimum per språk: en setning i rent skript, en setning med innebygde latinske merkenavn, en linje med sifre og valuta, og navn med diakritiske tegn eller kombinerende merker. Ekte kundenavn bryter antakelser som fyllstoff-tekst lar stå urørt, så la regresjonssettet vokse med én streng hver gang en supportsak avdekker et mønster du ikke hadde sett før
Fontregistrering, delmengdedannelse, og den daglige API-en for tekst-tegning er dekket i artikkelen om rapportutdata, fonter og bilder med HotPDF. Når de samme dokumentene også må oppfylle tilgjengelighetsprofiler, bygger språktaggingen og strukturreglene i artikkelen om PDF/A- og PDF/UA-validering videre på formingsarbeidet her
De høyre-til-venstre- og Unicode-font-API-ene beskrevet ovenfor følger med HotPDF Delphi Component for Delphi og C++Builder; produktsiden lenker til den fullstendige tekstutdata-referansen