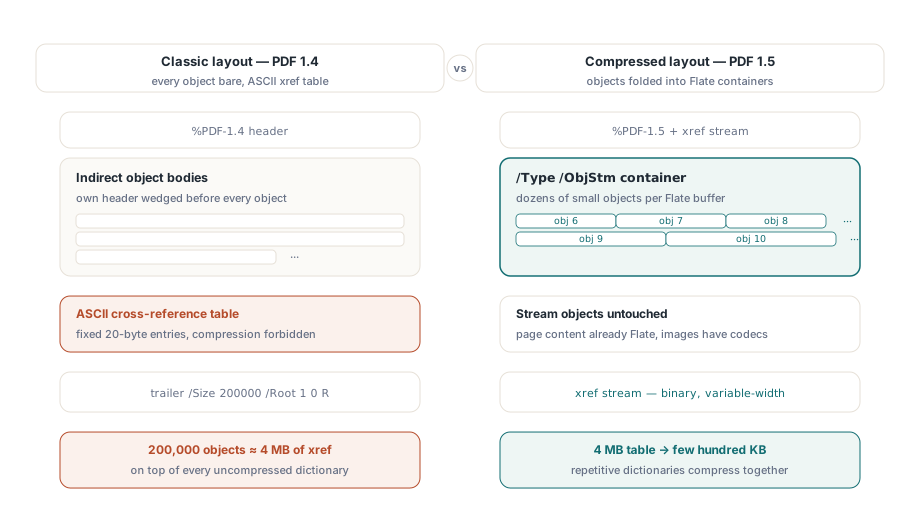
PDF 1.5 introduserte to lagringsstrukturer det eldre filformatet ikke hadde noen måte å uttrykke på: objektstrømmen og kryssreferansestrømmen. En objektstrøm er én Flate-komprimert beholder, merket /Type /ObjStm, som holder mange små indirekte objekter pakket ende til ende i stedet for å spre dem utover filkroppen. En kryssreferansestrøm er filens oppslagstabell skrevet om som komprimert binærdata med felt av variabel bredde, i stedet for ASCII-tabellen med fast bredde som avsluttet hver eneste PDF frem til versjon 1.4. De reiser sammen. Når objekter først er foldet inn i en strøm, kan den gamle tekst-tabellen ikke lenger adressere dem, så den binære xref-en må følge med
Sett dette opp mot den klassiske layouten, og kostnaden den fjerner, er lett å se. I en PDF 1.4-fil sitter hvert indirekte objekt ukomprimert bak sin egen obj-header, og tabellen på slutten bruker nøyaktig 20 byte ASCII per oppføring, komprimering forbudt. Et dokument med 200 000 objekter bærer med seg rundt 4 MB kryssreferansedata før et eneste glyf er tegnet, med alle de ukomprimerte dictionary-kroppene lagt oppå. PDF 1.5 angriper begge tallene på én gang: dictionary-ene foldes inn i Flate-beholdere, og den 4 MB store tabellen krymper til noen hundre kilobyte binærdata. ISO 32000-1 definerer de to strukturene i §7.5.7 og §7.5.8
Hvor besparelsen faktisk havner
Objektstrømmer rører kun ikke-strøm-objekter, så de komprimerer struktur, ikke piksler. Sideinnhold var allerede Flate-komprimert før 1.5, og bildedata bærer sine egne kodeker, noe som er grunnen til at en bildetung brosjyre knapt rører seg. Filene som kollapser i størrelse, er de strukturtunge: AcroForms med tusenvis av felt-dictionaries, dype disposisjonstrær, tagged-PDF-strukturelementer. Disse objektene er små, tallrike og nesten identiske med hverandre, og denne repetisjonen er akkurat det Flate utnytter når de først sitter i én enkelt buffer i stedet for spredt utover kroppen med headere kilt inn mellom dem
Det er lett å undervurdere hvor mye av en gammel fil som er overhead. Et skjemaarkiv som har absorbert år med redigeringer, kan bruke godt over halvparten av bytene sine på dictionary-headere, xref-utfylling og revisjoner ingen leser noensinne vil se på. De to funksjonene her gjenvinner de to første av disse. Den tredje, akkumulerte revisjoner, gir bare etter for komprimering, når filen ikke lenger trenger å huske sin egen historie
I HotPDF slår du på begge gjennom et par egenskaper, og hvordan de avhenger av hverandre, betyr mer enn rekkefølgen du skriver dem i:
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'catalog-2026.pdf';
    Pdf.UseXRefStream := True;      // binær xref, forutsetning for ObjStm
    Pdf.UseObjectStreams := True;   // pakk objekter inn i /Type /ObjStm
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 11);
    Pdf.CurrentPage.TextOut(50, 760, 0, 'Compressed structure demo');
    Pdf.EndDoc;                     // genererer XRefStm + ObjStm-beholdere
  finally
    Pdf.Free;
  end;
end;
UseObjectStreams krever at UseXRefStream er satt til True. Et komprimert objekt nås gjennom en type-2 xref-oppføring, som registrerer et objektstrømnummer pluss en indeks, og en klassisk 20-byte tekstrad har ingen plass til å lagre det paret. Så UseObjectStreams alene gjør ingenting synlig; begge flaggene, satt før BeginDoc, er konfigurasjonen som fungerer. Setter du dem etter BeginDoc, har HotPDF allerede forpliktet seg til den eldre layouten
Hvorfor begge er avslått som standard
HotPDF lar begge egenskapene stå på False rett ut av esken, og grunnen viser seg i integrasjoner med gammel nedstrømskode. En leser som bare forstår PDF 1.4, kunngjør ikke at den ikke kan håndtere komprimerte objekter. Den møter en xref-strøm, finner ingen av trailer-nøkkelordene den forventer, og rapporterer en skadet kryssreferansetabell eller nekter rett og slett å åpne filen. Hvis outputen din flyter inn i en aldrende faksgateway, en maskinvareskriver som kjører en innebygd fortolker, eller en parser noen skrev mot 1.4-spesifikasjonen for et tiår siden, la begge flaggene stå av for den kanalen og lev med den større filen. For arkivlagring og webdistribusjon, der hver gjengs viser har lest PDF 1.5 i tjue år, er det å slå dem på komprimering du får nesten gratis
Det finnes en andreordens effekt som er verdt å fortelle supportteamet ditt om. Når dictionary-er først er pakket inn i objektstrømmer, slutter det å bety noe å sammenligne to genererte filer byte for byte, fordi en endring i ett enkelt felt kan re-Flate-komprimere en hel beholder og stokke om alt som følger etter den. Diff slike filer etter objektinnhold, ikke med en binær sammenligning
Inkrementelle oppdateringer og byteoffsetene de beskytter
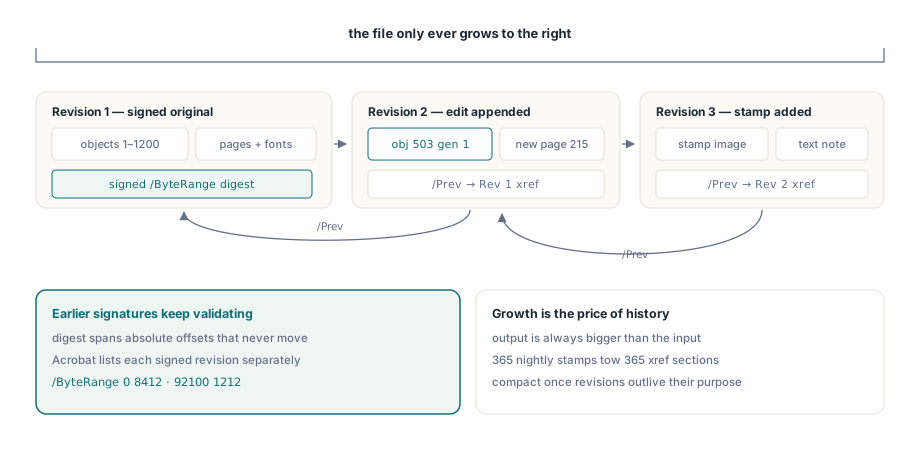
En digital signatur dekker en eksplisitt /ByteRange: to strekninger av den fysiske filen, oppgitt som absolutte byteoffsetter, som CMS-digest-en ble tatt over. Skriv om filen, selv til noe som ser identisk ut på skjermen, og alle disse offsetene flytter seg. Digest-en slutter å stemme, og signaturen leses som ødelagt. Det er akkurat det problemet ISO 32000-1 §7.5.6 løser med inkrementelle oppdateringer. Nye og endrede objekter legges til etter den eksisterende %%EOF, og deretter skrives en fersk kryssreferanseseksjon hvis /Prev-oppføring peker tilbake til den forrige. De opprinnelige bytene forstyrres aldri, så en signert revisjon forblir verifiserbar, og Acrobat kan presentere hver signerte revisjon for seg i signaturpanelet
HotPDF eksponerer dette gjennom sitt eget inngangspunkt:
Pdf.BeginIncrementalUpdate('contract-signed.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Addendum recorded 2026-06-11');
Pdf.SaveIncrementalUpdate('contract-updated.pdf');  // legger kun til deltaet
To ting snubler folk over. BeginIncrementalUpdate må motta det opprinnelige filnavnet, fordi den tillagte xref-seksjonen registrerer offsetter som bare er meningsfulle mot akkurat de opprinnelige bytene; peker du den mot en omdøpt eller på nytt lagret kopi, beskriver offsetene en fil som ikke lenger finnes. Og lagringen er kun-tillegg av konstruksjon, så outputen er alltid større enn inndataen. Den veksten er ikke sløsing som skal tunes bort. Det er den samme egenskapen som lar tidligere signerte revisjoner forbli intakte
Å endre en innlastet fil går gjennom LoadFromFile
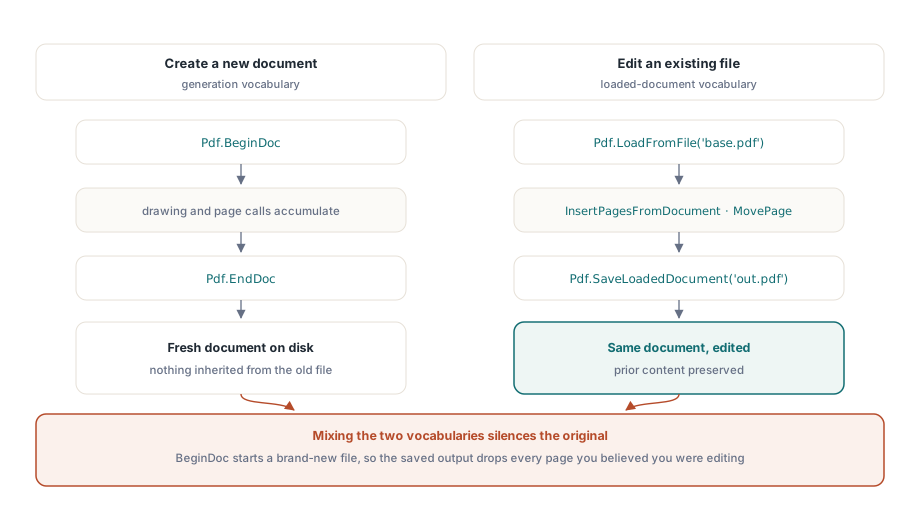
Utviklere som først møtte HotPDF gjennom genererings-API-et, har en tendens til å treffe en bestemt vegg. BeginDoc åpner et helt nytt dokument, som er feil verktøy når du egentlig vil endre et som allerede finnes. Redigering av en eksisterende fil går i stedet gjennom kallene for innlastede dokumenter:
PageCount := Pdf.LoadFromFile('base.pdf');
Pdf.InsertPagesFromDocument(OtherDoc, '1-3', 5);  // sidene 1-3 etter side 5
Pdf.MovePage(2, 5);
Pdf.SaveLoadedDocument('modified.pdf');
Blander du de to, blir symptomet en outputfil som inneholder det nye innholdet ditt og ingenting av originalen, fordi BeginDoc muntert bygde et helt nytt dokument ved siden av det du trodde du redigerte. Les LoadFromFile sammen med SaveLoadedDocument som ett vokabular, og BeginDoc sammen med EndDoc som et annet. En rutine som griper til begge mot samme fil, tar nesten alltid feil
Når du bør komprimere en fil med tillegg
Kun-tillegg-lagring bærer med seg en langsom kostnad. En nattlig jobb som stempler én statuslinje inn i den samme PDF-en, produserer 365 revisjoner i løpet av et år, og hver revisjon drar en ny xref-seksjon med seg. Når den historikken har utspilt sin nytte, og ingen signatur i filen trenger å overleve, kan du flate ut hele greia ved å reserialisere den gjennom veien for innlastede dokumenter:
Pdf.LoadFromFile('stamped.pdf');
Pdf.SaveLoadedDocument('compacted.pdf');
Denne omlagringen er en full omskriving. Den kaster med vilje bort de tidligere revisjonene og ødelegger enhver signatur som fortsatt er i filen, så plasser den bak den samme policy-porten du bruker for ethvert annet destruktivt trinn. Én produksjonsregel som holder stand: komprimer når revisjonsantallet passerer en terskel, eller når den tillagte overheaden vokser forbi en viss andel av grunnfilen, og komprimer aldri et dokument hvis signaturpanel har noe som helst i seg
Å kontrollere outputen før den sendes
Å verifisere dette funksjonsparet er forfriskende konkret. Åpne resultatet i Adobe Acrobat og bekreft tre punkter: dokumentegenskapene rapporterer PDF 1.5 eller nyere når objektstrømmer er slått på; signaturpanelet validerer fortsatt hver tidligere signerte revisjon etter en inkrementell oppdatering; og sidetall og bokmerker kom uskadd gjennom en syklus med innlasting, endring og lagring. For arkivoutput, kjør filen gjennom veraPDF også, siden en komprimert xref er nøyaktig den typen struktur en streng validator gransker nøyere enn en overbærende viser noensinne vil gjøre. Hvis arbeidet ditt også involverer svært store inndata, samspiller inspeksjonsmetodene i vår gjennomgang av Direct File API-et for store PDF-arbeidsflyter naturlig med inkrementell lagring, og signaturmekanikken bak byteområdene ovenfor behandles i dybden i artikkelen om HotPDF digitale signaturer og PAdES
Begge funksjonene følger med som en del av HotPDF Delphi Component for Delphi og C++Builder, ved siden av API-ene for generering, skjema, kryptering og signering som dekkes andre steder på denne bloggen. Produktsiden lenker til den fullstendige API-referansen hvis du vil sammenligne kallene ovenfor mot din egen dokumentpipeline