Het zoekvenster van een viewer licht "Acme Corp" op pagina 2 van een factuur op, maar een bytesearch in de gedecomprimeerde paginastroom naar dezelfde negen tekens komt leeg terug. Alleen voor het eerste woord kan de stroom iets als <0024004600500048> Tj bevatten: two-byte glyph-codes in een ingesloten subsetfont, met de opening tussen de twee woorden geproduceerd door een positioneringsoffset in plaats van een spatie. Die naam vervangen betekent die codes decoderen naar Unicode, daar matchen, teruglopen naar de exacte bytes die de treffer produceerden en nieuwe codes schrijven die hetzelfde font begrijpt. Bevatte de subset nooit een glyph die de nieuwe tekst nodig heeft, dan zijn er geen codes om te schrijven
De verzoeken hierachter zijn gewoon documentonderhoud. Een bedrijf noemt zichzelf om en drieduizend gearchiveerde facturen dragen nog de oude naam. Een contractsjabloon ging de deur uit met de vervaldatum van vorig jaar. Een uitgefaseerd artikelnummer moet in elke datasheet worden opgevolgd door zijn opvolger. In een tekstverwerker kost elk daarvan dertig seconden; in een PDF loopt elk daarvan aan tegen de manier waarop pagina's werkelijk zijn opgeslagen
Wat een PDF-pagina bewaart in plaats van tekst
Een PDF-pagina bevat gepositioneerde glyphs, geen bewerkbare tekst. Onder ISO 32000-1 §9.4 stuurt de content stream tekst-tonende operatoren aan zoals Tj en TJ, die reeksen charactercodes schilderen op posities die de tekstmatrix bepaalt. Die codes zijn indices in welke codering het huidige font ook declareert. De route terug naar leesbare tekens kan lopen via een /ToUnicode-CMap (§9.10.3), een /Encoding met een /Differences-array, of een CID-mappingketen voor Type0-fonts. Er is geen paragraph-object en geen tekststroom, en niets verplicht een producent om één zichtbaar woord als één string op te slaan: [(Ac) -12 (me)] TJ is een volstrekt gewone manier om een woord te kernen
Vervanging voegt bovenop het decoderen een tweede eis toe. Een text extractor kan byteposities weggooien zodra hij de Unicode eruit heeft. Een vervanger heeft ze nodig, want hij moet weten welke bytes van welke string-operand elke glyph produceerden, zodat hij precies dat bereik kan herschrijven en de rest met rust kan laten. Daarom is een kale StringReplace over de streambytes het verkeerde gereedschap, zelfs op bestanden die toevallig WinAnsi-codering gebruiken. Hij heeft geen idee welke ( bij een string hoort en welke Tf het font selecteert dat die bytes hun betekenis geeft
Zoeken in de gedecodeerde glyph-reeks
De HotPDF Delphi Component doorzoekt een geladen document met SearchLoadedPageText en SearchLoadedDocumentText, die de naald matchen tegen de gedecodeerde Unicode-glyph-reeks van elke pagina, nooit tegen rauwe streambytes. Een treffer is dus een treffer hoe het font hem ook codeerde. Tijdens het decoderen houdt elke glyph een administratie bij van de string-operand, het TJ-array-item en de byte-offset waar hij vandaan kwam, en daarop leunt de vervangstap later. Dezelfde glyph-interpreteerder stuurt de API aan die in tekst uit een geladen PDF extraheren in Delphi wordt behandeld; zoeken houdt simpelweg de bronposities vast die extractie weggooit
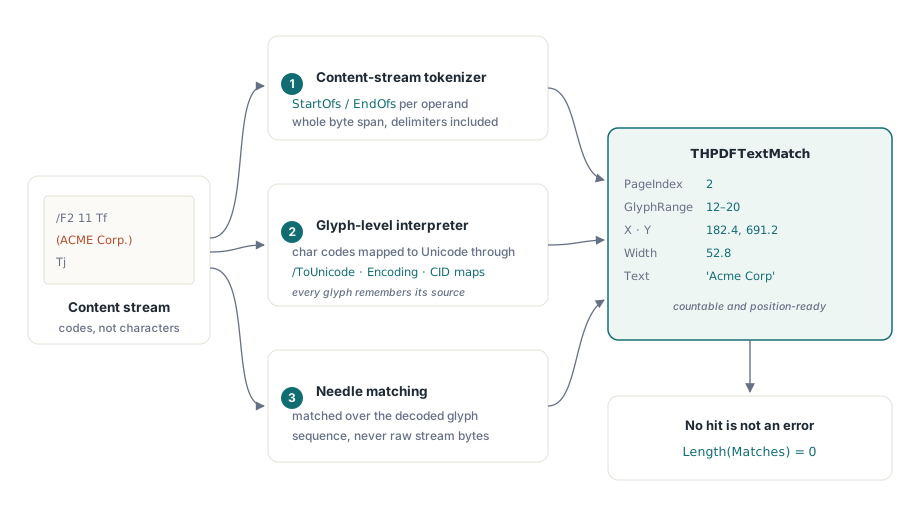
Elke treffer komt terug als record THPDFTextMatch: PageIndex, het inclusieve glyphbereik in GlyphStart en GlyphEnd, de oorsprong in user space in X en Y, de Width van de treffer, de bron-TokenIndex en ItemIndex en de gematchte Text. PageIndex is zero-based. Een naald die niet voorkomt levert een lege array en een True-resultaat op, dus de aanroepende code heeft geen speciaal geval nodig voor "niets gevonden"
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
Of die lus iets print hangt, vóór alles, van spaties af. De zoektekst wordt gebouwd uit de glyphs die de pagina werkelijk schildert, één teken per glyph, en een TJ-offset die twee woorden visueel scheidt is een getal in een array in plaats van een glyph. Een producent die woordgaten met offsets zet in plaats van met een spatie, levert "AcmeCorp" op in de glyph-reeks, en de naald "Acme Corp" zal daar niet op matchen. Als een zichtbare uitdrukking weigert te matchen, zoek dan eerst naar zijn langste enkelvoudige woord en bekijk de Text van wat er terugkomt
Hoofdlettergebruik is het andere wat je moet controleren. Met CaseSensitive op False vergelijken builds vanaf Delphi XE2 tekens via de Unicode-mapping naar eenvoudige kleine letters, die locale-onafhankelijk is, dus É matcht é en Griekse of Cyrillische hoofdletters matchen hun kleine vormen. Builds met oudere compilers vouwen alleen A–Z. De mapping loopt van één teken naar één teken, wat elke naaldpositie uitgelijnd houdt op exact één glyph; de consequentie is dat ß niet matcht op SS. Voor UI-flows op hele woorden laat SearchLoadedPageTextWholeWord treffers weg die in een langer woord zitten, en GetLoadedSearchHitRect zet een match om in één rechthoek voor het tekenen van een markering
Zoeken en vervangen werken allebei op de eigen /Contents-streams van de pagina. Tekst die binnen een Form XObject wordt geschilderd, waar veel tools gestempelde koppen en voeten onderbrengen, woont in een aparte stream die de pagina met Do aanroept, en die valt buiten beide bewerkingen
Gematchte bytes herschrijven met ReplaceLoadedDocumentText
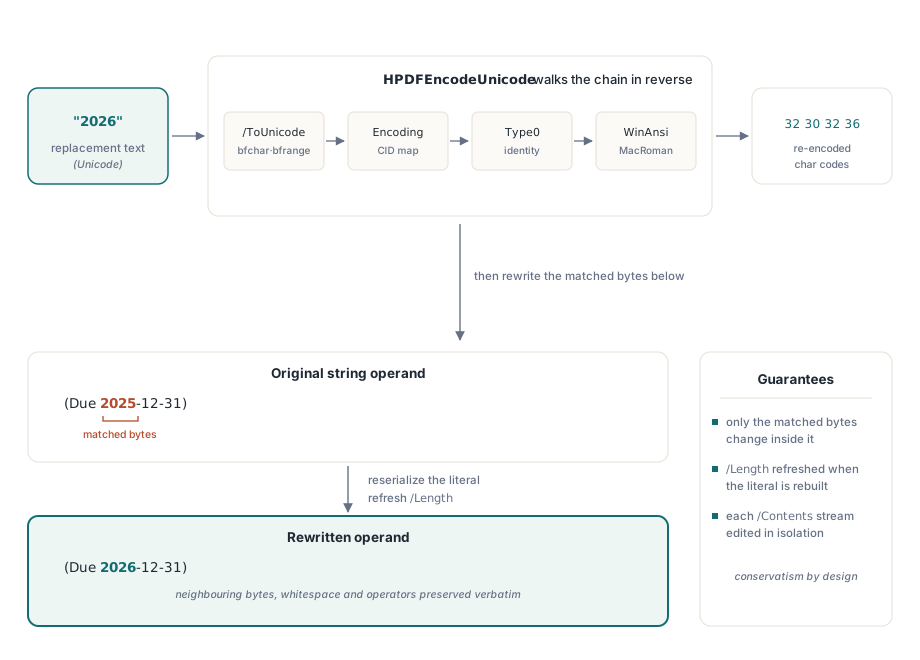
ReplaceLoadedPageText en ReplaceLoadedDocumentText herschrijven elke voorkomen van een naald door de fontdecodering achterstevoren te draaien. Elk vervangingsteken wordt opgezocht via dezelfde keten die de decoder gebruikt, maar omgekeerd: /ToUnicode-entries bfchar en bfrange, CID-mappings voor Type0-fonts, identiteitsmappings en de voorgedefinieerde tabellen WinAnsi en MacRoman. De resulterende charcodes worden teruggeschreven als letterlijke string, of als hexstring wanneer een byte buiten printable ASCII valt, volgens dezelfde escaperegels die de content-stream-parser leest
Alleen de bytes die de match dekt veranderen. Ongematchte bytes in dezelfde operand, de witruimte tussen tokens, commentaar en elke omringende operator gaan ongemoeid door. Vervang bca binnen abcabc en de uitkomst is a + vervanging + bc. De vervanging mag korter of langer zijn dan de naald, en elke stream in de /Contents-array van een pagina wordt op zichzelf verwerkt zodat de pagina welgevormd blijft. Wanneer een match over meerdere string-operands spreidt, zoals Hello opgeslagen als [(He) -20 (llo)] TJ, wordt de vervanging in de operand geschreven waar de match begint en worden de gematchte bytes uit de operands daarna verwijderd
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
De pagina wordt niet opnieuw gezet. PDF heeft geen reflow, dus een vervanging die breder is dan het origineel neemt simpelweg meer horizontale ruimte in en kan botsen met wat er rechts van was geschilderd; de positie van de volgende glyph was door de producent vastgelegd en schuift niet. Datums, versiestrings, artikelnummers en spelfoutcorrecties van vergelijkbare lengte zijn het werk waarvoor deze methode is gebouwd. Een alinea herschrijven zou alles stroomafwaarts opnieuw moeten zetten, dus die verandering hoort in het brondocument
Waarom kan een fontsubset geen tekens nemen die hij nooit bevatte?
Een vervangingsteken dat de ingesloten subset nooit heeft opgenomen, heeft geen charcode om naar terug te keren. Als een producent een font subsettet, dekken zijn /ToUnicode-CMap en codering alleen de glyphs die het originele document gebruikte, en de glyph-omtrekken van al het andere zitten simpelweg niet in het bestand. Als het document nooit een hoofdletter E in dat font heeft gedrukt, selecteert geen enkele bytereeks er één. Die beperking zit in het bestand, niet in de tool die de vervanging uitvoert
ReplaceLoadedDocumentText behandelt een niet-encodeerbare vervanging conservatief: als één enkel teken niet opnieuw kan worden gecodeerd, wordt dat voorkomen in zijn geheel overgeslagen. Er is geen exceptie en geen half-vervangen string, en de originele tekst blijft leesbaar. In het datumvoorbeeld hierboven moet het cijfer 6 ergens in datzelfde font bestaan wil de herschrijving slagen. Stel dat het font alleen ooit "2025" en een paar ordertotalen zonder 6 heeft gedrukt: dan blijven de datums zoals ze zijn
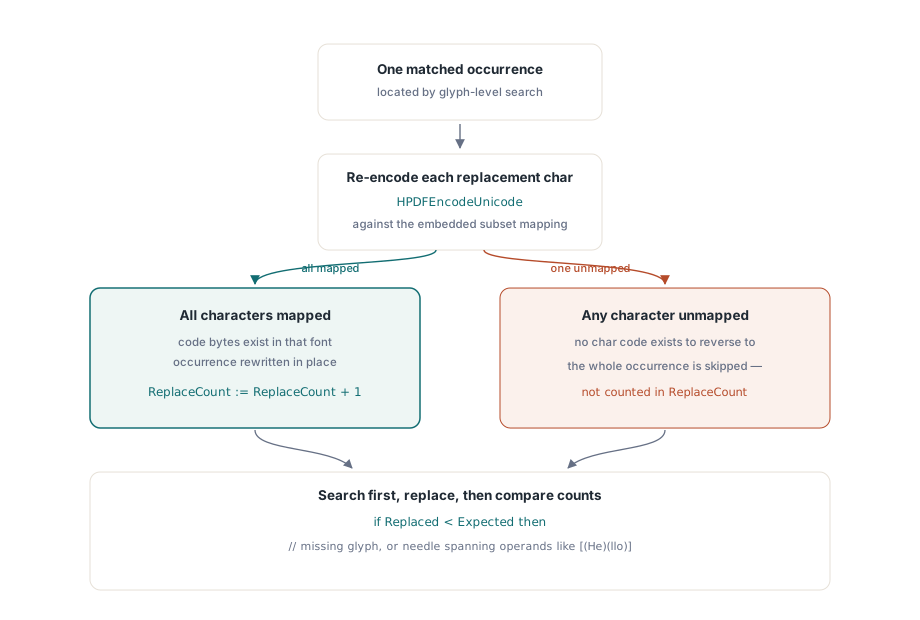
ReplaceCount meldt operand-herschrijvingen, en een match die over meerdere operands spreidt kan voor meer dan één herschrijving zorgen. Een aantal lager dan het aantal treffers betekent nog steeds dat er iets is overgeslagen, maar het exacte antwoord komt uit het opnieuw zoeken na de vervanging. Wat de tweede zoekopdracht vindt, is wat achterbleef, met pagina en positie erbij
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // Opnieuw zoeken werkt alleen als NewText zelf geen OldText bevat
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
Als de subset te klein is: vooraf bekijken en toepassen met een nieuw font
Voor voorkomens die de methode op byteniveau niet kan coderen, nemen PreviewLoadedPageTextReplacement en ApplyLoadedPageTextReplacement een andere route: ze verwijderen de gematchte glyphs en tekenen de vervanging op zijn plek met een font naar keuze, op de originele grootte en op de originele basislijn. De standaard THPDFLoadedTextReplacementOptions gebruikt Arial op de fontgrootte van de gematchte tekst, maat de box naar de breedte van de gematchte tekst en houdt Atomic aan. Eén geweigerde match op de pagina rolde dan de anderen terug. De preview geeft een plan terug met één resultaat per match, elk met een Status en, bij weigering, een Reason
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf is een geladen THotPDF; PageIndex is een zero-based pagina die de audit aanvlagde
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
De weigeringsredenen zijn het printen waard omdat ze direct op pagina-geometrie betrekking hebben. Een match die van de ene tekstregel naar de volgende overloopt wordt geweigerd, en verticale tekst ook. Met het standaard overflow-beleid ltopReject wordt een vervanging die niet in de gematchte breedte past ook geweigerd. ltopShrinkToFit stapt in plaats daarvan naar beneden richting MinFontSize, wat de reden is dat het voorbeeld dat zet voor een vervanging van vijf tekens langer dan de naald. Ook een vervanging met tekens die het gekozen font niet kan tonen wordt geweigerd
Het plan draagt een vingerprint van de paginacontent en fonts. Verandert er tussen preview en toepassing iets aan de pagina, dan roept ApplyLoadedPageTextReplacement EInvalidOpException op in plaats van naar een pagina te schrijven die de preview nooit zag. Pagina's met ongepaarde q/Q- of BT/ET-paren, en documenten die handtekeningvelden bevatten, roepen EArgumentException op; ondertekende documenten vragen om incrementele updates zodat de ondertekende revisie intact blijft
Vervanging op byteniveau gaat eerst, en de font-wisselroute draait alleen op pagina's waar de audit de oude tekst nog vindt. De herschrijving op byteniveau houdt het originele font, zijn metrieken en zijn kerning vast, dus de bewerkte tekst matcht zijn buren op de regel. De previewroute tekent in een ander typeface, en op een regel die in een smal of serif-font is gezet, ziet een aandachtige lezer de verandering. Als het doel is dat tekst verdwijnt in plaats van herformuleerd wordt, is echte contentverwijdering het betere gereedschap; geladen PDF's redigeren en herstructureren in Delphi behandelt die route
Wat verandert er in het opgeslagen bestand
Een content stream die ReplaceLoadedPageText heeft bewerkt, wordt ongecomprimeerd opgeslagen. De stream wordt voor het bewerken gedecodeerd, en wanneer de herbouwde bytes worden teruggeschreven worden zijn /Filter- en /DecodeParms-entries weggegooid en wordt /Length ververst. De PDF is geldig en rendert normaal; de prijs is een groter bestand voor elke bewerkte stream. Een batchbaan over duizenden facturen moet op die groei rekenen of daarna een compressiedoorgang draaien
Het preview-en-toepassen-pad verandert iets meer. Een toegepaste pagina krijgt één nieuwe ongecomprimeerde content stream in plaats van zijn originele /Contents, plus zijn eigen kopie van de resource dictionary met het vervangingsfont eraan toegevoegd. Al het andere in het document wordt met rust gelaten: onaangeroerde streams houden hun compressie, bestaande fonts en afbeeldingen worden niet herschreven, en pagina's zonder treffers worden nooit voor schrijven geopend. Hoe herschreven objecten bij het opslaan in de cross-reference-structuur belanden, wordt behandeld in object streams en incrementele updates in HotPDF
Zoeken, vervanging op byteniveau, preview-en-toepassen-vervanging, extractie en redactie draaien allemaal op dezelfde content-stream-interpreteerder, van Delphi 5 tot en met de huidige RAD Studio, zonder externe afhankelijkheden. Methodereferenties, de vervangingsopties en een proefbuild staan op de productpagina van HotPDF Delphi Component