In een TrueType-font dat de standaard Macintosh-volgorde van glyphs aanhoudt, kan het woord "Total" in een PDF-inhoudsstream staan als <0037005200570044004F> Tj. Die vijf twee-byte-waarden zijn glyphnummers binnen het ingesloten font, en niets in de string zegt dat ze T, o, t, a en l tekenen. Leest u die bytes als UTF-16, dan krijgt u de string 7RWDO, terwijl de pagina zelf op het scherm Total toont, want een glyph tekenen vraagt alleen de code-naar-glyph-mapping en tekst terugvragen vraagt een code-naar-Unicode-mapping die het bestand misschien nooit heeft gedragen
Waarom komt geëxtraheerde tekst als wartaal uit de PDF?
Een inhoudsstream registreert tekencodes, en hun betekenis ligt volledig bij het font. De operatoren Tj en TJ (ISO 32000-1 §9.4.3) dragen bytestrings die worden geïnterpreteerd via het font dat de voorafgaande Tf selecteerde: byte 0x41 is de letter A onder WinAnsi, een willekeurige glyph in een subsetfont, of de helft van een twee-byte CID in een samengesteld CJK-font. ISO 32000-1 §9.10 behandelt tekstextractie als precies dit decodeervraagstuk, waarbij elke code wordt teruggemapt naar Unicode op basis van wat het fontwoordenboek biedt, en de standaard zegt er ronduit bij dat een conform bestand niet verplicht is genoeg informatie aan te leveren om dat mogelijk te maken
Achter elk bugrapport van het type "kopiëren en plakken uit deze PDF geeft wartaal" zit die clausule. Een producent die een subsetfont zonder /ToUnicode-tabel insluit, heeft een geldig bestand geschreven dat correct rendert. Alle glyphs zijn er. Wat ontbreekt is de omgekeerde mapping, en een extractor moet die opbouwen uit secundair bewijs: de gedeclareerde encoding van het font, glyphnamen, de door Adobe gepubliceerde character collections, de cmap-tabel in het ingesloten fontprogramma. Hoeveel van die sporen een API probeert en wat hij u geeft wanneer ze allemaal falen, is wat extractiebibliotheken in de praktijk van elkaar scheidt
Leesstroomtekst met ExtractLoadedPageText
HotPDF Delphi Component geeft de leesstroomtekst van een geladen pagina terug via function ExtractLoadedPageText(PageIndex: Integer; out AText: UnicodeString): boolean. Pagina-indexen zijn nulgebaseerd, het resultaat is een native Delphi UnicodeString, en de functie geeft False terug in plaats van een exceptie te gooien wanneer de pagina geen leesbare inhoudsstream heeft. Het werkt op elke PDF die u laadt: de factuur die een klant u mailde, het rapport dat een scanbureau aanleverde, het contract dat door software is gemaakt waarvan niemand de naam meer weet
var
  Pdf: THotPDF;
  PageCount, I: Integer;
  PageText, AllText: UnicodeString;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('invoice.pdf');  // geeft het aantal pagina's terug
    AllText := '';
    for I := 0 to PageCount - 1 do
      if Pdf.ExtractLoadedPageText(I, PageText) then
        AllText := AllText + PageText + #13#10;
  finally
    Pdf.Free;
  end;
end;
Voor het hele document in één string neemt ExtractLoadedPagesText(PageRange, PageSeparator) een ééngebaseerd bereik zoals '1,3-5,7-' (een lege string betekent alle pagina's) en zet PageSeparator, standaard een form feed #12, tussen de pagina's. Grote documenten kunnen beter via ExtractLoadedPagesTextToStream, dat pagina voor pagina als UTF-8 naar een TStream schrijft en teruggeeft hoeveel pagina's het heeft verwerkt
De tekst bevat wat de pagina toont. Glyphs waarvan het vakmiddelpunt buiten het zichtbare gebied valt (de crop box binnen de media box) worden weggelaten, dus drukkersmarkeringen op een bijgesneden pagina lekken niet uw index in. Tekst in Form XObjects die de pagina schildert wordt meegeteld, afgeknipt op de /BBox van elke form. Een teken dat tweemaal op dezelfde plek wordt geschilderd, de oude truc om een vette letter te veinsen, wordt één keer gelezen; fake bold en dubbele glyphs bij tekstextractie loopt door hoe dat geval wordt herkend
Regeleinden volgen een bewust eenvoudige geometrische regel. Een nieuwe regel begint wanneer de glyph-oorsprong over de schrijfrichting heen beweegt met meer dan de helft van de teksthoogte, genomen als de grootste van de ascent-tot-descent-hoogte van deze glyph en die van de vorige, in pagina-eenheden. Het kader van de glyph meten in plaats van de grootte-operand van Tf is het deel dat ertoe doet: tal van producenten zetten tekst op maat via de text-matrix en geven aan Tf een 1 mee, en een drempel op die operand zou bij elke verhoogde superscript breken en elk teken van gedraaide tekst op een eigen regel zetten. Woordspaties werken hetzelfde. Waar een producent woorden scheidt door de tekstpositie te verschuiven met een TJ-aanpassing of een Td, in plaats van een spatie te tonen, wordt een spatie toegevoegd zodra de opening na de eigen breedte van de vorige glyph meer dan 0.15 van de glyphhoogte bedraagt, en nooit tussen twee Chinese, Japanse of Koreaanse tekens. Codes die de decoder niet kan herleiden worden spaties, zodat woordgrenzen overleven zelfs als individuele glyphs dat niet doen. Horizontale tekst komt eruit in de volgorde van de inhoudsstream; verticale CJK-lopen worden hergroepeerd in kolommen die van rechts naar links, van boven naar beneden worden gelezen. Woordspaties en regeleinden in paginatekst behandelt die drempels
Raster, kolommen of structuurvolgorde
Wanneer positie betekenis draagt (tabellen, formulieren, codelijsten, alles wat u wilt diffen, greppen of per kolom parsen), is ExtractLoadedPageTextLayout de betere aanroep. Het clustert glyphs in basislijnen, sortiert elke basislijn op X en reproduceert horizontale en verticale witruimte op een monospaced tekenraster, gedimensioneerd op de mediane glyph-advance en fontgrootte van de pagina. Brede gaten op een basislijn worden reeksen spaties, grote gaten tussen basislijnen worden lege regels
uses System.IOUtils;
...
var
  Grid: UnicodeString;
begin
  if Pdf.ExtractLoadedPageTextLayout(0, Grid) then
    TFile.WriteAllText('page1.txt', Grid, TEncoding.UTF8);
  // Kolommen, inspringing en tabeluitlijning overleven als
  // spaties en lege regels op een tekenraster
end;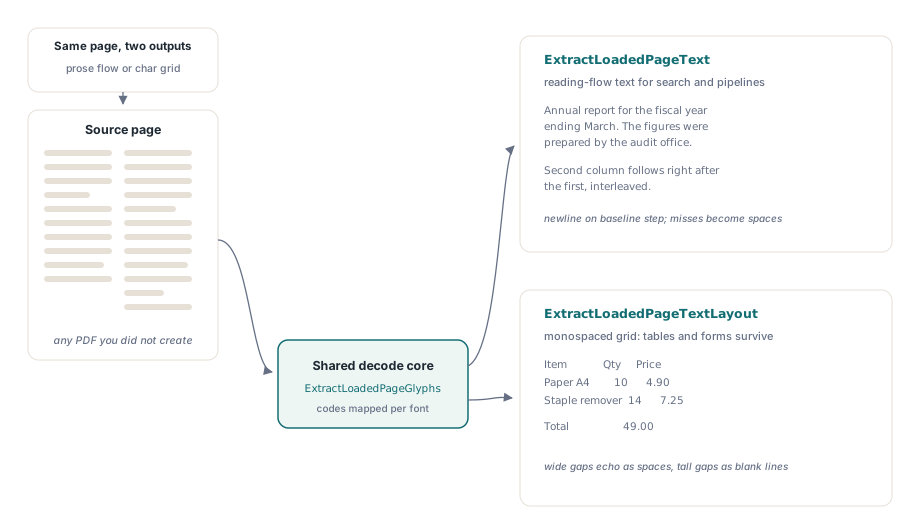
Beide aanroepen decoderen via dezelfde machinerie, dus kiezen kost niets aan getrouwheid. Wat het raster niet doet, is proza opnieuw laten stromen: een artikel in twee kolommen komt eruit met beide kolommen getrouw naast elkaar, precies goed voor een diff en verkeerd voor een summarizer. Twee andere aanroepen dekken dat gat. ExtractLoadedPageTextColumns(PageIndex, AText, ColumnGapMultiplier) splitst elke rij waar de opening tussen naburige glyphs groter is dan de multiplier keer de mediane advance (standaard 3.0) en scheidt de stukken met een tab. ExtractLoadedPageStructureText(PageIndex, AText, UntaggedGlyphCount) loopt door de structuurboom van een getagde PDF (ISO 32000-1 §14.8.4) en geeft de marked-content-lopen in auteurvolgorde terug; hij geeft False terug wanneer de pagina geen bruikbare structuurboom heeft, en UntaggedGlyphCount vertelt hoeveel glyphs hij niet kon plaatsen
Voor tekst die een mens of een taalmodel gaat lezen, probeert u eerst structuurvolgorde en valt u terug op ExtractLoadedPageText. De structuurboom is de enige volgorde die de auteur met opzet heeft vastgelegd, en elke geometrische methode is daar in vergelijking een gok. Houd het raster voor de taken waarbij kolommen data zijn. Tekstextractie in structuurvolgorde heeft de details van hoe marked content aan de boom wordt gekoppeld
Hoe decodeert HotPDF tekencodes naar Unicode?
HotPDF Delphi Component herleidt elke tekencode via een op prioriteit geordende fallbackketen, en een strategie die geen antwoord heeft geeft de code door aan de volgende. De /ToUnicode-CMap van het font (ISO 32000-1 §9.10.3) komt eerst, want dat is de enige mapping die de producent specifiek voor extractie heeft geschreven. Daarna komen glyphnamen uit een /Encoding-/Differences-array, gelezen via de Adobe Glyph List; dan de /Encoding-CMap zelf, embedded als stream of benoemd, waar een naam Uni…-UTF16 betekent dat de code al UTF-16 is. Samengestelde fonts gaan verder door de Adobe character collections (Adobe-GB1, Adobe-CNS1, Adobe-Japan1, Adobe-Korea1, Adobe-KR) van CID naar Unicode, en daarna via /CIDToGIDMap de cmap-tabel van het ingesloten fontprogramma in, achterstevoren van glyph naar Unicode gelezen. Eenvoudige fonts vallen terug op de tabellen WinAnsi, MacRoman, Standard en MacExpert en ten slotte op diezelfde embedded cmap. Een code die de keten uitput, herleidt tot 0
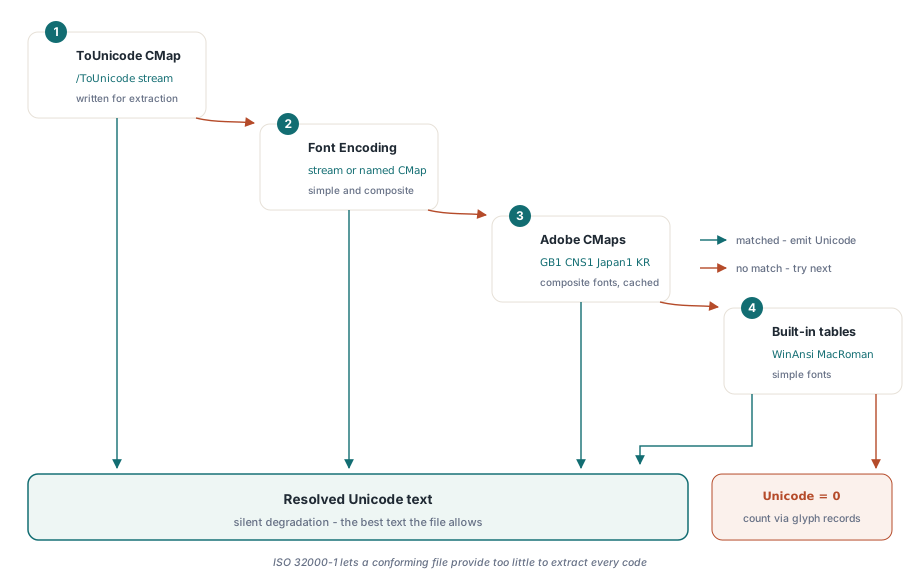
De embedded-cmap-stap is wat vele subsetfonts zonder /ToUnicode redt: het fontprogramma bevat meestal nog steeds zijn eigen Unicode-cmap, en die achterstevoren lezen rekent het grootste deel van de tekst terug. Het blijft een reconstructie. Twee Unicode-tekens die één glyph delen, komen allebei terug als de waarde die de cmap vermeldt, dus behandel teruggewonnen tekst als goed genoeg voor zoeken en indexering en controleer hem voordat u hem als juridisch document gebruikt
De Adobe-collectiedata staat op schijf. HotPDF levert de CMap- en cid2code.txt-bestanden mee onder zijn map resources\CMap, parseert elk bestand hooguit één keer per proces en cachet het resultaat; de Adobe-GB1-map alleen al is zo'n 2 MB aan tekst die u niet per pagina opnieuw wilt parsen. De vooraf gedefinieerde CMaps bestaan ook als ingebouwde tabellen, dus een font dat met een benoemde CMap zoals UniGB-UTF16-H is gecodeerd, decodeert ook zonder die map. De CID-naar-Unicode-tabellen voor CJK-fonts met Identity-H hebben de map wel nodig. De property CMapResourcePath benoemt de map die de collectiesubmappen bevat; leeg gelaten zoekt HotPDF naar resources\CMap naast het uitvoerbare bestand en een of twee niveaus daarboven
Pdf := THotPDF.Create(nil);
try
  // Map die Adobe-GB1-6, Adobe-CNS1-7, Adobe-Japan1-7 ... bevat
  Pdf.CMapResourcePath := 'C:\MyService\resources\CMap';
  Pdf.LoadFromFile(FileName);
  ...
finally
  Pdf.Free;
end;
Zet het pad expliciet in elke service, ISAPI-module of plugin-DLL. In die hosts benoemt ParamStr(0) het hostproces, wat zelden de map is waar u heen hebt uitgerold, en een ontbrekende map geeft geen exceptie; CJK-pagina's komen gewoon terug met gaten waar de collectietabellen hadden ingevuld. Complexe schrifttekstvormgeving met HotPDF ontmoet hetzelfde onderscheid tussen code en glyph op het moment van schrijven
Twee CMap-syntaxvalkuilen
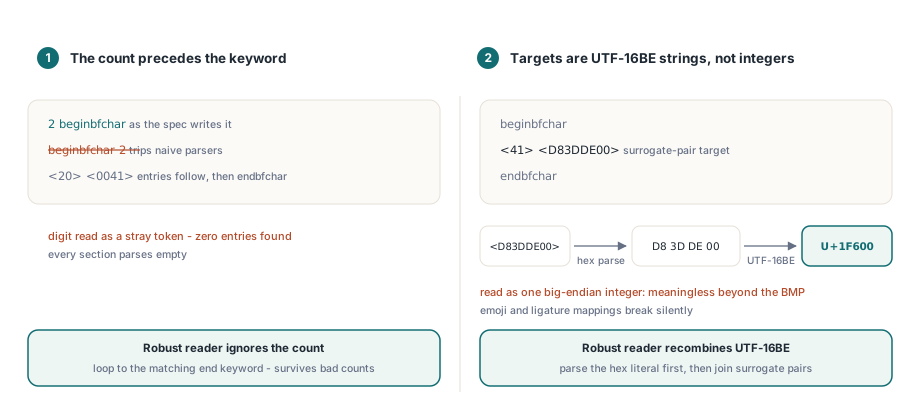
CMap-bestanden lijken triviaal parseerbaar, en twee details laten de meeste eerste pogingen struikelen. Het aantal records komt vóór het sectiesleutelwoord: een sectie luidt 2 beginbfchar, nooit beginbfchar 2. Een parser die het aantal ná het sleutelwoord verwacht, slikt het getal als verdwaald token in en vindt vervolgens nul vermeldingen in elke sectie. De lezer van HotPDF negeert het aantal volledig en loopt door tot de matchende endbfchar of endbfrange, wat ook omgaat met bestanden uit de praktijk waarvan de gedeclareerde aantallen fout zijn
De tweede valkuil is dat de doelen van bfchar en bfrange UTF-16BE-strings zijn. De bestemming <D83DDE00> betekent U+1F600, een surrogaatpaar dat tot één codepunt moet worden samengevoegd, en die vier bytes als big-endian geheel getal lezen levert voor elk teken buiten het Basic Multilingual Plane een betekenisloze waarde op, emoji inbegrepen. HotPDF parseert de hex-literal eerst naar ruwe bytes en voegt daarna de UTF-16BE-code-eenheden samen, wat meteen ook de doelen met meerdere tekens dekt die ligatuurmappings opleveren, zoals één fi-glyph die naar twee letters mapt
Niet-opgeloste glyphs tellen met ExtractLoadedPageGlyphs
ExtractLoadedPageGlyphs(PageIndex, AGlyphs) legt de glyph-records onder de tekstaanroepen bloot als een THPDFGlyphArray. Elk THPDFGlyphRecord draagt de ruwe Code, zijn CodeByteWidth (1, 2 of 4, bepaald door de codespacerange van de CMap), het herleide Unicode-codepunt plus een UnicodeSequence voor ligaturen, de actieve FontKey en FontSize, de X- en Y-oorsprong in gebruikersruimte, de Advance, een glyph-vierhoek met vier hoeken, en GlyphEndX / GlyphEndY, het einde van de eigen breedte van de glyph waarvan de woordspatieregel meet. Dat is genoeg voor gepositioneerde markering of een eigen lay-outalgoritme
var
  Glyphs: THPDFGlyphArray;
  I, Unresolved: Integer;
begin
  if Pdf.ExtractLoadedPageGlyphs(0, Glyphs) then
  begin
    Unresolved := 0;
    for I := 0 to High(Glyphs) do
      if Glyphs[I].Unicode = 0 then
        Inc(Unresolved);
    if Unresolved > 0 then
      ShowMessageFmt('%d of %d glyphs have no Unicode mapping',
        [Unresolved, Length(Glyphs)]);
  end;
end;
Unicode = 0-records tellen is de eerlijke manier om een document te beoordelen voordat u zijn tekst stroomafwaarts vertrouwt. Reken erop dat de telling iets afwijkt van wat de tekstaanroepen zien. Deze aanroep geeft elke glyph uit de eigen inhoudsstream van de pagina terug, ook die buiten de crop box en duplicaten geschilderd voor fake bold, en daalt niet af in Form XObjects. Elk record bewaart ook TokenIndex, ItemIndex en ByteOffset, die het teken terugverankeren aan zijn bronoperand; zoeken en vervangen in een bestaande PDF is op die drie velden gebouwd
Sommige bestanden hebben geen tekst te geven. Een gescande pagina is één grote afbeelding zonder tekstoperatoren, dus extractie geeft terecht een lege string terug, en de route vooruit is OCR, te beginnen met het extraheren van de pagina-afbeeldingen uit de geladen PDF. Versleutelde documenten worden normaal geëxtraheerd zodra ze worden geopend met LoadFromFile(FileName, Password), want de streams worden gedecodeerd voordat de interpreter ze leest. Font- en inhoudsstreams worden via dezelfde filterketen gedecodeerd als de rest van het geladen document, en een /ToUnicode-stream die niet te decoderen is, zakt door naar de volgende strategie terwijl de rest van de pagina gewoon extraheert. Dezelfde objectlezer ondersteunt het bewerken van metadata op geladen documenten, dus één innamepas kan tekst lezen en metadata herstellen
Leesstroom-, raster-, kolom- en structuurvolgorde-extractie, plus toegang op glyphniveau, zitten allemaal in de HotPDF Delphi Component voor Delphi en C++Builder als puur Object Pascal zonder externe DLL's of OS-tekstservices, dus wanneer er een vreemd bestand in uw wachtrij belandt, kunt u in de decoder stappen en zien welke strategie voor elke code het antwoord gaf