Je hebt een PDF op schijf, een klant heeft hem gescand van een stapel facturen, en jouw taak is om de pagina-afbeeldingen als bitmaps terug te halen voor een OCR-pass. Je opent het bestand, je vindt de image XObjects, en dan kom je bij het deel waar niemand je voor waarschuwt: de bytes in die streams zijn geen pixels. Het zijn een JPEG-codestream, een met wavelet gecomprimeerde JPEG 2000-blob, een Group 4-faxrun of een geïndexeerde raster achter een palette achter een Flate-filter. Het image object kent zijn breedte en hoogte, maar de echte samples zitten opgesloten in welk filter de producer ook heeft gekozen. Om een bruikbare TBitmap te krijgen moet je dat filter terugdraaien, en PDF geeft je daarvoor ongeveer acht verschillende manieren
Dit is het gat dat ExtractLoadedImage in HotPDF opvult, de native VCL PDF-component voor Delphi en C++Builder. Het inventariseert de image XObjects in een document dat je hebt geladen, meldt wat elk ervan is, en decodet de decodbare naar een 24-bit bitmap. Het interessante zit niet in het API-oppervlak, dat drie methoden telt. Het zit in waarom er überhaupt een apart decodeerpad moet bestaan, en welke filters het terug naar pixels omzet
Waarom geladen afbeeldingen nog niet gedecodeerd zijn
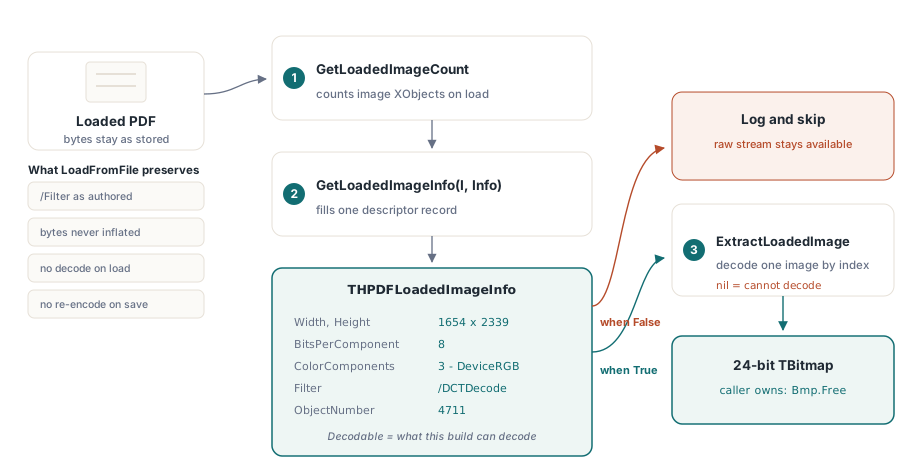
De loader van HotPDF is gebouwd rond pass-through getrouwheid. Wanneer je LoadFromFile aanroept, blijven de image streams exact zoals ze in het bronbestand staan: het oorspronkelijke filter, de oorspronkelijke gecomprimeerde bytes, de oorspronkelijke dictionary. Dat is opzettelijk. Het hele punt van een document laden is meestal pagina's kopiëren, bestanden samenvoegen, stempels toevoegen, permissies aanpassen en het resultaat weer wegschrijven, en voor al die taken is het goedkoopste en veiligste om elke image stream ongemoeid te laten. Elke afbeelding bij het laden naar een raster decoderen zou geheugen en CPU verspillen aan werk dat de meeste aanroepen nooit nodig hebben, en opnieuw coderen bij het opslaan zou afbeeldingen aantasten die gewoon byte voor byte gekopieerd hadden moeten worden
Het gevolg is dat de geladen objectgrafiek geen pixels bevat. Een image XObject waarvan de /Filter /DCTDecode is, bevat JPEG-bytes; HotPDF heeft er nooit een JPEG-decoder op losgelaten, want niets in het kopieer-en-herschrijfpad hoefde dat. Wil je dus werkelijk pixels, dan moet de extractie-API het decoderen zelf doen, vanaf nul, voor welk filter die bepaalde afbeelding nu toevallig gebruikt. Dat is dezelfde reden waarom de codecs aan de encodeerkant onafhankelijk zijn van de loader: het artikel over JPEG 2000-afbeeldingen aan PDF-bestanden toevoegen in Delphi beschrijft hoe de JPX-engine in de aanmaakkant hangt, en de extractie-API sluit dezelfde engine aan op de leespad
De driemethoden-API
De surface is klein. GetLoadedImageCount geeft terug hoeveel image XObjects het geladen document bevat. GetLoadedImageInfo vult voor een van die objecten een descriptorrecord op basis van de index. ExtractLoadedImage geeft de gedecodeerde bitmap terug, of nil wanneer dat beeld niet gedecodeerd kan worden. Enumeratie is index-gebaseerd en stabiel voor een gegeven load: intern loopt de methode door de indirect-objecttabel en verzamelt elk stream waarvan /Subtype naar /Image resolveert, dus de index die je aan GetLoadedImageInfo doorgeeft is dezelfde index die je aan ExtractLoadedImage doorgeeft
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // filter of colour space niet ondersteund
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // de aanroeper is eigenaar van de bitmap
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Twee contractdetails zijn hier belangrijk. Ten eerste is de teruggegeven TBitmap van jou om vrij te geven; het document cachet hem niet en bezit hem niet. Ten tweede, controleer Decodable voordat je aanroept, en controleer de uitkomst op nil daarna. De methode gooit geen exception bij een niet-ondersteund filter, hij geeft nil terug, en een stille nil in een batchlus is precies het soort fout waardoor een pagina uit een job van duizend pagina's verdwijnt zonder dat iemand het merkt
De descriptor lezen voordat je decodeert
THPDFLoadedImageInfo vertelt je wat een afbeelding is zonder meteen een volledige decode af te dwingen. De velden komen rechtstreeks uit de image dictionary: Width en Height in samples, BitsPerComponent, ColorComponents en ColorSpace die de interpretatie na decodering beschrijven, 1 voor grijs, 3 voor RGB, 4 voor CMYK, Filter als de genoemde compressie, IsImageMask voor stencil masks, ObjectNumber voor het onderliggende indirect object, en Decodable
Die laatste vlag is de eerlijke. Decodable is alleen True wanneer de lopende build deze specifieke combinatie van filter en kleurruimte echt naar een bitmap kan omzetten. Hij encodeert de echte supportmatrix, geen wensdenken: een image waarvan de huidige build het Filter niet begrijpt rapporteert Decodable = False, en daarop kun je brancheren om te loggen, over te slaan of terug te vallen op het zelf uitlezen van de ruwe stream. Behandel het als een voorwaarde, niet als een hint
// Triageer elke afbeelding voordat je aan een decode begint
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf loaded ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) will return a TBitmap
    else
      // filter/colour space niet ondersteund: log het object en sla het over
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;
Eén implementatiedetail bijt mensen die descriptorrecords met de hand opbouwen. THPDFLoadedImageInfo bevat twee AnsiString-velden, Filter en ColorSpace. Dit zijn managed types met referentietelling, dus de reflex om een record met FillChar(Info, SizeOf(Info), 0) te wissen is hier fout: daarmee overschrijf je de stringreferentie zonder hem af te tellen, wat lekt of corrupt raakt. HotPDF initialiseert het record veld voor veld om precies die reden, en als je dit patroon ooit in je eigen code kopieert, doe dan hetzelfde
Eén dispatcher, acht filterpaden
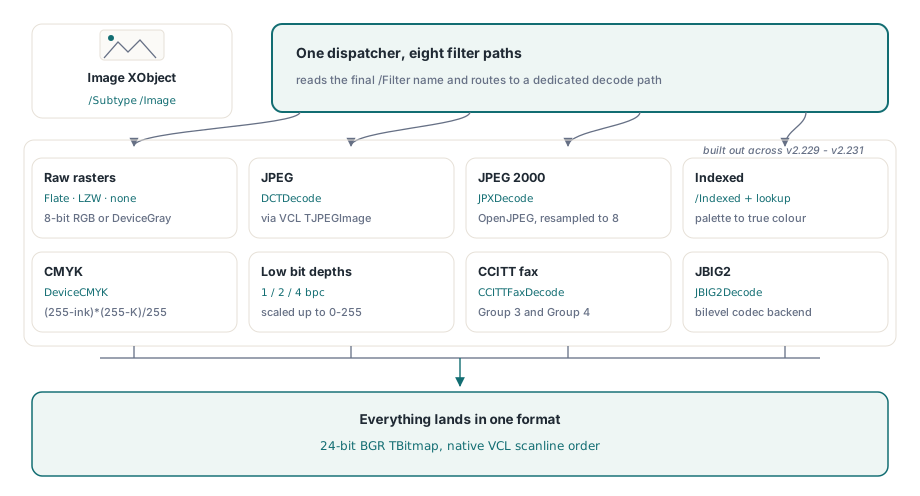
De reden dat extractie überhaupt een dispatcher nodig heeft, is dat PDF geen afbeeldingsformaat heeft. Het heeft filters, en §8.9.5 van ISO 32000-1 laat een image XObject er elk van noemen in /Filter, terwijl de sample-interpretatie apart wordt bepaald door /ColorSpace, /BitsPerComponent en een optionele /Decode-array. ExtractLoadedImage leest de filternaam en stuurt elk geval naar een eigen decoder. De ondersteunde set dekt acht verschillende paden
- Ruwe rasters (FlateDecode, LZWDecode of geen filter) in 8-bit DeviceRGB of DeviceGray. De bytes worden uitgepakt tot een packed raster, en de enige transformatie is een kanaalwissel, hieronder beschreven
- DCTDecode (JPEG). De codestream gaat naar VCL's
TJPEGImage, die geometrie en kleur oplost, en het resultaat wordt in een 24-bit bitmap gezet - JPXDecode (JPEG 2000). Gedecodeerd via de OpenJPEG-back-end, dezelfde engine die in het JPEG 2000-artikel wordt beschreven, met componenten met een hoge bitdiepte teruggeschaald naar 8 bits
- Geïndexeerde kleur. De palette wordt gelezen uit de
[/Indexed base hival lookup]-array en elk sample wordt via de lookup table uitgebreid naar true color - DeviceCMYK. Vierkanaals samples worden met de standaard inkt-op-wit-formule naar RGB omgezet
- DeviceGray en Indexed onder 8 bit, op 1, 2 of 4 bits per component, sample voor sample uitgepakt en geschaald naar het bereik 0–255
- CCITTFaxDecode, de Group 3- en Group 4-faxfilters, gedecodeerd door een speciale T.4/T.6-back-end
- JBIG2Decode, de bilevelfilter met hoge compressie, gedecodeerd via de geregistreerde JBIG2-back-end die het native JBIG2-compressieartikel vanuit de encode-kant behandelt
Alles landt op dezelfde plek: een 24-bit BGR bitmap, omdat dat is wat een VCL TBitmap standaard opslaat en wat elke downstream consumer verwacht
De transformaties die stilletjes pixels veranderen
Twee van deze paden bevatten een transformatie die subtiel fout kan gaan, en die het waard is om te begrijpen, zelfs als je de decoder zelf nooit aanraakt. De eerste is de verwisseling van kleurovolgorde. Een PDF DeviceRGB-raster bewaart samples in rood-groen-blauw-volgorde, met de bovenste rij eerst. Een VCL 24-bit scanline bewaart ze in blauw-groen-rood-volgorde. Dus een gewone RGB-afbeelding decoderen is geen memcpy; de eerste en derde byte van elk pixel worden tijdens het vullen van de scanline omgewisseld. Doe je dat verkeerd, dan wisselen rood en blauw van plaats, wat op een grijswaardentestbeeld prima lijkt en op een kleurbeeld rampzalig fout is. De rijvolgorde loopt voor zover relevant gewoon door: de top-down rasters van PDF sluiten aan op VCL's ScanLine[0] als de bovenste zichtbare rij, dus er is geen verticale flip nodig
De tweede is CMYK. PDF DeviceCMYK-afbeeldingen dragen vier inkten, en de omzetting naar RGB is een berekening per kanaal, geen lookup: elk uitvoerkanaal is (255 - ink) * (255 - K) / 255. Dit is een apparaatbenadering, geen kleurgecontroleerde omzetting via een ICC-profiel, dus het resultaat is goed genoeg voor weergave en opnieuw rasteriseren, maar niet de juiste route als je printnauwkeurige kleur nodig hebt. Als je workflow trouw moet zijn, behandel de geëxtraheerde bitmap dan als een preview en bewaar de originele CMYK-stream voor de kleurgecontroleerde pipeline
Het Indexed-pad verbergt zijn eigen parsevalkuil. De palette in een /Indexed-kleurruimte kan worden opgeslagen als een letterlijke string of als een hexadecimale string, en HotPDF bewaart de waarde van een hex-string als de hex tekst, niet als de gedecodeerde bytes. Dus wanneer de palette een hex-string is, moet de lookup table eerst door een hex-naar-bytes-decoder. Een letterlijke string zijn al ruwe bytes. Sla je die tak over, dan komt een vierkleurige geïndexeerde afbeelding als rommel terug, omdat elke palette-entry vanaf het verkeerde bytegrens wordt gelezen
Filterketens: het laatste filter is de afbeelding zelf
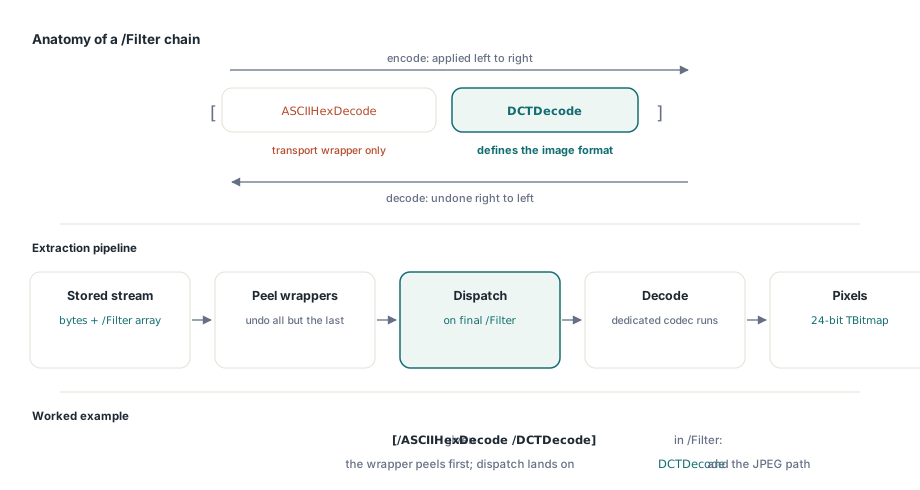
Een enkele /Filter-naam is het eenvoudige geval. PDF staat ook een keten van filters toe, waarbij de stream meerdere keren achter elkaar is verwerkt en in volgorde wordt opgesomd in een /Filter-array zoals [/ASCII85Decode /FlateDecode] of [/ASCIIHexDecode /DCTDecode] (ISO 32000-1 §7.4). De semantiek is precies: de filters worden bij coderen van links naar rechts toegepast, dus bij decoderen draai je ze van rechts naar links terug, en het laatste filter in de array is degene die het imageformaat werkelijk bepaalt. De leidende filters zijn alleen transportcoderingen eromheen
De extractor handelt dit af door lagen weg te pellen. Voor er ook maar één image-decoder draait, wordt elk filter in de keten behalve het laatste toegepast om de input te maken die het finale filter verwacht, en pas daarna gebeurt dispatch op dat laatste filter. Dus [/ASCII85Decode /DCTDecode] haalt eerst de ASCII85-laag van de stream af en stuurt het resultaat dan naar het JPEG-pad; [/FlateDecode] rond een ruwe raster inflates en draait daarna het rasterpad. Daardoor kunnen de acht decoders eenvoudig blijven. Geen van hen hoeft iets te weten over ASCII85- of hex-transportwrappers, omdat tegen de tijd dat een decoder de bytes ziet, die wrappers al weg zijn. Het betekent ook dat een keten met een niet-ondersteund laatste filter nog steeds netjes faalt bij de dispatchstap in plaats van halverwege
Wat er terugkomt, en wanneer je de ruwe stream gebruikt
Wat je krijgt is de basisafbeelding zoals zijn eigen stream hem decodeert, niet een gecomponeerd resultaat waarop de soft mask is toegepast. JPEG 2000-componenten dieper dan 8 bits worden hergesampled naar 8, wat display en OCR goed uitkomt, en een image mask, een stencil van één bit zonder eigen kleur, wordt gemarkeerd via IsImageMask zodat je het als stencil behandelt in plaats van als foto. Een afbeelding waarvan het laatste filter of de kleurruimte buiten de set hierboven valt, geeft nil terug, en daarom hoort de Decodable-bewaking in elke lus
Heb je alpha, volledige bitdiepte of kleurbeheerde uitvoer nodig, dan ligt de ruwe stream nog steeds gewoon in de geladen objectgrafiek, filter en al, en kun je hem bytewijs eruit trekken en aan een eigen gespecialiseerde codec geven. Dat is de fallback die het pass-through-ontwerp met opzet bewaart: de originele bytes worden nooit weggegooid, dus het slechtste geval is dat je ze zelf decodeert in plaats van dat de data weg is. Voor de meeste echte taken dekken de acht ondersteunde filters wat scanners, kantoorsuites en rapport-engines werkelijk uitzenden, en een lus over GetLoadedImageCount met een Decodable-bewaking zet een geladen PDF in een paar regels terug om naar een map vol bitmaps
De API voor extractie van geladen afbeeldingen, samen met de volledige set decodefilters die hier is beschreven, wordt meegeleverd met de HotPDF Delphi Component voor Delphi en C++Builder