PDF 1.5 introduceerde twee opslagstructuren die het eerdere bestandsformaat niet kon uitdrukken: de object stream en de cross-reference stream. Een object stream is één Flate-gecomprimeerde container, getagd /Type /ObjStm, die vele kleine indirecte objecten end-to-end gepakt vasthoudt in plaats van ze door de bestands-body te verspreiden. Een cross-reference stream is de opzoektabel van het bestand herschreven als gecomprimeerde binaire met variabele-breedte velden, in plaats van de vaste-breedte ASCII-tabel die elke PDF tot en met versie 1.4 afsloot. Ze reizen samen. Zodra objecten in een stream zijn gevouwen, kan de oude tekentabel ze niet meer adresseren, dus de binaire xref moet ermee meekomen
Zet dat tegenover de klassieke layout en de kosten die het wegneemt zijn makkelijk te zien. In een PDF 1.4-bestand zit elk indirect object ongecomprimeerd achter zijn eigen obj-header, en de tabel aan het staartje spendeert exact 20 bytes ASCII per entry, compressie verboden. Een document met 200.000 objecten draagt ruwweg 4 MB cross-reference-data mee voordat er één glyph wordt getekend, met alle ongecomprimeerde dictionary-bodies erbovenop gestapeld. PDF 1.5 valt beide getallen tegelijk aan: de dictionaries vouwen in Flate-containers, en de 4 MB-tabel krimpt tot een paar honderd kilobyte binair. ISO 32000-1 definieert de twee structuren in §7.5.7 en §7.5.8
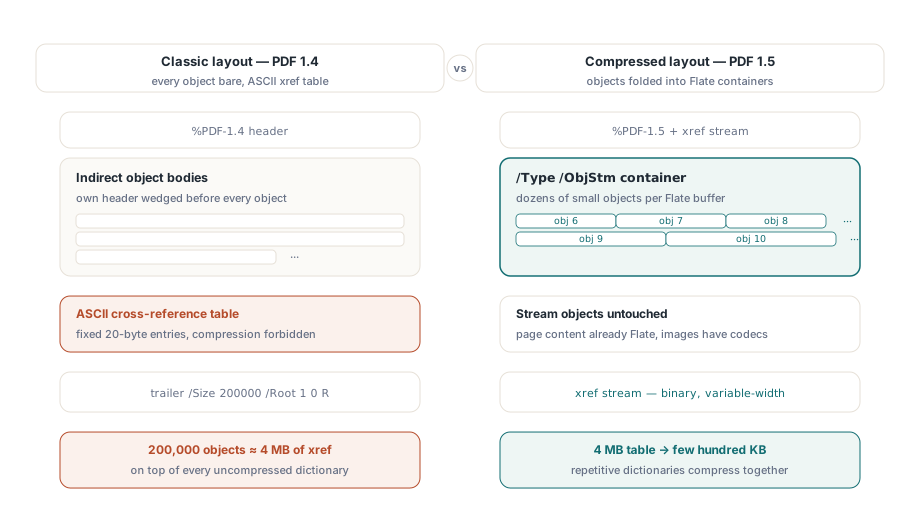
Waar de besparing werkelijk landt
Object streams raken alleen non-stream-objecten, dus ze comprimeren structuur, geen pixels. Pagina-inhoud was vóór 1.5 al Flate-gecomprimeerd, en afbeeldingsdata draagt zijn eigen codecs, wat de reden is dat een beeldrijke brochure nauwelijks beweegt. De bestanden die instorten zijn de structuur-rijke: AcroForms met duizenden veld-dictionaries, diepe outline-bomen, tagged-PDF-structuur-elementen. Die objecten zijn klein, talrijk en nagenoeg identiek aan elkaar, en die herhaling is precies wat Flate exploiteert zodra ze in één buffer zitten in plaats van verspreid over de body met headers ertussen geklemd
Het is makkelijk te onderschatten hoeveel van een oud bestand overhead is. Een formulierarchief dat jaren aan bewerkingen heeft geabsorbeerd kan ruim de helft van zijn bytes uitgeven aan dictionary-headers, xref-padding en revisies die geen reader ooit zal bekijken. De twee features hier nemen de eerste twee daarvan terug. De derde, geaccumuleerde revisies, wijkt alleen voor compactie, zodra het bestand zijn eigen geschiedenis niet meer hoeft te onthouden
In HotPDF zet u beide aan via een paar eigenschappen, en hoe ze van elkaar afhangen telt meer dan de volgorde waarin u ze schrijft:
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'catalog-2026.pdf';
    Pdf.UseXRefStream := True;      // binaire xref, voorwaarde voor ObjStm
    Pdf.UseObjectStreams := True;   // pak objecten in /Type /ObjStm
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Arial', [], 11);
    Pdf.CurrentPage.TextOut(50, 760, 0, 'Compressed structure demo');
    Pdf.EndDoc;                     // emits XRefStm + ObjStm containers
  finally
    Pdf.Free;
  end;
end;
UseObjectStreams heeft UseXRefStream nodig op True. Een gecomprimeerd object wordt bereikt via een type-2 xref-entry, die een object-stream-nummer plus een index noteert, en een klassieke 20-byte tekstrij heeft geen plaats om dat paar op te slaan. Dus UseObjectStreams alleen doet niets zichtbaars; beide vlaggen, gezet vóór BeginDoc, zijn de configuratie die werkt. Zet ze na BeginDoc en HotPDF heeft zich al gecommit aan de oudere layout
Waarom beide standaard uit staan
HotPDF laat beide eigenschappen out-of-the-box False, en de reden duikt op in integraties met oude downstream-code. Een reader die alleen PDF 1.4 begrijpt kondigt niet aan dat hij geen gecomprimeerde objecten aankan. Hij ontmoet een xref-stream, vindt none van de trailer-keywords die hij verwacht, en rapporteert een beschadigde cross-reference-tabel of weigert eenvoudigweg het bestand te openen. Als uw output in een verouderende fax-gateway stroomt, een hardware-printer die een ingebedde interpreter draait, of een parser die iemand tien jaar geleden tegen de 1.4-specificatie schreef, houd dan beide vlaggen uit voor dat kanaal en leef met het grotere bestand. Voor archiefopslag en web-levering, waar elke reguliere viewer al twintig jaar PDF 1.5 leest, is ze aanzetten compressie die u bijna voor niets krijgt
Er is een tweede-orde-effect dat de moeite waard is om uw support-team te vertellen. Zodra dictionaries in object streams zijn gepakt, stopt het byte-voor-byte vergelijken van twee gegenereerde bestanden iets te betekenen, want één veld wijzigen kan een hele container opnieuw Flaten en alles erna herschikken. Diff zulke bestanden op objectinhoud, niet met een binaire vergelijking
Incremental updates en de byte-offsets die ze beschermen
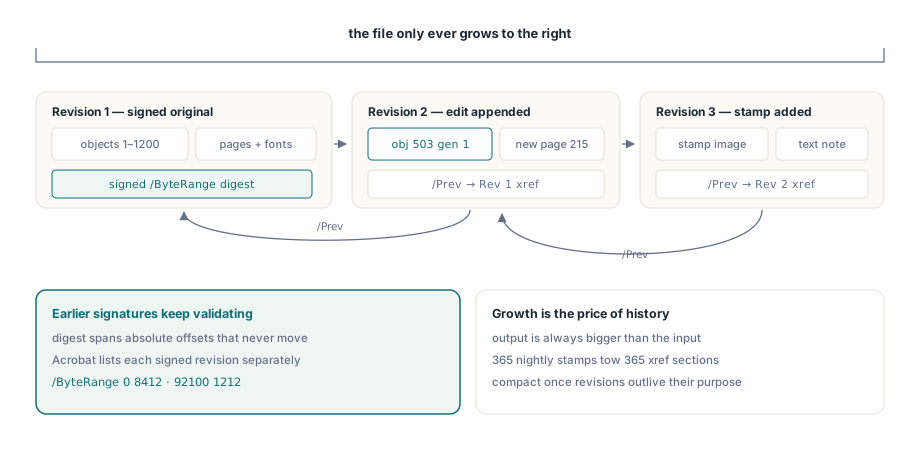
Een digitale handtekening dekt een expliciete /ByteRange: twee spannen van het fysieke bestand, gegeven als absolute byte-offsets, waarover de CMS-digest werd genomen. Herschrijf het bestand, zelfs tot iets dat er op het scherm identiek uitziet, en al die offsets bewegen. De digest stopt met matchen en de handtekening leest als gebroken. Dat is het precieze probleem dat ISO 32000-1 §7.5.6 oplost met incremental updates. Nieuwe en gewijzigde objecten worden na de bestaande %%EOF geappend, dan wordt een verse cross-reference-sectie geschreven wiens /Prev-entry terugwijst naar die ervóór. De originele bytes worden nooit verstoord, dus een ondertekende revisie blijft verifieerbaar en Acrobat kan elke ondertekende revisie apart presenteren in het handtekeningspaneel
HotPDF stelt dit beschikbaar via zijn eigen entry-point:
Pdf.BeginIncrementalUpdate('contract-signed.pdf');
Pdf.AddPage;
Pdf.CurrentPage.SetFont('Arial', [], 10);
Pdf.CurrentPage.TextOut(50, 760, 0, 'Addendum recorded 2026-06-11');
Pdf.SaveIncrementalUpdate('contract-updated.pdf');  // voegt alleen de delta toe
Twee dingen laten mensen struikelen. BeginIncrementalUpdate moet de originele bestandsnaam ontvangen, want de geappende xref-sectie noteert offsets die alleen betekenis hebben tegenover die exacte originele bytes; wijs het naar een hernoemde of opnieuw opgeslagen kopie en de offsets beschrijven een bestand dat niet meer bestaat. En het opslaan is constructief append-only, dus de output is altijd groter dan de input. Die groei is geen afval om weg te tunen. Het is dezelfde eigenschap die eerdere ondertekende revisies intact laat
Een geladen bestand wijzigen gaat via LoadFromFile
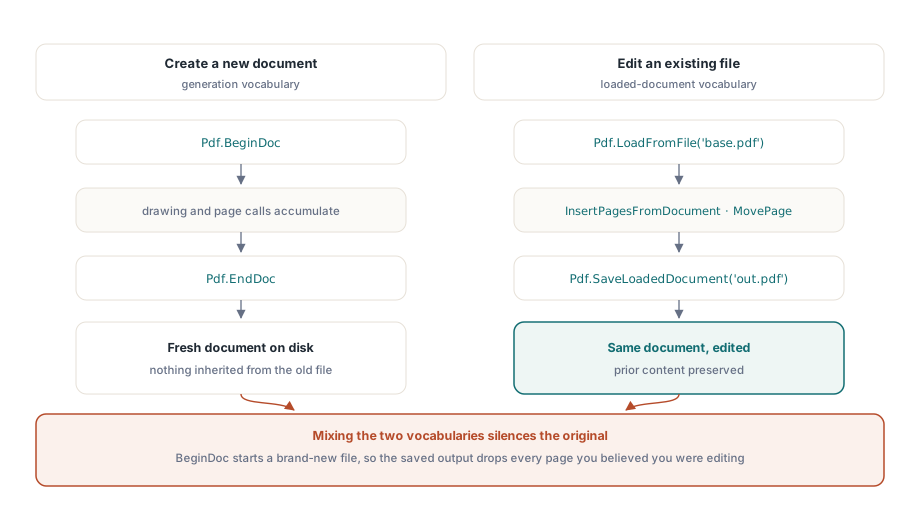
Ontwikkelaars die HotPDF voor het eerst via zijn generatie-API ontmoetten, neigen een bepaalde muur te raken. BeginDoc opent een splinternieuw document, wat het verkeerde gereedschap is wanneer u een reeds bestaand document wilt wijzigen. Een bestaand bestand bewerken loopt in plaats daarvan via de loaded-document-aanroepen:
PageCount := Pdf.LoadFromFile('base.pdf');
Pdf.InsertPagesFromDocument(OtherDoc, '1-3', 5);  // pages 1-3 after page 5
Pdf.MovePage(2, 5);
Pdf.SaveLoadedDocument('modified.pdf');
Meng de twee en het symptoom is een output-bestand dat uw nieuwe inhoud vasthoudt en niets van het origineel, omdat BeginDoc vrolijk een vers document bouwde naast datgene dat u meende te bewerken. Lees LoadFromFile met SaveLoadedDocument als één woordenschat en BeginDoc met EndDoc als een andere. Een routine die naar beide grijpt tegen hetzelfde bestand is vrijwel altijd fout
Wanneer een geappend bestand te compacteren
Append-only-opslaan draagt een trage kosten met zich mee. Een nachtelijkeklus die één statusregel op dezelfde PDF stempelt produceert 365 revisies over een jaar, en elke revisie sleept een nieuwe xref-sectie achter zich aan. Wanneer die geschiedenis haar nut heeft overleefd, en geen handtekening in het bestand hoeft te overleven, kunt u het geheel flattennen door het te reserialiseren via het loaded-document-pad:
Pdf.LoadFromFile('stamped.pdf');
Pdf.SaveLoadedDocument('compacted.pdf');
Deze resave is een volledige herschrijving. Het gooit opzettelijk de eerdere revisies weg en breekt elke handtekening die nog in het bestand zit, dus zet het achter dezelfde policy-poort die u op elke andere destructieve stap toepast. Eén productieregel die standhoudt: compacteer wanneer het revisie-aantal een drempel passeert, of wanneer de geappende overhead voorbij enig aandeel van het basisbestand groeit, en compacteer nooit een document wiens handtekeningspaneel er iets in heeft
De output controleren voordat hij verscheept
Dit paar features verifiëren is verfrissend concreet. Open het resultaat in Adobe Acrobat en bevestig drie punten: documenteigenschappen rapporteren PDF 1.5 of later zodra object streams aan staan; het handtekeningspaneel valideert nog steeds elke voorheen ondertekende revisie na een incremental update; en het pagina-aantal en de bladwijzers kwamen ongedeerd door een load-, modify- en save-cyclus. Voor archief-output, duw het bestand ook door veraPDF, want een gecomprimeerde xref is precies het soort structuur dat een strenge validator nauwkeuriger scrutiniseert dan een vergevingsgezinde viewer ooit zal doen. Als uw werk ook zeer grote inputs betreft, dan passen de inspectiemethoden in onze walkthrough van de Direct File API voor grote PDF-workflows natuurlijk bij incrementeel opslaan, en de handtekenings-machinerie achter de byte-ranges hierboven worden in diepte behandeld in het HotPDF-artikel over digitale handtekeningen en PAdES
Beide features worden geleverd als deel van de HotPDF Delphi Component voor Delphi en C++Builder, naast de generatie-, formulier-, versleutelings- en ondertekening-API's die elders op deze blog behandeld worden. De productpagina linkt de volledige API-referentie als u de aanroepen hierboven tegen uw eigen document-pipeline wilt afzetten