Voer een Russische factuur door een recognizer die het Cyrillische model laadt maar nog steeds het Chinese karakterwoordenboek leest, en je krijgt rijden perfect geldige Han-tekens terug. Elke regel is keurige UTF-8, elke regel belandt in de doorzoekbare tekstlaag, en een zoekopdracht naar een willekeurig woord op de pagina vindt niets. Het model heeft zijn werk gedaan. Een CTC-recognizer geeft nooit tekens terug, alleen klassenummers, en het woordenboekbestand is het enige dat klasse 1.204 aan een glyph koppelt
Drie verwante storingen liggen vlak in de buurt, en een demo in Latijns script laat er geen enkele zien: regels die hun laatste teken verliezen, Engelse tekst die zonder woordspatiering arriveert, en Arabische tekstvakken die van links naar rechts terugkomen. Elk ervan spoor je terug naar een woordenboekregel, een loopgrens of een sorteervolgorde die bijna goed staat. Alle vier beginnen op hetzelfde punt: de stap die een taaltag omzet naar een model en een woordenboek
RapidOCR-taalpresets in HotPDF: één tag, één vastgepind paar
In HotPDF zet THPDFRapidOCRDLLOptions.ForLanguage een taaltag om naar opties die naar <profile>/recognition.onnx en <profile>/dictionary.txt onder je modelmap wijzen. Alles daarvoor komt uit THPDFRapidOCRDLLOptions.Default: de gedeelde detector, de optionele hoekclassifier, één thread, een budget van 16.777.216 pixels per aanvraag en een timeout van 60 seconden. De tag wordt lowercase gemaakt, underscores worden koppeltekens en omliggende witruimte verdwijnt, dus 'zh_TW', 'ZH-tw' en ' zh-tw ' wijzen naar hetzelfde profiel
De matching verloopt tegen een expliciete aliaslijst, zonder prefixmatching. 'zh-Hant-TW' en 'zh-MO' worden geaccepteerd omdat ze op de lijst staan; 'pt-AO' niet, en ForLanguage gooit een EArgumentException voordat er ook maar één bestand wordt geopend. Die strengheid is bewust. Een prefixregel zou stilletjes 'zh-Hant-SG' of een toekomstige tag naar welk profiel dan ook sturen dat de eerste twee letters deelt, en bij Chinees vertellen de eerste twee letters je niets over het schrift
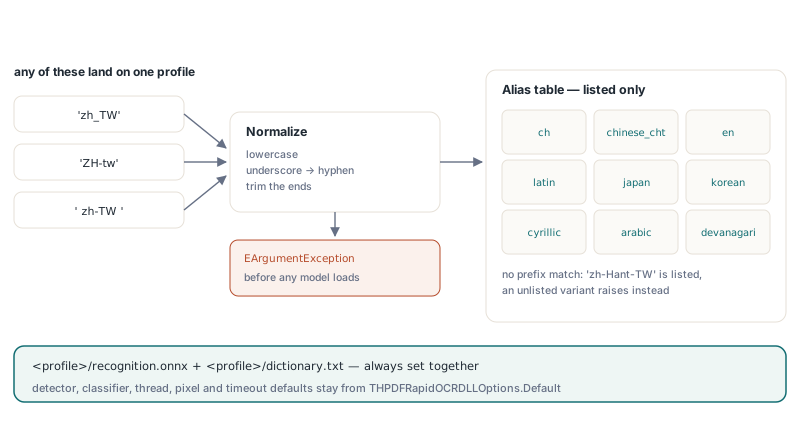
| Profiel | Talen | Voorbeeldtags | Vakvolgorde in een rij |
|---|---|---|---|
ch | Vereenvoudigd Chinees en Engels | zh, zh-CN, zh-Hans, chi_sim | Links naar rechts |
chinese_cht | Traditioneel Chinees | zh-TW, zh-HK, zh-Hant, chi_tra | Links naar rechts |
en | Engels | en, en-US, en-GB, eng | Links naar rechts |
latin | Frans, Duits, Spaans, Portugees, Italiaans, Nederlands, Turks | fr, de, es-419, pt-BR, tr | Links naar rechts |
japan | Japans | ja, ja-JP, jpn | Links naar rechts |
korean | Koreaans | ko, ko-KR, kor | Links naar rechts |
cyrillic | Russisch, Oekraïens, Bulgaars, Wit-Russisch | ru, ru-RU, uk, bg | Links naar rechts |
arabic | Arabisch, Perzisch, Urdu | ar, ar-SA, fa, ur | Rechts naar links |
devanagari | Hindi, Marathi, Nepali | hi, mr, ne | Links naar rechts |
De adapter downloadt nooit iets. De modellerichten worden één keer ingericht met de meegeleverde helper, bijvoorbeeld tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic, of -Language All voor alle negen profielen. De helper zet de gedeelde detector en classifier op de root-bestandsnamen die Default verwacht en elk profiel in zijn eigen map. Engine-aanmaak, de DLL-grens en threading komen aan bod in het artikel over de in-process RapidOCR-DLL; met de bestanden op hun plek wordt een scan in Vereenvoudigd Chinees als volgt doorzoekbaar
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, gedeelde detector en classifier
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // hier laden de modellen; hergebruik de engine voor meerdere documenten
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // lege paginalijst = elke pagina; SkipPagesWithText laat tekstpagina's met rust
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
Twee getallen in die uitvoer vragen om aandacht. De native pipeline geeft één resultaat per gedetecteerde tekstregel, dus AcceptedWordCount telt hier regels, en MinimumConfidence wordt vergeleken met de gemiddelde confidence van de hele regel: een regel die gemiddeld op 0.45 uitkomt wordt als geheel weggegooid. UniqueScalarCount is het aantal unieke Unicode-scalars dat de tekstlaag naar zijn font en ToUnicode-tabel moest mapperen. Een pagina Chinese lopende tekst moet dat aantal ruim voorbij de handvol scalars zetten die een Latijnse pagina nodig heeft; een telling in Latijns gebied bij een Chinese scan betekent meestal dat het verkeerde profiel geladen is
Waarom levert alleen het recognitiemodel wisselen rommel op?
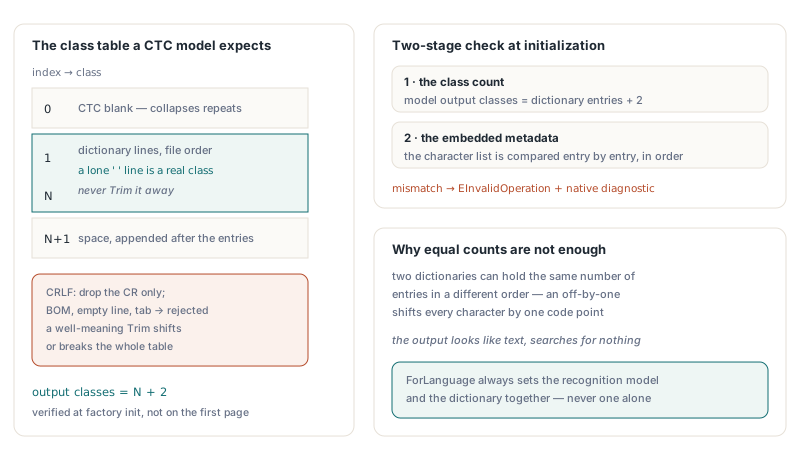
Want het model en het woordenboek zijn twee helften van één opzoektabel, en alleen het woordenboek weet wat de indexen betekenen. Wijs RecognitionModel naar cyrillic/recognition.onnx terwijl CharacterDictionary nog steeds het Chinese bestand noemt, en het model produceert geldige Cyrillische indexen die het oude woordenboek vertaalt in willekeurige Han-tekens. ForLanguage zet beide velden altijd samen. Handgebouwde opties moeten dezelfde regel volgen: verander er nooit één zonder de ander
De voor de hand liggende beveiliging, het aantal woordenboekregels vergelijken met de uitvoerbreedte van het model, is nodig en toch niet genoeg. Twee woordenboeken kunnen evenveel entries bevatten in een andere volgorde, en een off-by-one schuift elk karakter één positie op. De HotPDF RapidOCR-DLL controleert daarom tweemaal terwijl de factory de recognizer initialiseert. Het aantal uitvoerklassen van het model moet gelijk zijn aan het aantal woordenboekregels plus twee. Daarna, als het ONNX-bestand een character-metadatalijst bevat, wordt elke woordenboekregel er regel voor regel mee vergeleken. Elke mismatch laat HPDFCreateRapidOCRDLLOCREngine een EInvalidOperation gooien met de native diagnostic, zodat de fout bij het opstarten naar boven komt en niet in het archief van een klant
Die plus twee komt uit de klassenlayout. Klasse 0 is de CTC-blank, de klassen 1 tot N zijn de woordenboekregels in bestandsvolgorde, en de laatste klasse is een spatie. Sommige woordenboeken hebben ook zelf een losse spatie-entry staan, en die regel moet exact blijven zoals hij is. Hier doet een welwillende Trim echt schade: hij maakt van de spatie-entry een lege string en verschuift of breekt de tabel. De DLL stript een afsluitende carriage return zodat CRLF-bestanden laden, en weigert een UTF-8 byte order mark, een lege regel, of een entry met een tab of een verdwaalde carriage return
Onderhoud je eigen woordenboeken, dan vangt een pre-flightcheck in je build- of deploymentscript deze problemen op voordat de engine ze ziet. De functie hieronder is je eigen code, geschreven om de regels hierboven te spiegelen
// Eigen hulpfunctie, geen HotPDF-API: bouwt de klassentabel die een
// CTC-recognizer verwacht en weert de woordenboekdefecten die de DLL weert
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // newline aan het einde van het bestand
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // klasse 0: CTC-blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: alleen de CR laten vallen
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // nooit Trim: ' ' is een klasse
  end;
  Result[Last + 2] := ' ';                       // laatste klasse: spatie
  // Length(Result) moet gelijk zijn aan het aantal uitvoerklassen van het model
end;
Greedy CTC-decodering en de drie grensvalkuilen
Greedy CTC-decodering pakt bij elke tijdstap de klasse met de hoogste score, klapt opeenvolgende herhalingen samen tot één teken en laat de blank vallen. De blank is wat een echt verdubbeld teken laat overleven. Een recognitiemodel leest een tekstregel als een reeks smalle verticale plakjes, en per plakje geeft het voor elke klasse een waarschijnlijkheid. Een regel met AA中 kan de argmax-reeks A A blank A 中 space opleveren: de eerste twee A-stappen klappen samen tot één, de blank scheidt die van de volgende A, en de uitvoer is AA中 met de afsluitende spatie er nog aan. Zonder de blank-regel zou book net zo gedecodeerd worden als bok
Een decoder die te kort door de bocht nodigt uit tot off-by-one-fouten, en elke fout heeft zijn eigen herkenbare symptoom. Stop de innerlijke argmax-loop één klasse te vroeg en de spatieklasse kan nooit winnen, dus elke Engelse of Latijnse regel komt terug als één lang woord en zoeken op zinsneden staat stil. Stop de buitenste loop één tijdstap te vroeg en het laatste teken van elke regel verdwijnt, wat bij een label van twee tekens de helft van de tekst is. Vergeet de blank de herhalingswachter te laten resetten en verdubbelde tekens klappen ineen: de ll in hello, of het geredupliceerde 谢谢. Schrijf je zelf een decoder voor een eigen pipeline, dan vormen deze drie gevallen een compacte testset. De HotPDF-decoder pakt de laatste klasse en de laatste stap mee, houdt blank-gescheiden herhalingen vast, en weigert scores die niet eindig zijn of buiten 0 tot 1 vallen, plus elk klassenaantal dat niet klopt met het woordenboek
// Illustratie voor een eigen pipeline, geen HotPDF-API: greedy
// CTC-decodering met correcte grenzen. Scores bevat Steps * Classes
// waarschijnlijkheden, één rij per tijdstap
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // klasse 0 is de CTC-blank
  for Step := 0 to Steps - 1 do             // neem de laatste tijdstap mee
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // neem de laatste klasse (spatie) mee
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // een blank reset de herhalingswachter
  end;
end;
Beam search met een language model kan een paar dubieuze plakjes oplossen waar greedy decoding de fout ingaat, tegen een flinke prijs in snelheid en een tweede set bestanden om te versienummeren. Voor gedrukte documenten op 300 DPI is greedy decoding de juiste default, en de decoder is de verkeerde plek om te compenseren wat het model niet kan zien. Hetzelfde geldt voor vervangingstabellen voor tekens. Leest een model een letter met accent als zijn basisteken, dan repareert een vervangingstabel de ene taal en breekt ze de andere. Een verkeerd teken in een doorzoekbare laag is erger dan een ontbrekend, omdat zoeken dan het verkeerde document vindt in plaats van geen document, dus de herkende tekst gaat exact zoals het model hem produceerde de PDF in
Hoe worden tekstregels geordend voor recht-naar-links Arabisch?
De DLL sorteert gedetecteerde tekstvakken van boven naar beneden, groepeert vakken die verticaal voor ten minste de helft van de kleinere vakhoogte overlappen tot één rij, en ordent elke rij van links naar rechts, of van rechts naar links wanneer RightToLeft gezet is. De tekens in een herkende regel worden nooit omgekeerd. Rijgroepering is belangrijk omdat detectoren één visuele regel vaak opsplitsen in meerdere vakken, een label en een waarde met een wijde tussenruimte bijvoorbeeld, en een kale sortering op de bovencoördinaat zou ze met de volgende regel verweven zodra hun bovenranden een pixel of twee uit elkaar liggen
Het Arabische profiel is het enige waar ForLanguage RightToLeft := True zet, waarmee de DLL elke rij op de rechterranden van de vakken ordent, beginnend bij de rechtermarge. Dat is het hele effect. De tekst die het model voor een regel teruggeeft staat al in Unicode-logische volgorde, de volgorde waarin een Arabische lezer leest en typt, en dat is ook de volgorde waar PDF-tekstextractie en zoeken op rekenen. De string omdraaien zodat hij in de Delphi-debugger "goed oogt" breekt zoeken, kopiëren en plakken, en screenreaders. Bidirectionele weergave en glyph-shaping zijn het werk van de PDF-viewer
Eén engine dient één taalprofiel, en er is geen automatische scriptdetectie. Een document dat scripts mengt heeft per profiel een eigen engine nodig, elk toegepast op zijn eigen pagina's. ApplyLoadedOCRTextLayer neemt een expliciete paginalijst en commit elke aanroep als eigen transactie, dus een falende aanroep op de Arabische pagina's rolt terug zonder de Chinese laag die al geschreven was aan te tasten
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // geeft EArgumentException bij een niet-opgesomde tag, voordat er een model laadt
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // ruimte voor A3-pagina's op 300 DPI
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // chinese_cht-profiel
  Arabic := CreateRapidEngine('ar-SA');   // arabic-profiel, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
De MaxPixels-regel staat er niet voor niets. Het defaultbudget van 16.777.216 pixels per aanvraag dekt A4 en US Letter op 300 DPI met ruimte over. Een A3-blad op 300 DPI komt uit op zo'n 3508 bij 4961 pixels, ruwweg 17,4 miljoen, dus die aanvraag wordt geweigerd en Info.Diagnostic meldt een ongeldige aanvraag of pixelbudget. Verhoog MaxPixels tot het plafond van 67.108.864, of verlaag THPDFOCRTextLayerOptions.DPI voor grote formaten. De recht-naar-links-ordening loopt via de DLL-export HPDFRapidOCRSetReadingDirection, die de adapter alleen opzoekt wanneer RightToLeft gezet is; een DLL-build zonder die export dient de links-naar-rechts-profielen nog steeds, en het aanmaken van een Arabische engine ermee gooit een EArgumentException die de ontbrekende export noemt
Vastgepinde modelpakketten en wat een eigen paar moet doorstaan
De HotPDF RapidOCR-DLL linkt een statisch gebouwde ONNX Runtime, dus hij leest de ONNX-formaatversies die die runtime begrijpt en niets nieuwer. Recente modelexports kunnen een nieuwer bestandsformaat als doel hebben; zo'n bestand wordt bij engine-aanmaak geweigerd met een native diagnostic. Die koppeling is waarom elk taalpakket naar één specifieke recognizer en één woordenboek wijst die onder de meegeleverde runtime laden en de klassecontroles doorstaan, en waarom de pakketten nooit "latest" zijn
Install-RapidOCRModels.ps1 dwingt die koppeling op schijf af. Elk bestand in zijn manifest draagt een SHA256-hash. Een bestaand bestand met een andere hash stopt de installatie en blijft liggen om te verplaatsen of verwijderen, en elke download wordt onder een tijdelijke naam geschreven en pas op zijn plek gezet nadat zijn hash klopt. Dat blokkeert de stille variant van het woordenboekprobleem: iemand kopieert met de hand een nieuwere recognition.onnx in een profielmap, het klassenaantal blijkt toevallig te kloppen, en het eerste signaal van onrust is een klant die meldt dat zoeken woorden niet vindt die duidelijk op de pagina staan. Installeer je met -SkipClassifier, zet dan UseAngleClassifier := False in de opties, want Default verwacht het classifierbestand en engine-aanmaak controleert dat het bestaat
De recognizer controleert ook de invoervorm van het model bij het laden. Hij accepteert NCHW-floatinvoer met een vaste hoogte van 32 of 48 pixels, of een dynamische hoogte, die hij op 48 draait. Een model geëxporteerd met een andere vaste hoogte zakt bij engine-aanmaak door de mand met "Unsupported recognition model input or output shape"
Voor een schrift dat geen van de negen profielen dekt, kunnen RecognitionModel en CharacterDictionary naar je eigen bestanden wijzen, en elke controle hierboven geldt nog steeds. Een mismatchend paar faalt bij engine-aanmaak, in je eigen testrun. Voor pagina's waar geen RapidOCR-profiel past, plugt de Tesseract-adapter voor doorzoekbare PDF in dezelfde ApplyLoadedOCRTextLayer-aanroep, en voor machinedrukte ASCII-formulieren heeft de ingebouwde template-matching-OCR-engine helemaal geen modellerichten nodig
Taalpresets, de native RapidOCR-adapter en de OCR-tekstlaag zitten allemaal in de HotPDF Delphi PDF Component voor Delphi-, C++Builder- en Windows FPC/Lazarus-projecten