Een pipe die nooit end-of-file meldt is een eigenaardige bug om na te jagen in een OCR-functie. Eén thread in je applicatie leest de standaarduitvoer van een helperprogramma en wacht tot ReadFile faalt met ERROR_BROKEN_PIPE. Een andere thread start tesseract.exe via CreateProcess met bInheritHandles op True, want zo geef je een childproces een bestand mee voor zijn standaardfout. Het pipe-schrijfeinde van de helper was overneembaar, dus Tesseract bezit nu een kopie, en de lezende thread hangt tot Tesseract klaar is met zijn pagina — wat, op een 300 DPI-scan met twee taalmodellen geladen, niet snel gaat
Een externe recognizer brengt meer mee dan de hang: wat het kind kan zien, wat te doen met halfgeldige uitvoer, en hoe pixelboxen in doorzoekbare PDF-tekst worden omgezet. De ingebouwde template-matching-OCR-engine dekt met opzet machinedrukte ASCII-letters en cijfers. Namen met accenten, Chinese contracten en meertalige archieven hebben getrainde taalmodellen nodig, en Tesseract is de gebruikelijke kandidaat omdat het een commandline-programma is dat je naast je executable kunt installeren
Tesseract aansluiten op de HotPDF-OCR-tekstlaag
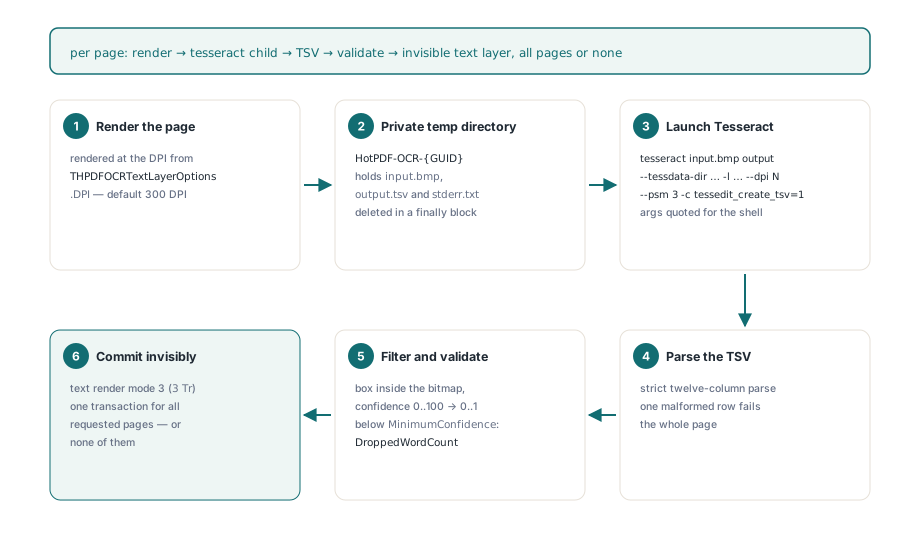
HotPDF wikkelt een lokaal geïnstalleerde Tesseract-executable als IHPDFOCREngine via HPDFCreateTesseractOCREngine in de unit HPDFTesseractRecognition. Je geeft die engine mee aan THotPDF.ApplyLoadedOCRTextLayer, die elke gevraagde pagina rendert, Tesseract één keer per pagina draait, de woorden filtert en in één transactie een onzichtbare Unicode-tekstlaag voor elke gevraagde pagina wegschrijft, of voor geen enkele. Coördinaatmapping, rotatie, confidence-filtering en de commit zijn de pipeline die de ingebouwde engine al gebruikt; alleen de herkenning verandert
De factory gooit een EArgumentException voordat er ook maar één pagina wordt aangeraakt. De executable en de tessdata-map moeten bestaan, de time-out moet tussen 1 en 3.600.000 milliseconden liggen, en de taal mag alleen ASCII-letters, cijfers, _ en + bevatten, want hij belandt op een commandoregel: eng+chi_sim is legitiem, een waarde met quotes of spaties is een injectie die wacht om te gebeuren. Een tweede overload neemt een THPDFTesseractOptions-record. Zijn Default geeft --psm 3, --oem 3, 60 seconden per pagina en een grens van 16.777.216 pixels, en hij weigert tpsOSDOnly en tpsAutoOnly, de twee modi die geen woorden teruggeven
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16.777.216 px
  TessOptions.TimeoutMilliseconds := 120000;    // geldt per pagina
  // geeft EArgumentException bij een ontbrekende executable of tessdata-map,
  // een foutieve taalidentificator of opties buiten hun bereiken
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // modellen samengevoegd met '+'
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // een lege paginalijst betekent elke pagina; pagina's die al tekst hebben worden overgeslagen
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
Reken de pixelrekenkunde één keer uit. Een A4-pagina op 300 DPI is zo'n 2481 bij 3508 pixels, ruwweg 8,7 miljoen, en past. Een A3-pagina op dezelfde resolutie is zo'n 3508 bij 4961, dik 17,4 miljoen, dus hij faalt met een pixelbudget-diagnostic en de run eindigt als otlsEngineError. De overload die alleen een time-out neemt past helemaal geen pixelgrens toe. Voor een dienst die bestanden van buiten accepteert, houd de options-overload aan en verhoog MaxPixels (tot 67.108.864) of verlaag THPDFOCRTextLayerOptions.DPI bewust wanneer grote formaten worden verwacht
Per pagina maakt de engine een privé HotPDF-OCR-{GUID}-map onder het temp-pad aan, slaat de bitmap op als input.bmp en draait tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1, met --oem erbij wanneer een engine-modus is gezet. Paden worden gequote met de Windows-regels voor backslashes en ingebedde quotes, en --dpi draagt de renderresolutie zodat Tesseract hem nooit hoeft te gokken. Tesseract en zijn .traineddata-bestanden worden niet gebundeld; die provisioning is het werk van de applicatie. Op onze eigen Linux-testmachines draait de recognizer vanuit een user-level bundel van de binary, zijn shared-library-closure en de tessdata-map, want op /usr/bin/tesseract vertrouwen werkt alleen waar iemand het systeempakket heeft geïnstalleerd
Waarom leegt één kapotte TSV-rij de hele pagina?
De Tesseract-adapter laat de hele pagina vallen bij de eerste misvormde rij, want een gedeeltelijk geparsde woordenlijst produceert een tekstlaag die niet met de afbeelding klopt, en niets in de opgeslagen PDF zegt welke woorden zijn zoekgeraakt. De uitvoer moet decoderen als strenge UTF-8 zonder ingebedde NUL. De eerste regel moet gelijk zijn aan de header van Tesseract met twaalf kolommen, level tot text, nadat een optionele byte order mark is gestript. Elke rij moet splitsen in exact twaalf velden, en de splitsing stopt na de elfde tab, dus een tab in de herkende tekst belandt in het tekstveld in plaats van een dertiende kolom te maken, waar de controle op stuurtekens hieronder hem vervolgens afwijst
Alleen level 5-rijen zijn woorden; pagina-, blok-, alinea- en regelrijen worden overgeslagen, net als woorden die leeg zijn of pure witruimte. Een woord met een stuurteken (onder U+0020, of U+007F tot U+009F) laat de pagina vallen. De rest heeft integer-geometrie nodig, een confidence geparsd met invariante opmaak zodat een applicatie met een Duitse locale nog steeds 93.5 leest, een box volledig binnen de bitmap, en een confidence van 0 tot 100. Eén geldig woord gevolgd door één kapotte rij levert nul woorden op
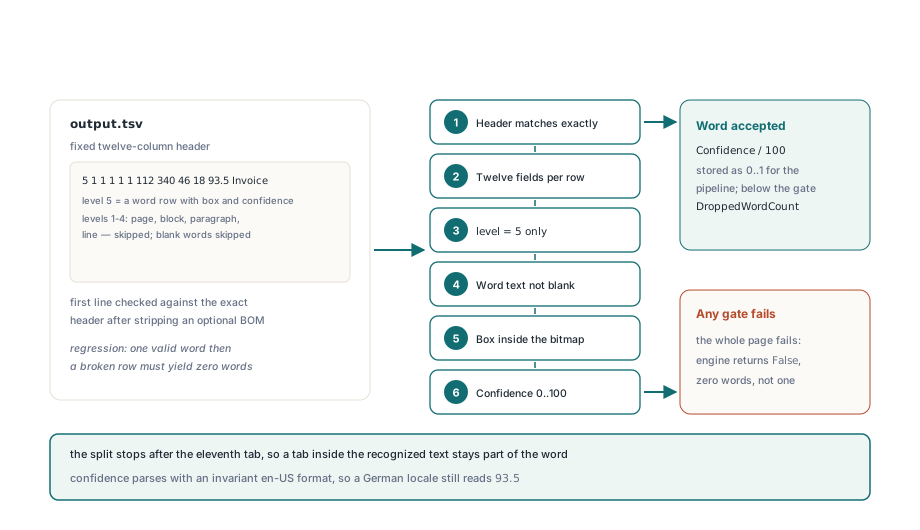
Eén vreemde rij laat dus de hele run vallen en laat elke pagina onaangetast. Dat is de juiste afweging. Een herhaling is goedkoop; een doorzoekbare PDF waarin een zoektocht naar een factuurnummer net de enige pagina mist die telt, komt doorgaans maanden later naar boven, in andermans handen
De laatste stap ontmoet ook een default die je misschien niet verwacht. Tesseract meldt confidence van 0 tot 100, de pipeline deelt door 100, en THPDFOCRTextLayerOptions.MinimumConfidence staat default op 0.5, dus elk woord onder de 50 belandt in Info.DroppedWordCount in plaats van op de pagina. Op een schone scan is die vloer zinnig. Op een ruisige fax kan hij een groot deel van de tekst weghalen, dus vergelijk Info.ReceivedWordCount met Info.AcceptedWordCount voordat je hem verlaagt
OCR opnieuw draaien op een bestand dat al tekst heeft
SkipPagesWithText staat default op True, en dat vangt mensen bij de tweede keer. Stel dat een batch met eng is verwerkt en nu eng+deu nodig heeft: elke pagina draagt al onzichtbare tekst, dus Info.SkippedPageCount is gelijk aan het aantal pagina's. HotPDF markeert de content stream die hij schrijft als zijn eigen OCR-laag, en ReplaceExistingOCRTextLayer gebruikt die markering om die pagina's opnieuw te herkennen, de oude laag te laten vallen en de originele pagina-inhoud te houden
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // wissel onze eerdere laag om
Options.UseOptionalContentGroup := True;      // laag genaamd 'OCR Text Layer'
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
Een bestand dat door een scannerdriver is ge-OCR'd draagt zo'n markering niet, dus zijn pagina's tellen nog steeds als pagina's met tekst. SkipPagesWithText uitzetten zou een tweede onzichtbare laag op de eerste stapelen, en elke zoektreffer zou dubbel verschijnen. Laat die bestanden met rust
Welke handles erft het Tesseract-proces over?
Het Tesseract-childproces erft exact twee handles van HotPDF: één geopend op NUL voor standaardinvoer en -uitvoer, en één voor stderr.txt in de privémap. De pipe-hang hierboven komt van CreateProcess zelf: bInheritHandles = True is nodig om standaardhandles door te geven, en op zichzelf geeft hij elke overneembare handle in de host door, inclusief pipes, bestanden en events geopend door ongerelateerde code. HotPDF gebruikt STARTUPINFOEX met een attributenlijst die PROC_THREAD_ATTRIBUTE_HANDLE_LIST en de vlag EXTENDED_STARTUPINFO_PRESENT draagt. bInheritHandles blijft True, maar alleen de opgesomde handles steken over
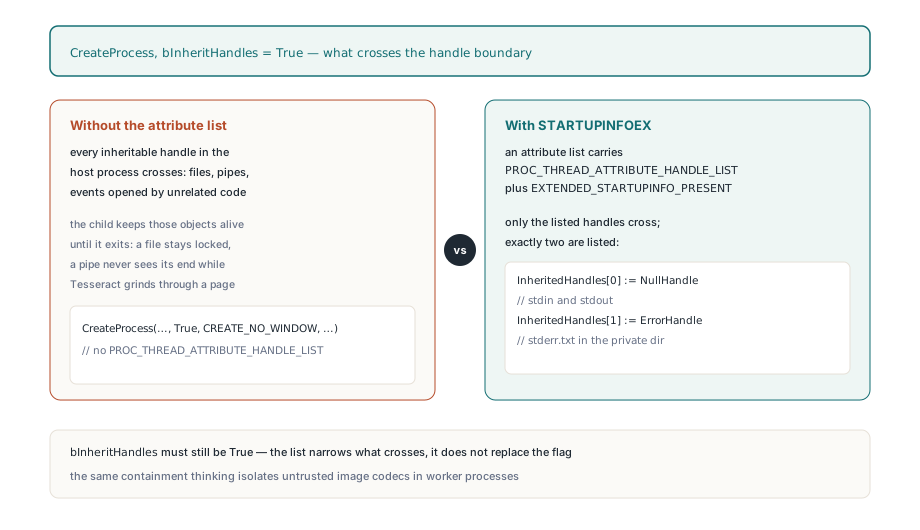
Hetzelfde patroon hoort in elk ander childproces dat je applicatie start, want één launcher die alles overneemt is genoeg om elke pipereader in het proces te laten hangen:
// Patroon voor je eigen CreateProcess-aanroepen (fragment: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir en ProcessInfo zijn elders gedeclareerd).
// Oudere Delphi-RTL's declareren de attributenlijstfuncties niet; voeg je eigen
// external-declaraties uit kernel32 toe als de compiler ze niet kan vinden
// Controleer elke BOOL-uitkomst in productiecode
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // gemaakt met bInheritHandle = True
  HandleList[1] := ErrorHandle;        // idem
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... zet dwFlags en hStdInput / hStdOutput / hStdError zoals gewoonlijk ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // ook met een handlelijst vereist
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // nadat het child afsluit: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
Bridge-scripts voegen nog een Windows-detail toe. Een Python-launcher kan een tweede interpreterproces starten, en het proces dat je maakte beëindigen laat dat ene draaien. Krijgt de engine een scriptpad, zoals de RapidOCR-adapter hieronder, dan start HotPDF het child gesuspendeerd, wijst het toe aan een job object met JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE en hervat het daarna, zodat het sluiten van de job de hele boom beëindigt. Hetzelfde inperkingsidee drijft PDF-image-codecs isoleren in werkerprocessen, waar het kind niet wordt vertrouwd; hier wordt het kind vertrouwd, maar jouw proces is niet de enige code die er handles in vasthoudt
Annulering, time-outs en de alles-of-niets-commit
IHPDFOCREngine.Recognize geeft één Boolean terug, en False dekt zowel "Tesseract faalde" als "de gebruiker drukte op Annuleren". De adapter polst de token en zijn time-out elke 25 milliseconden terwijl Tesseract draait, en bij annulering ruimt hij op en geeft False terug. Letterlijk genomen zou dat als otlsEngineError lezen, dus ApplyLoadedOCRTextLayer controleert de token eerst telkens als Recognize False geeft. Herkenning en contentconstructie ronden voor elke gevraagde pagina af voordat de documenttransactie opent, dus een annulering op pagina 40 van 50 meldt otlsCancelled en laat alle 50 pagina's zoals geladen. De andere limieten volgen dezelfde stijl:
- De time-out loopt vanaf het begin van elke
Recognize-aanroep, dus de default van 60.000 ms is een limiet per pagina - Een child dat bij time-out of annulering nog draait wordt beëindigd en tot 5 seconden afgewacht; de privémap wordt in een
finally-blok verwijderd, met het verwijderen tot een seconde herhaald omdat uitvoerbestanden kort vergrendeld kunnen blijven nadat het proces eindigt output.tsvis afgekapt op 64 MiB enstderr.txtop 1 MiB, gecontroleerd terwijl het child draait en nadat het eindigt- Woorden en UTF-16-code-eenheden per pagina worden begrensd door wat resteert van
MaxWordsPerPage,MaxTotalWordsenMaxTextCodeUnits; eroverheen gaan laat de run vallen in plaats van de lijst af te kappen - Een exitcode ongelijk nul komt terug met tot 4.096 tekens uit
stderr.txt, de snelste manier om te leren dat een.traineddata-bestand ontbreekt
Hoe de onzichtbare tekstlaag er binnen de pagina uitziet
HotPDF schrijft de woorden met tekstweergavemodus 3 (noch vulling noch omlijning, ISO 32000-1 §9.3.6), dus de scan blijft zichtbaar terwijl zoeken en kopiëren op de woorden werken. De content stream opent BT met 3 Tr; elk woord krijgt een Tm-matrix op zijn basislijn, een fontgrootte van boxhoogte in pixels keer 72 gedeeld door de render-DPI, en een Tz-schaal die de run uitrekt naar de boxbreedte. Die rek houdt een zoekhighlight op het woord in de afbeelding
De TSV heeft boxen maar geen baselines, dus elke basislijn wordt op één vijfde van de boxhoogte boven de onderrand geplaatst. Tussen naburige woorden op een links-naar-rechts-regel in scripts met spatiescheiding zoals Latijns of Cyrillisch vult een uitgerekte spatie de opening, dus gekopieerde tekst houdt zijn woordgrenzen; Chinees krijgt die niet. Glyphs gaan door een gedeeld, niet-ingebed Type0-font met Identity-H-encoding en een gegenereerde ToUnicode-CMap, één CID per uniek Unicode-scalar, en zo overleven Chinees, Latijns met accenten en supplementary-plane-tekens kopiëren en zoeken. Eén run houdt tot 65.535 unieke scalars vast, en omdat ISO 19005 ingebedde fonts eist, heeft PDF/A-uitvoer een apart ingebed conforming font nodig. Om een resultaat te controleren, opslaan, herladen en het gewone pad uit tekst uit een geladen PDF extraheren in Delphi draaien; komen de verwachte woorden terug op de verwachte pagina's, dan is de laag echt
RapidOCR en de native DLL op hetzelfde contract
Voor scans in Vereenvoudigd Chinees hergebruikt HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds) dezelfde processrunner en TSV-parser. Het bridge-scriptpad volgt de Python-executable en de taal is vastgelegd op chi_sim. HotPDF verscheept de bridge als tools/OCR/rapidocr_tsv.py; hij heeft de pakketten rapidocr en onnxruntime nodig, lokale ONNX-modellen en een fontbestand, weigert automatische downloads, en schrijft Tesseract-vormige TSV; een THPDFRapidOCROptions-overload zet modelbestanden, threadaantallen en een pixelgrens. De generieke factory achter beide adapters, HPDFCreateLocalTSVOCREngine in HPDFLocalTSVRecognition, accepteert elk programma dat de Tesseract-achtige argumenten neemt en de TSV van twaalf kolommen schrijft, en hij erft de handlelijst, de time-out, de annulering en de budgetten
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language) laadt de Tesseract C API in-process, meldt Tesseract (native DLL), controleert vooraf dat elk gevraagd .traineddata-bestand bestaat, en mapt annulering en time-out op de eigen progress monitor van Tesseract. Hij spaart een processtart en een BMP-omweg per pagina uit; de executable houdt de crashes en geheugengroei van de recognizer buiten je adresruimte. Voor een desktop-tool die aan de eigen scans van de gebruiker werkt is de DLL prima. Voor een dienst die documenten van vreemden opneemt is de commandline-engine de veiligere keuze. Hoe dan ook draait de herkenning op Windows, één pagina per keer, op de gerenderde bitmap, dus richt en maak moeilijke scans schoon voordat ze de engine bereiken
De OCR-adapters, de tekstlaagschrijver, de renderer die ze voedt en de extractie die de uitvoer controleert wonen allemaal in één native VCL-component voor Delphi en C++Builder. Als je capture- of archiveringsapplicatie doorzoekbare PDF-uitvoer nodig heeft, dekt de HotPDF Delphi PDF-component alles behalve de OCR-engine die je zelf installeert