TerminateThread lijkt de voor de hand liggende manier om een OCR-aanroep te stoppen die al langer op één gescande pagina staart dan je UI wil wachten. De Windows-documentatie legt uit waarom dat niet werkt: houdt de doeldraad de process heap lock vast, dan wordt die lock nooit meer vrijgegeven, en de volgende allocatie op elke andere thread kan voor eeuwig blokkeren. Zodra OCR in je eigen proces draait, is de enige veilige stop een coöperatieve, op checkpoints tussen inferentiefasen, en dat is de prijs die je betaalt voor het één keer laden en warm houden van de ONNX-modellen
Het alternatief dat de meeste Delphi-teams als eerste proberen is een childproces. Een Python-werker per pagina kan op elk moment worden neergeschoten, wat aantrekkelijk is, maar elke aanroep start een interpreter, importeert zijn runtime en laadt detectie- en recognitiemodellen voordat hij één pixel leest. Stel dat een archiefklus 500 pagina's telt: dat opstartwerk draait dan 500 keer, en de deployment bevat voortaan een Python-omgeving naast een native executable
Zoekbare PDF uit scans met HPDFCreateRapidOCRDLLOCREngine
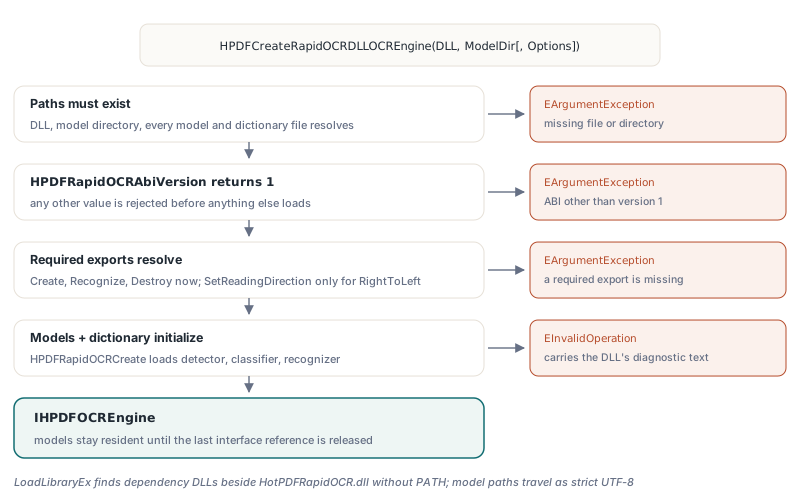
HotPDF draait RapidOCR in-process via HPDFCreateRapidOCRDLLOCREngine, gedeclareerd in de unit HPDFRapidOCRRecognition. De factory laadt HotPDFRapidOCR.dll, initialiseert de ONNX-detectie, de optionele hoekclassificatie en de recognitiemodellen één keer, en geeft een IHPDFOCREngine terug. Die engine plugt in THotPDF.ApplyLoadedOCRTextLayer precies zoals de andere OCR-engines: het document rendert elke pagina, de DLL draait CPU-inferentie erop, en het resultaat wordt gecommit als een onzichtbare Unicode-tekstlaag. Geen Python, geen childproces. De adapter wordt meegeleverd voor Delphi-, C++Builder- en Windows FPC/Lazarus-builds
Validatie gebeurt in de factory, voordat er ook maar één pagina wordt aangeraakt. Elk model- en woordenboekbestand moet resolvbaar zijn, HPDFRapidOCRAbiVersion moet 1 teruggeven, en de vereiste exports moeten bestaan voordat HPDFRapidOCRCreate de modellen bouwt. Configuratiefouten gooien een EArgumentException; een model dat weigert te laden gooit een EInvalidOperation met de eigen diagnostic van de DLL, bijvoorbeeld een woordenboek dat niet bij het recognitiemodel hoort
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Modellen laden hier, buiten elke recognition-deadline.
  // Relatieve namen in THPDFRapidOCRDLLOptions.Default worden
  // tegen de modelmap geresolved
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // lege paginalijst = elke pagina; SkipPagesWithText staat default op True
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFRapidOCRDLLOptions.Default noemt ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx en ppocr_keys_v1.txt, met één CPU-thread, een invoerlimiet van 16.777.216 pixels en een deadline van 60.000 ms per recognition-aanroep. Voor andere schriften houdt THPDFRapidOCRDLLOptions.ForLanguage die defaults aan en wisselt hij <profile>/recognition.onnx plus <profile>/dictionary.txt in voor een van negen profielen, van Traditioneel Chinees en Cyrillisch tot Arabisch en Devanagari. Elke engine leest één taal; kies het profiel per pagina of per document. Waarom model en woordenboek altijd als paar reizen, staat in RapidOCR-meertalige modellen en CTC-woordenboeken in HotPDF
De engine meldt zich als RapidOCR (native DLL) in Info.EngineName. Log die string. Draait dezelfde service ook de adapter voor het externe Tesseract-OCR-proces of de ingebouwde template-matching-OCR-engine, dan is dat de snelste manier om te zien welke recognizer een slechte pagina produceerde
Waarom spreekt de C ABI alleen int32_t en UTF-8-bytes?
De grens van HotPDFRapidOCR.dll gebruikt vaste-breedte-integers, ruwe pointers en expliciete bytelengtes, want Delphi, C++Builder en Free Pascal delen met MSVC niets anders dan de C-aanroepconventie. Een std::string, een std::vector of een C++-exception draagt een geheugenlayout en een unwindingmodel die bij één compiler en één runtimebibliotheek horen, en laat je er één ervan naar Pascal-code crossen, dan eindigt dat in een gecorrumpeerde stack of een heapblok dat door de verkeerde allocator wordt vrijgegeven
ABI-versie 1 is een korte lijst regels. Elke export is cdecl en geeft een int32_t-status terug: 1 voor succes, 0 voor mislukking. Elke functie die kan falen neemt een diagnostische buffer in eigendom van de aanroeper plus zijn grootte in bytes mee, en de DLL schrijft een met NUL afgesloten UTF-8-boodschap die op de beschikbare ruimte wordt afgekapt. Binnenin de DLL zit elke exportbody in een try met zowel catch (const std::exception &) als catch (...). Een ONNX Runtime-fout, een OpenCV-assertie of een misvormd woordenboek wordt status 0 plus tekst
| Export | Rol | Wanneer de adapter hem resolved |
|---|---|---|
HPDFRapidOCRAbiVersion | Geeft 1 terug; elke andere waarde wordt geweigerd | Direct nadat de DLL laadt |
HPDFRapidOCRCreate | Laadt detectie, optionele classificatie, recognitiemodellen en het woordenboek | In de factory |
HPDFRapidOCRRecognize | Draait één bitmap en geeft één callback per tekstregel | In de factory |
HPDFRapidOCRDestroy | Geeft de modelinstantie vrij | In de factory |
HPDFRapidOCRSetReadingDirection | Optionele rechts-naar-links-rijvolgorde | Alleen wanneer RightToLeft gezet is |
Die reading-direction-export wordt met opzet lazy geresolved, zodat een DLL zonder die export nog steeds elke links-naar-rechts-aanvraag bedient. De adapter laadt de library met LoadLibraryEx en zoekvlaggen die de eigen map van de DLL plus de default veilige mappen dekken; ONNX Runtime- of OpenCV-dependencies naast HotPDFRapidOCR.dll worden gevonden zonder aan PATH te tornen. Model- en woordenboekpaden steken de grens over als UTF-8, en de DLL zet ze met MultiByteToWideChar in strict mode om voordat hij bestanden opent via wide-character-API's. Een modelmap onder C:\Users\Łukasz of een Cyrillische gebruikersnaam opent gewoon
Eén regel leeft in de buildbestanden in plaats van in de header. De DLL linkt ONNX Runtime en OpenCV statisch, en het CMake-project default naar de statische release-CRT (/MT). Meng je statische libraries die tegen /MD gecompileerd zijn erdoorheen, dan krijg je bij geluk linkfouten en bij tegenslag twee onafhankelijke heaps. Voorzie libraries die in dezelfde CRT-modus zijn gebouwd als de DLL
Wat gebeurt er tussen een TBitmap en een tekstregel?
HotPDF geeft de DLL een onafhankelijke top-down BGR-kopie van de gerenderde pagina, en de DLL geeft per herkende regel één callback terug. De tekst in die callback is geleend: de pointer is alleen geldig tot de callback terugkeert, dus de adapter kopieert hem ter plekke
Op Delphi komt de snapshot uit een privé-TBitmap die op pf24bit wordt gedwongen en met GetDIBits wordt gelezen via een negatieve biHeight. Dat levert top-down rijen op met padding op vier-byte-uitlijning, en de stride reist als expliciet argument naar de DLL. Op FPC leest de adapter via CreateIntfImage. De bitmap van de aanroeper wordt nooit gewijzigd. Groottecontroles draaien voordat de kopie wordt gealloceerd: ten hoogste 32.767 pixels per zijde, en in totaal niet meer dan MaxPixels, wat default op 16.777.216 staat en tot 67.108.864 kan worden verhoogd
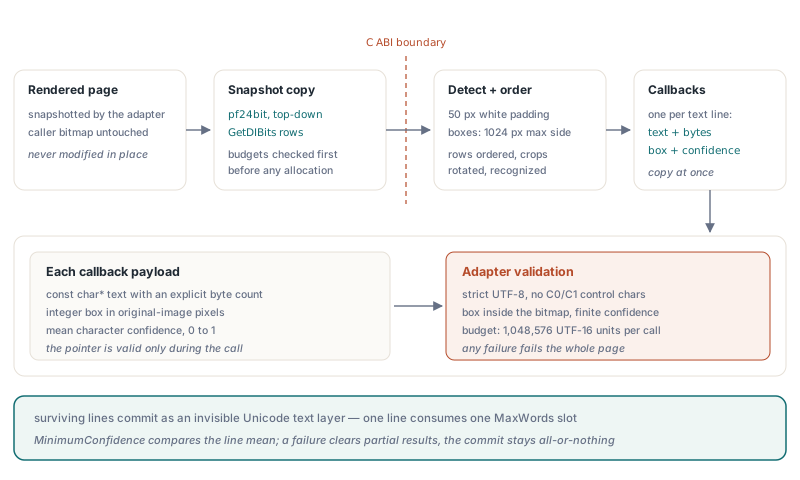
Binnenin de DLL krijgt de afbeelding een witte rand van 50 pixels, tekstregio's worden gedetecteerd met de langste zijde geschaald tot ten hoogste 1.024 pixels, en de vakken worden gesorteerd in horizontale rijen. Met de hoekclassifier aan wordt een crop alleen 180 graden gedraaid als de onderste-boven-score boven 0.9 uitkomt, waardoor een zwakke voorspelling geen korte woorden omdraait. Elke regel arriveert dan als een const char*, een bytelling, een integer-vak in pixels van de originele afbeelding en de gemiddelde karakterconfidence. De adapter is streng in wat hij accepteert:
- UTF-8 wordt gedecodeerd met
MB_ERR_INVALID_CHARS, dus een misvormde bytesequentie laat de pagina falen in plaats van vervangingstekens in een doorzoekbare laag te planten - C0- en C1-stuurtekens worden geweigerd; regels met alleen witruimte worden overgeslagen
- Het vak moet binnen de bitmap liggen, en de confidence moet een eindige waarde van 0 tot 1 zijn
- Tekst telt mee voor de
MaxTextCodeUnitsvan de aanvraag, met een hard plafond van 1.048.576 UTF-16-units per aanroep; tekens buiten het Basic Multilingual Plane kosten twee units - Een Pascal-exception binnen de callback wordt daar gevangen, bewaard en omgezet in een return 0, waarmee de DLL stopt; de bewaarde boodschap wordt
Info.Diagnostic
Twee van die details tellen als je de uitvoer tuneert. De eenheid is een regel, geen woord: elke regel neemt één MaxWords-slot, Info.AcceptedWordCount en Info.DroppedWordCount tellen regels, en een zoektreffer highlight de hele regelbox. En MinimumConfidence wordt vergeleken met de gemiddelde karakterconfidence van de regel, dus één vlekkerig teken tussen twintig schone laat de regel zelden zinken. De drempel naar 0.7 of 0.8 gooien laat hele regels vallen, nooit losse tekens. Een lege pagina slaagt met nul regels, en elke mislukking gooit partiële resultaten weg, zodat de multi-page-commit all-or-nothing blijft
Eén engine, één modelkopie, één aanroeper tegelijk
Elke RapidOCR-DLL-engine bezit precies één modelinstantie voor zijn hele levensduur, en Recognize-aanroepen op die engine worden geserialiseerd door een critical section. Het vasthouden aan de IHPDFOCREngine-reference houdt de modellen in het geheugen, dus batchwerk maakt de engine één keer aan en hergebruikt hem voor elk document
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // rechtopstaande scans: geen classifiermodel geladen
  Models.Threads := 4;                   // 1..64, begrensd op het aantal actieve processors
  Models.TimeoutMilliseconds := 120000;  // per Recognize-aanroep, coöperatief
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end;  // laatste reference vrijgegeven: modellen vernietigd, daarna de DLL ontlast
Threads zet zowel het intra-op- als het inter-op-aantal threads van elke ONNX-sessie in de engine, en de DLL begrenst het op het aantal actieve processors. Twee threads die één engine delen draaien nooit parallel inferentie; de tweede wacht. Dat wachten is geen blinde EnterCriticalSection. De adapter probeert de lock met TryEnterCriticalSection, slaapt 25 ms tussen pogingen en controleert elke keer het cancellation token en de deadline, zodat een wachtende aanvraag nog steeds geannuleerd kan worden
De deadlineklok begint te lopen zodra Recognize wordt betreden, voordat de lock wordt gepakt. Tijd die in de wachtrij achter een andere pagina doorbrengt telt mee voor TimeoutMilliseconds. Met vier werkerthreads op één engine en een deadline van 60 seconden kan de vierde pagina time-outen zonder ooit het model te bereiken. Geef elke werker liever zijn eigen engine. Het kost één kopie van de modellen in het geheugen per engine, en dat geheugen koopt voorspelbare time-outs en echte paralleliteit; één engine delen is alleen zinvol als aanvragen zeldzaam genoeg zijn dat ze vrijwel nooit in de wachtrij belanden
Waarom kan een native OCR-aanroep niet midden in de inferentie worden gedood?
Een native RapidOCR-aanroep kan niet midden in de inferentie worden gedood omdat hij op jouw thread draait, binnen jouw proces, midden in een ONNX Runtime-sessie die voor een lopende Run geen onderbrekings-API heeft. Annulering in de DLL-adapter is coöperatief. De DLL roept een abort-callback aan voor en na detectie, na de classificatie van elke crop en na elke herkende regel, en stopt bij het eerste checkpoint waar de callback 0 teruggeeft. Eén Run die al gestart was, maakt eerst af
De geforceerde opties zijn erger dan wachten. TerminateThread zou de CRT heap lock, de thread pool van ONNX Runtime en elke OpenCV-state achterlaten in de toestand waar ze zich toevallig in bevonden. FreeLibrary aanroepen terwijl een aanroep nog draait ontlast code die op de stack staat. Allebei zijn onveilig te maken, dus de adapter probeert het nooit. Een verlopen deadline komt terug als otlsEngineError met een time-out-diagnostic; een geannuleerd token komt terug als otlsCancelled:
// De token wordt door de aanroeper gemaakt en gedeeld met de UI-thread,
// die Token.Cancel aanroept als de gebruiker op Stop drukt
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // gestopt bij het volgende fase- of regel-checkpoint; document onveranderd
        Writeln('Cancelled');
      otlsEngineError:
        // omvat een coöperatieve deadlineoverschrijding en native diagnostics
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // een pagina-, pixel-, woord- of inhoudlimiet in Options werd bereikt
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
Dit is de echte afweging tussen de procesadapters en de in-process-DLL, en geen van beide wint elke rij:
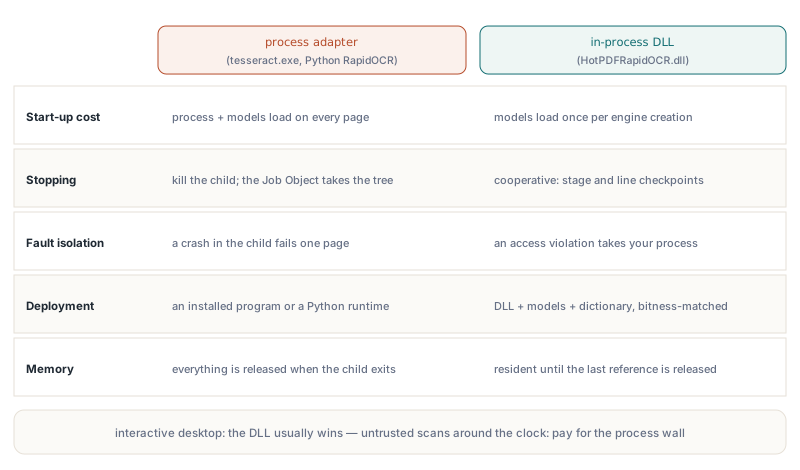
- Opstartkosten: de Tesseract- en Python RapidOCR-adapters starten een proces en laden modellen voor elke pagina; de DLL laadt modellen één keer per engine
- Stoppen: een childproces kan zonder meer worden beëindigd, en de Python-werker draait in een kill-on-close Job Object zodat zijn hele procesboom meesterft; de DLL stopt bij fase- en regel-checkpoints
- Fault containment: een crash in
tesseract.exelaat één pagina falen; een access violation binnen de DLL trekt uw proces neer - Deployen: procesadapters hebben een geïnstalleerd programma of een Python-omgeving nodig; de DLL heeft zichzelf, zijn modellen en zijn woordenboek nodig, gematcht op de bitness van de applicatie
- Geheugen: een procesadapter geeft alles vrij zodra het child afsluit; een DLL-engine houdt zijn modellen resident tot de laatste interfacereference verdwijnt
Kies de DLL voor een interactieve desktopapplicatie die pagina voor pagina OCR't en een responsieve Stop-knop nodig heeft die binnen één inferentiefase terugkeert. Voor een server die rond de klok niet-vertrouwde scans verwerkt, betaal je de opstartkosten per pagina en houd je de procesgrens aan; een vervaardigde afbeelding die een recognizer doet crashen hoort één pagina te kosten, en met een childproces kost hij dat ook
HotPDFRapidOCR.dll bouwen en modellen kiezen
HotPDFRapidOCR.dll wordt gebouwd uit de C++-sources in Native/RapidOCR met MSVC, C++17, een Windows SDK en CMake 3.20 of nieuwer. De helper tools/Build-HotPDFRapidOCR.ps1 neemt de native source, ONNX Runtime- en OpenCV-mappen plus -Platform Win32 of Win64, en schrijft het resultaat naar Lib/Native/RapidOCR/<Platform>/. Bouw allebei als je allebei verscheept. Een 32-bit Delphi-applicatie kan geen 64-bit DLL laden, en de statische libraries die je voorziet moeten ook matchen op doelarchitectuur én CRT-modus
Modellen hebben hun eigen compatibiliteitsregels. De detector is een DB-tekstdetector. De recognizer accepteert CTC-modellen in NCHW-layout met een vaste invoerhoogte van 32 of 48, en gebruikt 48 als het model een dynamische hoogte declareert. Het modelformaat moet er een zijn die de statisch gelinkte ONNX Runtime begrijpt; nieuwere exports zoals PP-OCRv5 kunnen een nieuwere runtime vereisen, en een onleesbaar model faalt bij initialisatie met een diagnostic. tools/Install-RapidOCRModels.ps1 installeert PP-OCRv3- en PP-OCRv4-pakketten die geverifieerd zijn tegen vastgepinde SHA256-hashes, met een gedeelde detector en classifier onder de bestandsnamen die Default verwacht. Blijf op die pakketten tenzij je ook de runtime-build zelf in de hand hebt
Het woordenboek moet UTF-8 zonder BOM zijn, in exact de karaktervolgorde van het model, en zijn entry-aantal moet matchen met de uitvoerklassen van het model. CRLF-regeleinden zijn prima. Als een model zijn eigen karakterlijst in metadata meedraagt, vergelijkt modelinitialisatie elke entry en zijn positie met het woordenboekbestand, dus een woordenboek dat alleen de juiste lengte heeft faalt alsnog. De DLL downloadt nooit een ontbrekend model
HotPDF bundelt de native RapidOCR-adapter met de procesgebaseerde OCR-adapters, de paginarenderaar die ze voedt en de onzichtbare Unicode-tekstlaagschrijver, allemaal in één native VCL-component voor Delphi en C++Builder. Voor capture- en archiveringssoftware die op machines zonder Python doorzoekbare PDF moet produceren, laat de HotPDF Delphi PDF-component alleen de DLL en zijn modellerichten over om te deployen