"value":-.25 is wat een JSON-writer produceert wanneer hij een volkomen legaal PDF-getaltoken ongewijzigd overneemt, en een strenge RFC 8259-parser geeft op op het punt direct na het minteken. Zijn buren +1.5 en 007.5 uit dezelfde PDF-array falen op dezelfde manier. PDF-getallen in JSON omzetten betekent elk token cijfer voor cijfer opnieuw spellen, null schrijven voor NaN en Infinity, en de regionale decimale komma uit de uitvoer houden
Vier spellingen die PDF accepteert en JSON weigert
De twee grammars zijn het oneens over vier kleine details. ISO 32000-1 §7.3.3 laat een getal met een plusteken beginnen, het integerdeel weglaten (.5), op een kale punt eindigen (4.) en voorloopnullen dragen (007.5). RFC 8259 §6 staat geen van dat alles toe. Een JSON-getal heeft een optioneel minteken, een integerdeel dat ofwel 0 is ofwel met een cijfer van 1 tot 9 begint, en minstens één cijfer na elke decimale punt. Producenten hebben recht op de PDF-vormen, en generators die getallen printen met hun eigen formatteringscode, samen met bestanden die iemand met de hand in een teksteditor heeft gerepareerd, gebruiken ze
De botsing wordt scherper in een library die de brontekst respecteert. PDF Library for Delphi (PDFlibPas) houdt de exacte tekens vast die hij voor elk reëel getal parste, zodat een gekalibreerde kleurwaarde ongewijzigd wordt opgeslagen in plaats van afgerond naar de default van vier decimalen; de redenering staat in geparsde PDF-decimaalprecisie behouden. De tokenizer herstelt .5 al in 0.5 en 4. in 4.0 tijdens het lezen, en integers worden vanuit hun waarde herbouwd, dus +3 komt terug als 3. Drie spellingen bereiken de writer nog woordelijk: een getekende voorlooppunt (-.25), een expliciete plus op een reëel getal (+1.5) en voorloopnullen (007.5)
Een writer die die opgeslagen tekens rechtstreeks in JSON plakt produceert een bestand dat er in een editor prima uitziet. De moeilijkheid begint op de terugweg. SetObjectJSON geeft 0 terug, en LastErrorCode meldt PDFLIB_ERROR_OBJECT_JSON_INVALID, dat is 105
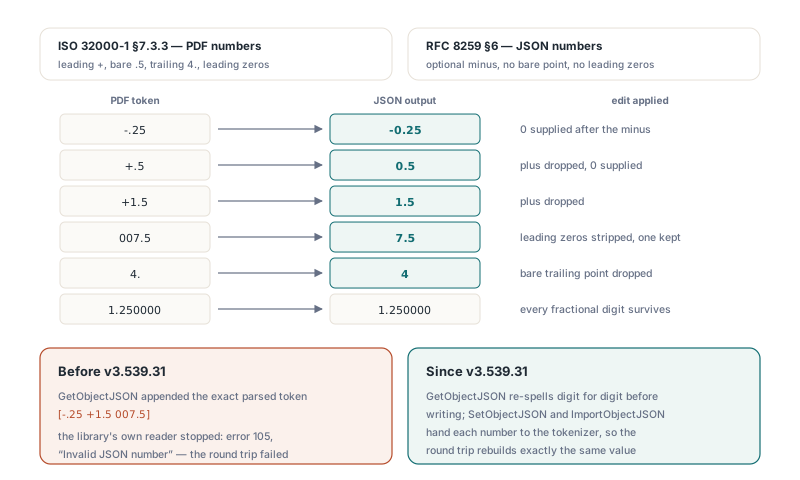
De round-trip hieronder is de snelste manier om te zien wat GetObjectJSON werkelijk uitzendt. Elk getal komt gewikkeld aan als {"type":"number","value":...}, en de drie lastige tokens komen eruit als -0.25, 1.5 en 7.5
uses
  System.SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  JSON: AnsiString;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('legacy-drawing.pdf', '') = 0 then
      raise Exception.Create('load failed');

    // Object 12 is een array geschreven als [-.25 +1.5 007.5]
    JSON := Lib.GetObjectJSON(12, 0);
    if JSON = '' then
      raise Exception.CreateFmt('export failed, error %d',
        [Lib.LastErrorCode]);
    // Elk element leest {"type":"number","value":-0.25} enzovoort

    // SetObjectJSON geeft 1 terug bij succes; geef 0 door voor Options
    if Lib.SetObjectJSON(12, JSON, 0) = 0 then
      raise Exception.CreateFmt('round trip rejected, error %d',
        [Lib.LastErrorCode]);

    Lib.SaveToFile('legacy-drawing-roundtrip.pdf');
  finally
    Lib.Free;
  end;
end;
Het token herspellen in plaats van herberekenen
GetObjectJSON bewerkt de opgeslagen tekens in plaats van de geparsde Double te formatteren. Hij leest een optioneel teken, verzamelt de cijfers aan weerskanten van één decimale punt, en doet daarna alleen de wijzigingen waar JSON op staat: de plus gaat eraan, voorloopnullen worden teruggestript tot één, een leeg integerdeel wordt 0, een kale afsluitende punt valt weg, en een minteken wordt er weer voor gezet. Een token dat een ander teken bevat, of helemaal geen cijfers, wordt vanuit zijn geparsde waarde met tien decimalen geformatteerd, en die route schrijft null wanneer de waarde niet eindig is
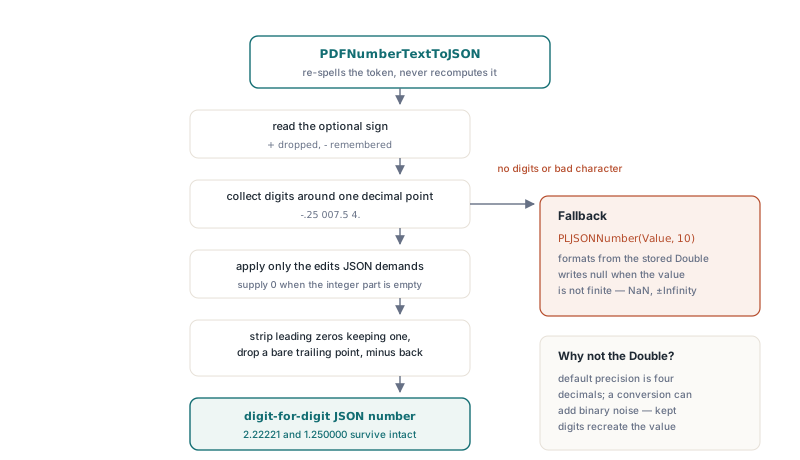
-.25wordt-0.25, en+.5wordt0.5+1.5wordt1.5007.5wordt7.5, terwijl0.75blijft zoals hij is4.wordt4als zo'n token de writer ooit bereikt2.22221en1.250000houden elk fractioneel cijfer, afsluitende nullen inbegrepen
Formatteren vanuit de Double had een one-liner geweest, en hij was op twee manieren verkeerd geweest. De default uitvoerprecisie van het document is vier decimalen, dus 2.22221 zou een cijfer verliezen. De precisie opvoeren redt hem ook niet: 0.1 heeft geen exacte binaire vorm, en een conversie met 17 significante cijfers print 0.10000000000000001. De originele cijfers vasthouden betekent dat SetObjectJSON en ImportObjectJSON, die elk JSON-getal weer aan de PDF-tokenizer geven, exact de waarde herbouwen die het bestand verkondigde
Die belofte dekt de waarde. De bytes zijn een andere kwestie. Na een herimport wordt -.25 opgeslagen en opgeslagen als -0.25; beide spellingen zijn gelijkwaardig onder §7.3.3, maar een byte-level diff vlagt de wijziging. Op een document waarvan de bytebereiken onder een handtekening vallen, zouden wij objecten helemaal niet door een export- en importcyclus halen tenzij het plan is daarna opnieuw te ondertekenen
Wat betekent null in GetDocumentJSON-uitvoer?
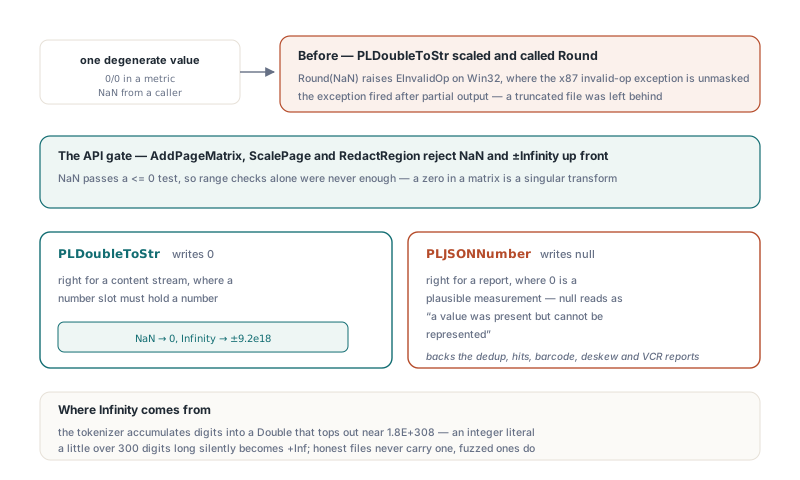
GetDocumentJSON schrijft null voor elk getal dat NaN of oneindig is, want RFC 8259 §6 heeft voor geen van beide een syntax. Infinity is makkelijker te produceren dan hij klinkt. De PDF-tokenizer stapelt cijfers op door herhaalde vermenigvuldiging in een Double, die rond 1,8 × 10308 zijn plafon raakt, dus een integer literal van iets meer dan 300 cijfers wordt tijdens het parsen +Inf. Gewone producenten schrijven zo'n literal nooit; gefuzzde en vijandige bestanden wel, wat de reden is dat een integer van 400 cijfers in hetzelfde testcorpus thuishoort als de gevallen uit een Pascal-PDF-parser verharden tegen kwaadaardige bestanden
De eindigheidscontrole moet eerst komen. GetDocumentJSON print integrale waarden onder MaxInt als integers en al het restje met de Str(D:0:6) van Pascal, wat prima is voor 1.25 en fataal voor +Inf, want Str schrijft dan de tekst +Inf en geen enkele JSON-consument parst dat. De zes-decimale formattering markeert ook waar het document-JSON voor dient. Het is een overzicht van het hele bestand. Heb je de exacte cijfers van één object nodig, vraag dan GetObjectJSON om dat object
De null is met opzet verliesgevend, en hij deelt zijn spelling met iets anders. Een PDF-null-object komt ook als null uit de document-JSON, dus een consument kan aan die ene waarde niet zien of "het bestand null zei" of "het bestand een getal zei dat te groot is voor een Double". GetObjectJSON houdt ze uit elkaar: het PDF-null-object wordt geschreven als {"type":"null"}, en een getal houdt zijn "type":"number"-wikkel. Code die document-JSON leest zou null overal moeten accepteren waar een getal kan verschijnen, het objectnummer moeten loggen, en het bestand als verdacht moeten behandelen in plaats van 0 te substitueren
Waarom kan één NaN een SVG- of JSON-export doen afbreken?
Een getalformatter die zijn invoer schaalt en Round aanroept raakt Round(NaN), en op Win32, waar Delphi de x87 invalid-operation exception niet maskeert, gooit dat EInvalidOp. De exception gaat af nadat de writer al een deel van zijn uitvoer heeft uitgezonden. Eén degenererde meting, een 0/0 in een metriek of een NaN die een aanroeper doorgeeft, laat een afgekap bestand op schijf achter
PLDoubleToStr in PDFlibExtra, de invariante formatter die de library gebruikt voor contentstreams, SVG, XML, CSV en het merendeel van zijn JSON, geeft 0 terug voor NaN. Zijn integer-tak klemmt de geschaalde waarde vast op ±9,2 × 10¹⁸, net als de fractionele tak, dus Infinity komt ook als een eindig literal uit de bus. In een content stream is dat de juiste zet. Een operand-plek moet een getal bevatten, en een viewer die +Inf midden in een pad aantreft heeft niets zinnigs om te tekenen
In een rapport is nul de verkeerde zet, en hierover zijn wij duidelijk: 0 is een volkomen geloofwaardige ontstekingshoek of pixel-fout, dus hem schrijven voor "geen antwoord" corrumpeert de data zonder dat iemand het merkt. Rapportwriters gebruiken in plaats daarvan PLJSONNumber(Value, Decimals) uit dezelfde unit, die null schrijft voor NaN of Infinity en verder invariante cijfers. GetSimilarImageDeduplicationReportJSON, GetAnnotationHitsJSON en de barcode-, deskew-, structured text- en PDF/VCR-rapporten gaan er allemaal doorheen, dus een niet-eindige deskew-hoek bereikt de consument als null
Dezelfde functie is openbaar, dus je eigen JSON kan naast die van de library dezelfde regel volgen. De schets hieronder bouwt een klein skew-record; de vorm van het record is van ons, de formatteringsaanroep is die van de library
uses
  SysUtils, PDFlibTypes, PDFlibExtra;

// Eigen rapport writer, met de getalregel van de library
function SkewReportJSON(Page: Integer; Angle, Confidence: Double): string;
var
  B: PLStringBuilder;
begin
  B := PLStringBuilder.Create(128);
  try
    // Zet elke Double eerst om naar tekst; PLJSONNumber schrijft null
    // voor NaN of Infinity en gebruikt altijd een decimale punt
    B.Append('{"page":').Append(Page)
     .Append(',"angle":').Append(string(PLJSONNumber(Angle, 4)))
     .Append(',"confidence":').Append(string(PLJSONNumber(Confidence, 4)))
     .Append('}');
    // Nooit B.Append(Angle): op Delphi volgt die overload de user locale
    Result := B.ToString;
  finally
    B.Free;
  end;
end;
Waar de user locale in JSON binnensluipt
Elke formatter die regionale instellingen raadpleegt kan een komma zetten waar JSON een punt nodig heeft. PLFloatToStr in PDFlibExtra is een dunne wikkel om FloatToStr, en dat is precies wat hij doet. Schrijf er een veld als maxAcceptedMeanError mee op een Duitse of Franse desktop en je krijgt "maxAcceptedMeanError":1,5. Een JSON-parser leest dat als de waarde 1 gevolgd door een losse token. Dat veld meldt de slechtste geaccepteerde pixel-fout uit perceptuele beelddeduplicatie, en GetSimilarImageDeduplicationReportJSON schrijft hem via PLJSONNumber(Stats.MaxAcceptedMeanError, 6), dus het scheidingsteken blijft een punt wat de machine ook is ingesteld
De tweede route is stiller. Op Delphi is PLStringBuilder een kale alias van System.SysUtils.TStringBuilder, waarvan de Append(Double)-overload door de user locale formatteert. Free Pascal-builds gebruiken in plaats daarvan een kleine Unicode builder-klasse uit PDFlibTypes, want de eigen TStringBuilder van de FPC-runtime is alleen ANSI. Compileer dezelfde bron met allebei en de Delphi-build kan het oneens zijn met de FPC-build. Een test die alleen op Free Pascal draait, of alleen op een en-US-machine, ziet de komma niet
De test hierbelow reproduceert een komma-desktop binnen het proces en voert het rapport aan een strenge parser. Kies een invoer die echt bijna-dubbele afbeeldingen bevat; zonder matches is de gemiddelde fout 0, en een waarde zonder fractioneel deel verbergt het scheidingstekenprobleem
uses
  System.SysUtils, System.JSON, PDFlibrary;

var
  Lib: TPDFlib;
  Report: WideString;
  Parsed: TJSONValue;
begin
  // Laat dit proces zich gedragen als een Duitse of Franse desktop
  FormatSettings.DecimalSeparator := ',';
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('scanned-batch.pdf', '') = 0 then
      raise Exception.Create('load failed');
    // Dry run met drempels 2, 2, 4: het document wordt niet gewijzigd
    Lib.GetSimilarImageDeduplicationReportJSON(2, 2, 4, Report);
    Parsed := TJSONObject.ParseJSONValue(Report);
    // Deze nil-controle voeg je zelf toe, geen deel van de library
    if Parsed = nil then
      raise Exception.Create('report is not valid JSON on a comma locale');
    Parsed.Free;
  finally
    Lib.Free;
  end;
end;
Drie invoer die de testsuite verdienen
Getalafhandeling in JSON is goedkoop te slopen en goedkoop te bewaken. Eén pagina met -.25, +1.5 en 007.5 dekt de grammaticakloof; controleer dat de GetObjectJSON-uitvoer parst en dat SetObjectJSON 1 teruggeeft. Eén object met een integer van 400 cijfers dekt overflow; de document-JSON moet op die positie null tonen. Eén rapport geproduceerd met DecimalSeparator op een komma dekt de locale. Haal elk door een strenge parser in plaats van de uitvoer met het oog te lezen, want 1,5 en 1.5 zijn makkelijk te missen in een lange regel JSON
Object-JSON, document-JSON en de analyserapporten delen deze getalregels over Delphi-, C++Builder- en Free Pascal-builds. De PDF Library for Delphi-productpagina somt de edities op en de rest van de object-level- en rapportage-API