PDF Library for Delphi kan afbeeldingen in een PDF samenvoegen die er hetzelfde uitzien maar niet byte-identiek zijn, via DeduplicateSimilarImages. Exacte deduplicatie voegt alleen afbeeldingen samen waarvan de dictionaries en gecodeerde payloads overeenkomen; deze functie vergelijkt hoe de afbeeldingen er daadwerkelijk uitzien, met een perceptual hash plus twee pixelfoutdrempels, en leidt elke verwijzing om naar één canoniek object
De bestanden waar dit loont, zijn de bestanden die per ongeluk zijn gegroeid. Een gescande batch waarbij elke pagina hetzelfde logo draagt, opnieuw gecodeerd door een andere scanner. Een rapport samengesteld uit bronnen die elk dezelfde grafiek insloten op een iets andere JPEG-kwaliteit. Een catalogus waarvan de thumbnails door twee tools opnieuw zijn gegenereerd. In elk geval bevat het bestand veel kopieën van één afbeelding, en exacte deduplicatie kan geen van alle aanraken
Wat "voldoende gelijk" moet betekenen
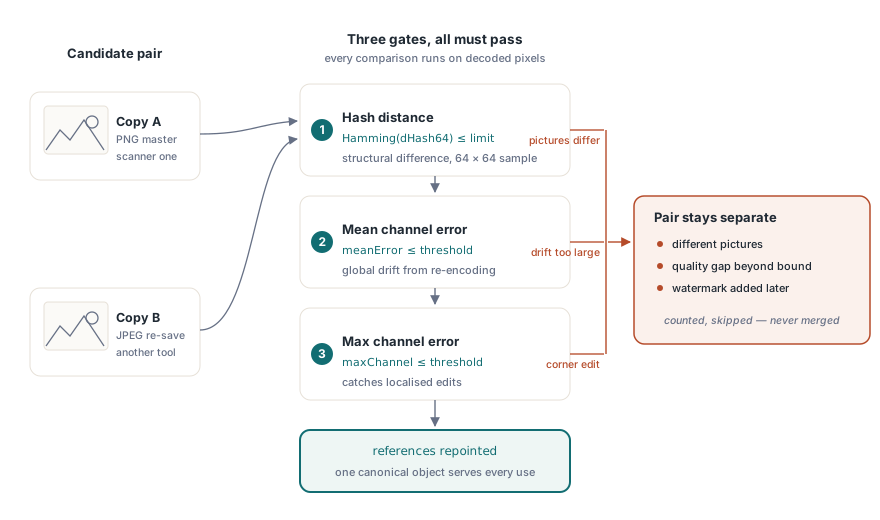
Er moeten drie drempels allemaal worden gehaald voordat twee afbeeldingen worden samengevoegd, en elk vangt een ander soort verschil. De perceptual-hashafstand begrenst structureel verschil: een 64-bit difference hash wordt berekend uit een sample van 64 bij 64 van de gedecodeerde afbeelding, en de toegestane Hamming-afstand loopt van 0 tot 7. De gemiddelde kanaalfout begrenst algehele drift, wat herbecodering oplevert. De maximale enkelkanaalsfout begrenst lokaal verschil, wat een kleine bewerking oplevert
Dat alle drie vereist zijn, is wat de samenvoeging verdedigbaar maakt. Een afbeelding die verschilt door een watermerk in één hoek heeft een lage gemiddelde fout en een hoge maximale fout, dus wijst de maximale-foutpoort haar af. Een afbeelding die opnieuw is gecomprimeerd, heeft overal een kleine fout, dus komt ze erdoor. Dat is precies het onderscheid dat een grootte-optimalisator moet maken
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Hashafstand 2, gemiddelde fout 2, enkelkanaalsfout 4.
    // Opties kunnen een dry run aanvragen zodat er niets wordt gewijzigd
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
Semantische identiteit komt vóór visuele gelijkenis
Voordat er ook maar één pixel wordt vergeleken, moeten kandidaat-afbeeldingen semantisch overeenkomen. De library bouwt een stabiele signature op basis van de volledige afbeeldingsdictionary, met uitzondering van /Length, /Filter en /DecodeParms, zodat afmetingen, kleurruimte, bitdiepte, maskers, de /Decode-array, interpolatie, optional-content-lidmaatschap en metadata allemaal moeten overeenkomen
Deze volgorde voorkomt een hele klasse van foutieve samenvoegingen. Twee afbeeldingen kunnen er identiek uitzien in een sample van 64 bij 64 en zich toch anders gedragen op de pagina: één met /Interpolate true en één zonder worden bij het schalen anders gladgestreken, en één die tot een optional-content-groep behoort, verdwijnt wanneer die laag wordt verborgen. Samenvoegen over die grenzen heen levert een document op dat kleiner is en fout
Alleen indirecte Image XObjects worden gescand. Inline afbeeldingen zijn een andere constructie met andere economie, en afbeeldingen die niet kunnen worden gedecodeerd, worden conservatief overgeslagen en geteld in plaats van op goed vertrouwen samengevoegd — geen pixelbewijs, geen samenvoeging
Hoe de zoekactie goedkoop blijft
Elke afbeelding tegen elke andere afbeelding vergelijken is kwadratisch, wat onaanvaardbaar is bij een document met duizenden afbeeldingen. De hash wordt daarom gesplitst in acht 8-bit banden, elk met een geordende index
Het ladenkastprincipe doet de rest: als twee hashes op ten hoogste 7 bits verschillen, moeten ze op minstens één van de acht banden exact overeenkomen. Kandidaten band voor band opzoeken vindt daarom elke toegestane match zonder een uitputtende paarsgewijze scan, en de gepubliceerde limiet van 7 bestaat precies omdat de garantie alleen tot die afstand geldt
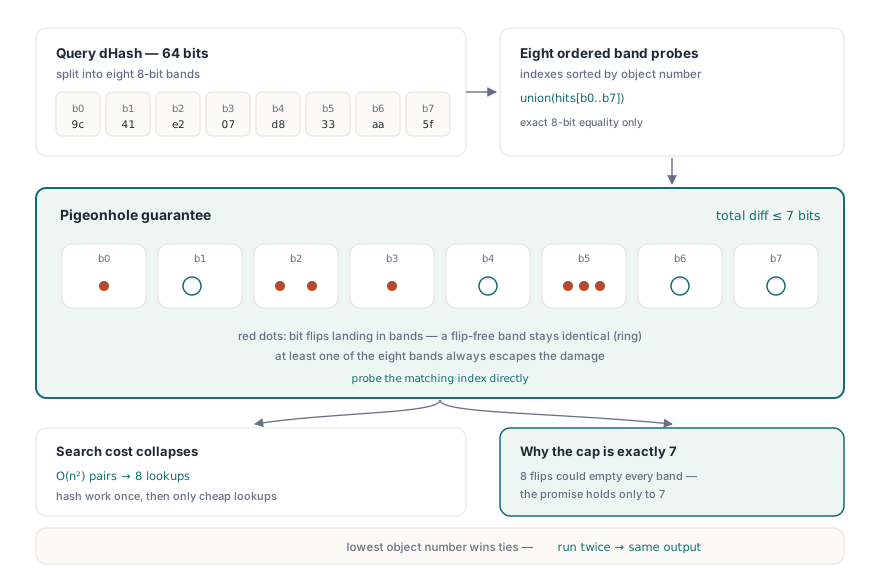
Kandidaten en bandtreffers worden deterministisch geordend op objectnummer en generatie, en het laagste objectnummer wordt canoniek. Dat maakt de output reproduceerbaar: de optimalisator twee keer op dezelfde invoer draaien levert dezelfde canonieke keuzes op, wat van belang is wanneer het resultaat wordt vergeleken of ondertekend
Dry runs en eerlijke rapportage
Omdat dit een lossy optimalisatie is in die zin dat de samengevoegde afbeeldingen niet identiek waren, is de verstandige workflow eerst kijken en dan pas springen. De dry-run-optie rapporteert wat er zou worden samengevoegd en hoeveel payload zou worden teruggewonnen zonder de objectgraaf te wijzigen, zodat een batchtaak het effect kan loggen en een mens de drempels één keer kan goedkeuren in plaats van per bestand
Twee eerlijkheidsopmerkingen in de rapportage verdienen vermelding. Het terugwinbare cijfer schat alleen de gecodeerde payload van dubbele streams; het telt geen dictionary-, indirect-object- en cross-reference-overhead mee, dus is de werkelijke verkleining van het bestand iets groter dan gerapporteerd in plaats van kleiner. En het rapport toont de maximaal geaccepteerde fout en de vergelijkingsbelasting, zodat u kunt zien hoe dicht de samenvoegingen bij uw drempels kwamen
Het vaste samplingraster van 64 bij 64 is een bewuste benadering, en het heeft een gevolg dat het waard is duidelijk te benoemen: een verschil dat kleiner is dan één samplecel kan onopgemerkt blijven, zelfs bij een drempel van nul. Eén enkel gewijzigd woord op een gescande pagina overleeft die sampling mogelijk niet. Wanneer bewijs op byteniveau vereist is, gebruik dan in plaats daarvan het exacte-deduplicatietraject — dat voegt alleen werkelijk identieke resources samen en maakt helemaal geen visueel oordeel
Waar het thuishoort in een grootteverkleiningspijplijn
Orden de passes op risico. Voer eerst exacte resourcededuplicatie uit, want die is lossless en gratis. Dan lettertypesubsetting, wat ook lossless is en meestal de grootste enkele winst oplevert bij tekstzware documenten, zoals behandeld in PDF-bestandsgrootte-optimalisatie en lettertypesubsetting. Dan hercompressie of downsampling van afbeeldingen als het doelmedium dat toelaat. Perceptuele deduplicatie hoort daarna, want het is de enige stap waarvan het resultaat afhangt van een oordeel
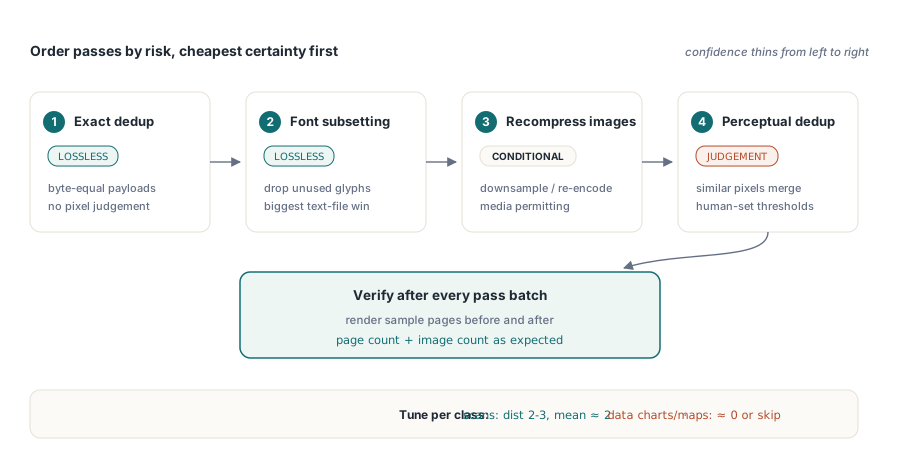
Kies drempels per documentklasse in plaats van globaal. Voor gescande batches waarbij elke pagina hetzelfde briefhoofd draagt, voegt een hashafstand van 2 tot 3 met een gemiddelde fout rond 2 het briefhoofd betrouwbaar samen. Voor documenten waarbij afbeeldingen data dragen — grafieken, kaarten, medische beeldvorming — gebruikt u nul of bijna-nul drempels, of slaat u de pass helemaal over, want twee grafieken die op één geplot punt verschillen, zijn twee verschillende grafieken, hoe gelijkend ze er ook uitzien op 64 bij 64
Verifieer na het optimaliseren. Render een steekproef van pagina's van vóór en na en vergelijk ze, en controleer of het aantal pagina's en het aantal afbeeldingen is veranderd zoals u verwachtte. Het inspectietraject voor wat een document daadwerkelijk bevat, wordt beschreven in PDF-bestandsgrootte auditen per categorie, wat ook de snelste manier is om erachter te komen of afbeeldingen om te beginnen uw probleem zijn
Perceptuele deduplicatie, exacte resourcededuplicatie en de grootte-audit draaien op dezelfde objectgraaf voor Delphi, C++Builder en Free Pascal; de volledige functielijst staat op de PDF Library for Delphi-pagina