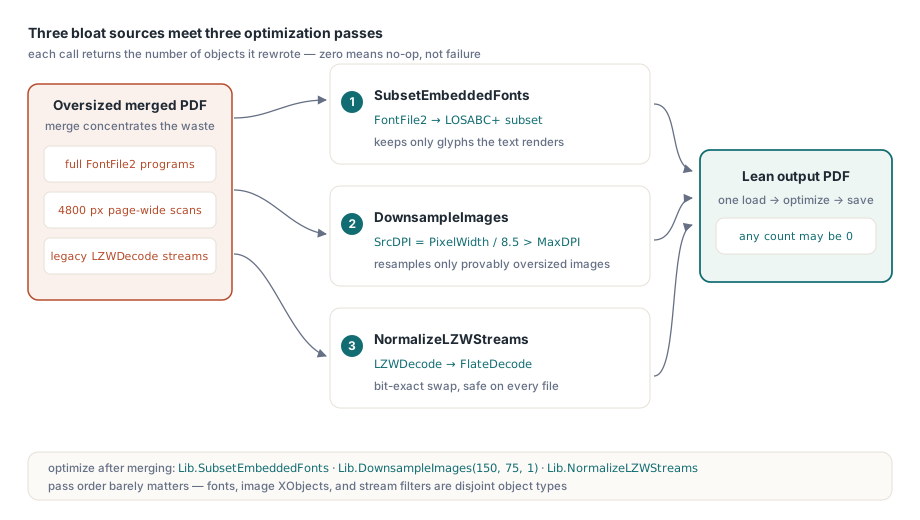
Om de PDF-bestandsgrootte in Delphi te verkleinen biedt losLab PDF Library drie API's die de drie grootste bronnen van opgeblazen bestanden aanpakken: SubsetEmbeddedFonts herschrijft elk ingesloten TrueType-lettertypeprogramma terug tot de glyphs die het document daadwerkelijk rendert, DownsampleImages hersamplet rasterafbeeldingen die een doel-DPI overschrijden, en NormalizeLZWStreams vervangt de verouderde LZWDecode-compressie door FlateDecode. Elke functie retourneert het aantal gewijzigde objecten, dus een nul vertelt u dat de passage niets te doen had in plaats van stilzwijgend te zijn mislukt
Waarom is mijn samengevoegde PDF groter dan de bronbestanden?
Een samengevoegde of programmatisch gegenereerde PDF is meestal om een van drie redenen te groot: volledig ingesloten lettertypen, afbeeldingen die ver boven hun weergaveresolutie zijn gesampled, en streams die nog met het verouderde LZW-filter zijn gecomprimeerd. ISO 32000-1 §9.9 staat een producent toe het complete lettertypeprogramma in te sluiten, en de meeste producenten doen precies dat omdat het de veilige standaardkeuze is. Een complete Arial-FontFile2 loopt op tot honderden kilobytes; sluit die in een dozijn bronbestanden in, voeg ze samen, en u sleept een dozijn kopieën mee van glyph-contouren voor tekens die niemand heeft getypt. Het samenvoegen zelf veroorzaakt de verspilling niet, het concentreert die alleen in één bestand waar het totaal eindelijk zichtbaar wordt
Afbeeldingen zijn de tweede boosdoener. Een scan van 4800 pixels breed die in een kader van een kwart pagina wordt geplaatst, bevat ruwweg 40 keer meer pixeldata dan een afdrukpijplijn van 300 DPI kan gebruiken. De derde is stiller: streams gefilterd met LZWDecode. ISO 32000-1 §7.4.4 specificeert zowel LZWDecode als FlateDecode, en merkt op dat Flate doorgaans minstens even goed comprimeert; in de praktijk is Flate-uitvoer consistent kleiner op dezelfde data, en LZW overleeft vooral in bestanden die ergens in hun geschiedenis door gereedschap uit de jaren negentig zijn gegaan. De rest van dit artikel loopt de drie passages van losLab PDF Library langs die elk probleem oplossen, en combineert ze daarna tot één pijplijn
Font-subsetting met SubsetEmbeddedFonts
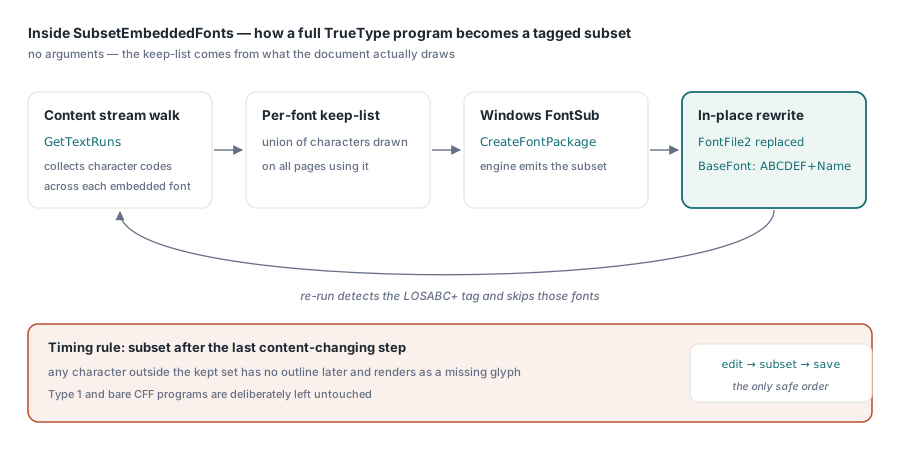
SubsetEmbeddedFonts krimpt elk ingesloten TrueType-lettertype in een geladen document tot de tekens die het document daadwerkelijk gebruikt, en heeft geen argumenten nodig omdat het de bewaarlijst uit de contentstreams zelf afleidt. Intern doorloopt de passage de contentstream van elke pagina met GetTextRuns, verzamelt de tekencodes waarnaar onder elke lettertyperesource wordt verwezen, bouwt een bewaarlijst op, en geeft het originele lettertypeprogramma door aan de Windows FontSub-engine (CreateFontPackage) om een subset te produceren. Het herschreven programma vervangt de FontFile2-stream ter plaatse, en de BaseFont-naam krijgt een LOSABC+-tag, de conventie van zes hoofdletters plus plusteken die ISO 32000-1 §9.6.4 voor subsetlettertypen definieert. Dat voorvoegsel maakt de aanroep ook idempotent: draai de passage tweemaal en reeds gesubsette lettertypen worden herkend en overgeslagen, dus het inbouwen in een batchtaak die bestanden opnieuw kan bezoeken is veilig
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = aantal herschreven FontFile2-programma's;
      // 0 betekent niets ingesloten, of alles al gesubset
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
Twee implementatiedetails zijn het kennen waard omdat ze de grenzen van de API verklaren. Ten eerste richt de passage zich op FontFile2, dus zij dekt ingesloten TrueType-programma's; lettertypen die als Type 1 of kaal CFF zijn ingesloten blijven ongemoeid in plaats van dat er risico wordt genomen. Ten tweede leunt zij op FontSub, wat SubsetEmbeddedFonts Windows-only maakt. Een subtieler punt uit de implementatie: of een lettertype in aanmerking komt wordt beslist door de verwijzingsketen FontDescriptor → FontFile2 daadwerkelijk te resolven, niet door een heuristiek met een ingesloten-vlag te vertrouwen, omdat lettertypen in een geladen document nooit door de boekhouding aan de aanmaakzijde zijn gegaan die zulke vlaggen zet. Bestaat de geresolvede stream, dan is het lettertype een kandidaat; zo niet, dan wordt het zonder fout overgeslagen
De eerlijke afweging: een subsetlettertype bevat alleen de glyphs die op het moment van subsetten aanwezig waren. Als een gereedschap verderop, of uw eigen code, later tekst in datzelfde lettertype toevoegt, heeft elk teken buiten de subset geen contour en zal het als een ontbrekende glyph worden gerenderd. Subset als de laatste stap die inhoud wijzigt, nooit vóór een bewerkingsfase. Dezelfde waarschuwing geldt als u van plan bent het lettertype er later weer uit te halen voor hergebruik; het artikel over tekst, afbeeldingen en lettertypen extraheren met PDF Library for Delphi behandelt wat een geëxtraheerd subsetprogramma u wel en niet kan geven
Hoe bepaalt DownsampleImages welke afbeeldingen krimpen?
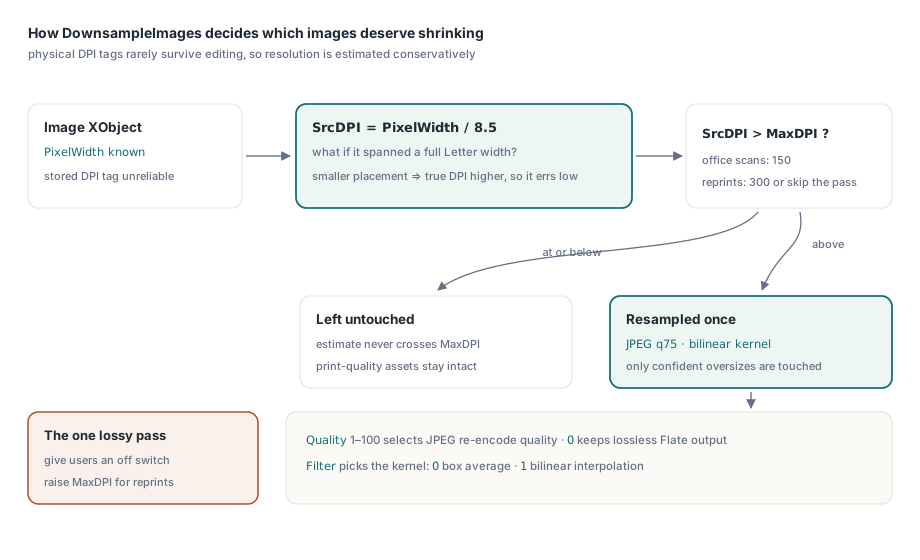
DownsampleImages(MaxDPI, Quality, Filter) hersamplet alleen de afbeeldingen die zij met vertrouwen oversampled kan noemen, met een bewust conservatieve DPI-schatting. Een PDF-afbeelding-XObject slaat pixelafmetingen op maar geen betrouwbare fysieke resolutie, en een DPI-tag uit de bronafbeelding overleeft zelden een cyclus van laden, bewerken en opslaan. Daarom schat de passage SrcDPI = PixelWidth / 8.5, wat feitelijk de vraag stelt: als deze afbeelding de volledige breedte van een Letter-pagina zou beslaan, wat zou dan haar resolutie zijn? Alleen afbeeldingen waarvan de schatting MaxDPI overschrijdt worden aangeraakt. De vertekening is opzettelijk: een afbeelding die klein op de pagina is geplaatst heeft een werkelijke DPI die hoger ligt dan de schatting, dus de passage grijpt liever te weinig in dan dat zij een asset van drukkwaliteit degradeert die zij niet kan meten
Quality van 1 tot 100 selecteert de kwaliteit van de JPEG-hercodering, terwijl 0 de uitvoer als verliesloze Flate in PNG-stijl behoudt; Filter kiest de hersamplingkernel, 0 voor een boxgemiddelde en 1 voor bilineair. Voor gescand kantoorpapierwerk is DownsampleImages(150, 75, 1) een verstandig startpunt; voor alles wat mogelijk opnieuw wordt afgedrukt, verhoogt u MaxDPI naar 300 of slaat u de passage helemaal over. Downsampling is de enige lossy stap van de drie, dus zij hoort achter een instelling te zitten die uw gebruikers kunnen uitzetten
Verouderde LZW-streams omzetten met NormalizeLZWStreams
NormalizeLZWStreams is de gratis winst: zij decomprimeert elke LZWDecode-stream verliesloos en hercomprimeert die ter plaatse met FlateDecode, en retourneert het aantal omgezette streams. Zij verwerkt zowel één enkele /Filter /LZWDecode-vermelding als LZW dat in een filterketenarray voorkomt, waarbij alleen de LZW-schakel wordt vervangen en de rest van de keten behouden blijft. Predictorparameters (Predictor, Columns, Colors, BitsPerComponent) worden uit de DecodeParms van de stream gelezen en doorgegeven aan de decompressor, zodat predictor-gecodeerde afbeeldingsdata correct het rondje maakt. Omdat beide filters bit-exacte codecs zijn, zijn de gedecodeerde bytes voor en na identiek; alleen de containercompressie verandert, en daarom is het veilig deze passage onvoorwaardelijk op elk bestand te draaien
Op een document zonder LZW-streams retourneert de aanroep eenvoudigweg 0 en raakt niets aan, wat de regressiesuite van de bibliotheek expliciet uitoefent: een vers aangemaakt bestand met alleen Flate moet nul conversies melden. Die garantie van niets-doen telt wanneer de passage in een pijplijn zit die duizenden heterogene bestanden verwerkt, sommige uit 2024 en sommige uit 1998
De complete pijplijn voor grootteoptimalisatie in Delphi
De drie passages combineren tot één functie van laden, optimaliseren en opslaan, en de volgorde doet er minder toe dan u zou verwachten omdat zij op disjuncte objecttypen werken: lettertypen, afbeelding-XObjects en streamfilters. Subsetting als eerste draaien blijft niettemin de nette keuze, aangezien dat de passage is met een beperking op de bewerkingsvolgorde
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> subset
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, bilineair
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Log Fonts/Images/Streams: drie nullen betekenen dat het bestand al slank was
  finally
    Lib.Free;
  end;
end;
Verifieer de pijplijn zoals de bibliotheek zichzelf verifieert: met een rondgang. De regressietests van v3.130 maken een document aan, slaan het op, laden het opnieuw, draaien de optimalisatie, slaan opnieuw op, en stellen dan drie dingen vast: de uitvoer is kleiner, de geretourneerde aantallen komen overeen met de verwachtingen, en een herlading van het geoptimaliseerde bestand parseert en rendert nog steeds. Die lus van aanmaken, optimaliseren en herladen reproduceren tegen een steekproef van uw eigen productiebestanden, en de geëxtraheerde tekst voor en na vergelijken, is een investering van een uur die integratiefouten opvangt lang voordat een klant een kapotte factuur opent
// Rondgangcontrole: het geoptimaliseerde bestand moet nog schoon laden
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
Waar past de pijplijn in een samenvoegworkflow? Na het samenvoegen, niet tijdens. Eerst samenvoegen en het enkele resultaat optimaliseren betekent dat elk ingesloten lettertype één keer wordt gesubset tegen de vereniging van alle gebruikte tekens, in plaats van per bronbestand. Als de doorvoer van het samenvoegen de bottleneck is, biedt PDF Library for Delphi een snel pad op byteniveau dat volledige objectparsing vermijdt, beschreven in het artikel over snel PDF's samenvoegen met byteverwijzingsverschuiving; en voor invoer die te groot is om volledig in het geheugen te houden behandelt samenvoegen en splitsen met directe toegang voor grote PDF's de streamingroute. Beide combineren natuurlijk met een afsluitende optimalisatiepassage op de samengevoegde uitvoer
Wat de drie passages niet zullen doen
Het optimalisatietrio van losLab PDF Library sluit bewust alles uit wat de betekenis van het document verandert. SubsetEmbeddedFonts voegt dubbele lettertypen uit samengevoegde bronnen niet samen tot één programma, maar krimpt elk onafhankelijk; deduplicatie is een andere, riskantere transformatie. DownsampleImages zal een afbeelding overslaan waarvan de conservatieve DPI-schatting onder de drempel blijft, zelfs wanneer een mens kan zien dat zij te groot is voor haar kader. En geen van de passages raakt de documentstructuur aan, dus een bestand dat is opgeblazen door duizenden verweesde objecten heeft een opslag in herschrijfstijl nodig in plaats van deze passages op streamniveau. Binnen die grenzen verwijdert de combinatie van font-subsetting, image-downsampling en normalisatie van LZW naar Flate de drie klassieke bronnen van opgeblazen PDF's met elk één voorspelbare API-aanroep. De drie functies worden geleverd als onderdeel van losLab PDF Library voor Delphi, C# en VB.NET, naast de eerder besproken API's voor samenvoegen, extractie en rendering