PDF's aan elkaar plakken klinkt alsof het goedkoop hoort te zijn. De pagina-inhoud is al opgemaakt, de lettertypen zijn al ingesloten, de afbeeldingen zijn al gecomprimeerd. In principe is een merge niet meer dan boekhouding: hernummer de objecten zodat de nummeringsruimtes van twee bestanden niet langer botsen, naai de page trees aan elkaar, repareer de cross-reference table en schrijf weg. In de praktijk gooit de meeste merge-code die goedkoopte weg. Voor elk object in elk inputbestand draait ze een volledige parse naar een getokeniseerde objectboom, muteert ze een paar indirecte referenties en serialiseert ze die boom daarna terug naar bytes. De parse en de reserialize zijn de dure helften, en voor de overgrote meerderheid van de objecten leveren ze een bytereeks op die vrijwel identiek is aan wat erin ging
PDF Library for Delphi is een native Object Pascal PDF-engine voor Delphi en C++Builder, en zijn snelle merge-pad bestaat om die round trip over te slaan waar dat aantoonbaar veilig is. Het idee is beperkt maar het betaalt zich terug over hele documentsets: voor een ongewijzigd object dat geen stream is, neem je de originele bronbytes letterlijk over en doe je één byte-level herschrijving van de indirecte referenties die ze bevatten, waarbij elke N G R in (N+Offset) G R verandert. Geen tokenizer, geen objectboom, geen serializer. Dit artikel loopt langs waar die shortcut legaal is, de parser-state-machine die de byte-herschrijving uitvoert zonder iets te corrumperen, waarom bookmarksamenvoeging een compleet ander mechanisme nodig heeft, en hoe het gewone merge-pad dezelfde enkele lineaire passage deelt
Waarom object-hernummering de echte kostenpost van een merge is
Elke PDF draagt zijn eigen objectnummeringsruimte mee. Bestand A heeft object 1, object 2, enzovoort; bestand B heeft zijn eigen object 1, object 2, enzovoort. Je kunt de objecten van B niet ongewijzigd in het bestand van A gooien, want de nummers zouden botsen en elke indirecte referentie binnen B zou dan naar het verkeerde object wijzen. De oplossing is een offset: eindigt A op objectaantal Offset, dan wordt object N van B in de uitvoer object N+Offset, en moet elke referentie N G R die ergens in de objecten van B voorkomt worden verschoven naar (N+Offset) G R om te blijven kloppen
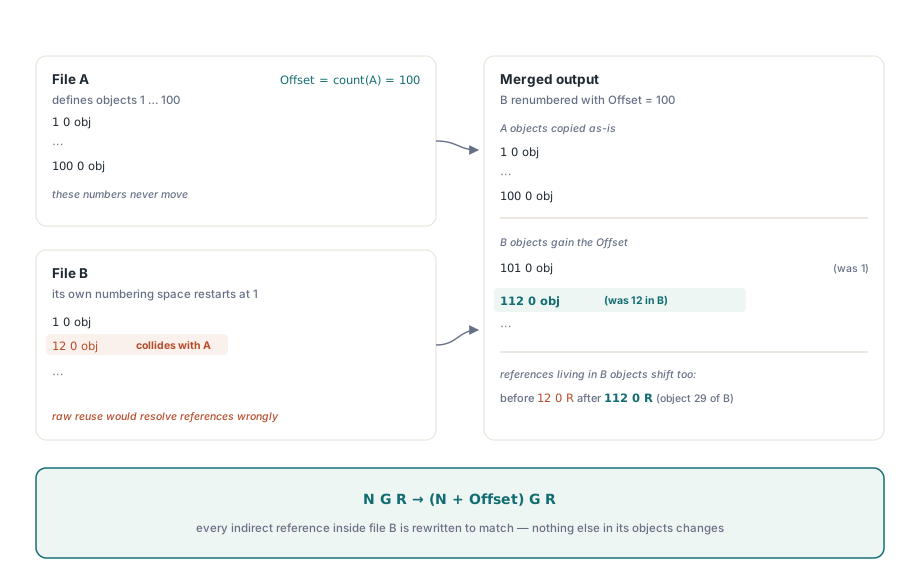
Die verschuiving is het volledige semantische werk van het samenvoegen van de body. De fixups aan de page tree en de AcroForm-merge zijn kleine, begrensde bewerkingen op een handvol objecten. Het echte werk is het herschrijven van referenties over duizenden objecten heen, en de naïeve manier om dat te doen is elk object parsen zodat je de referenties structureel kunt vinden. MergeFileListFast van PDF Library for Delphi kiest de omgekeerde route: de referenties zijn ook in de ruwe bytes te vinden, mits je oplet bij de contexten waarin een reeks cijfer-spatie-cijfer-spatie-R juist geen referentie is. Sla de parse over, verschuif ter plekke, en de kosten per object storten in tot één lineaire scan over bytes die je toch al ging kopiëren
Wanneer het hergebruiken van bronbytes aantoonbaar veilig is
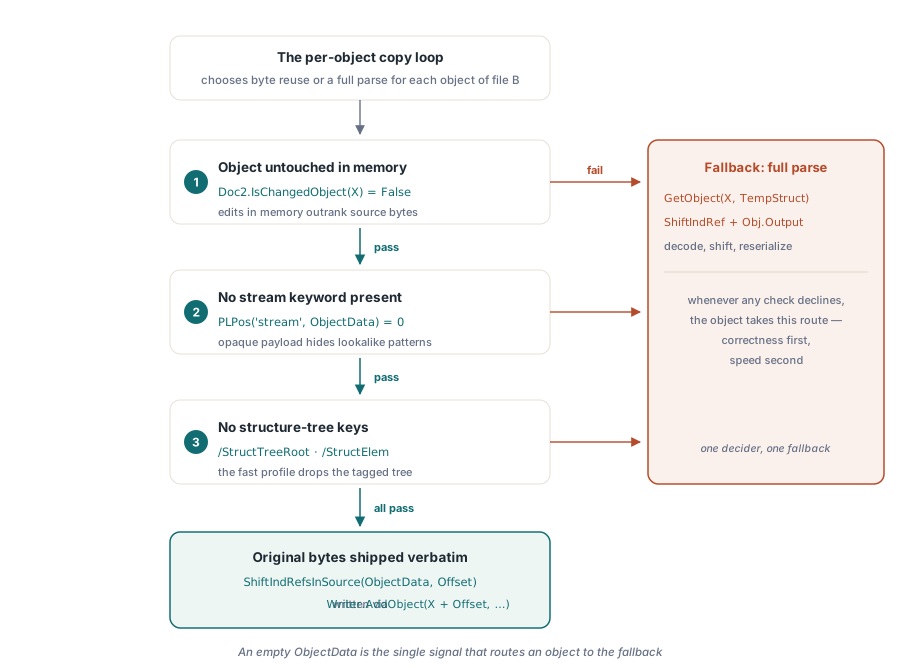
Het byte-pad wordt alleen genomen wanneer voor het object dat uit een volgend document wordt gekopieerd aan drie voorwaarden tegelijk is voldaan. Zodra er één sneuvelt, gaat het object alsnog door de volledige decode-en-reserializeer-route, want correctheid wint altijd van snelheid:
Doc2.IsChangedObject(X)is False. Heeft de merge-engine het object al in geheugen gemuteerd (bijvoorbeeld een page-object waarvan de/Parentis omgehangen), dan is de boom in geheugen de bron van waarheid en zijn de originele bytes achterhaald. Alleen onaangeraakte objecten komen in aanmerking- De bronbytes bevatten geen
stream-sleutelwoord. De body van een streamobject is opaak binair materiaal, ingelijst doorstream/endstream, en een naïeve referentiescan over gecomprimeerde of versleutelde streamdata zou vrolijk bytepatronen "vinden" die op referenties lijken en ze vervolgens slopen. Streamobjecten houden het originele stream-bewuste pad - De bronbytes bevatten noch
/StructTreeRootnoch/StructElem. In het fast-profiel wordt de tagged-PDF structure tree weggegooid in plaats van samengevoegd, dus die objecten moeten via het decode-pad, waar de engine ze bewust op nil kan zetten
De beslissing zit in de kopieerlus per object. Slagen alle drie de controles, dan gaan de bytes van het object rechtstreeks naar ShiftIndRefsInSource en daarna naar de writer; anders worden de bytes weggegooid en wordt het object opnieuw opgebouwd met GetObject, verschoven met ShiftIndRef en geserialiseerd. De opbouw van die vertakking is het bekijken waard, want juist de volgorde van de controles houdt hem veilig:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // terugvallen op decode
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // volledig parse-pad
  // ... struct-tree objecten op nil zetten, ShiftIndRef, Obj.Output ...
end;
Een lege ObjectData is het signaal dat het byte-pad het object heeft afgewezen. Die ene sentinel voorkomt dat de snelle en de langzame route uit elkaar gaan lopen: er is precies één plek die beslist, en precies één fallback
Het reference-shifting state machine en de randgevallen
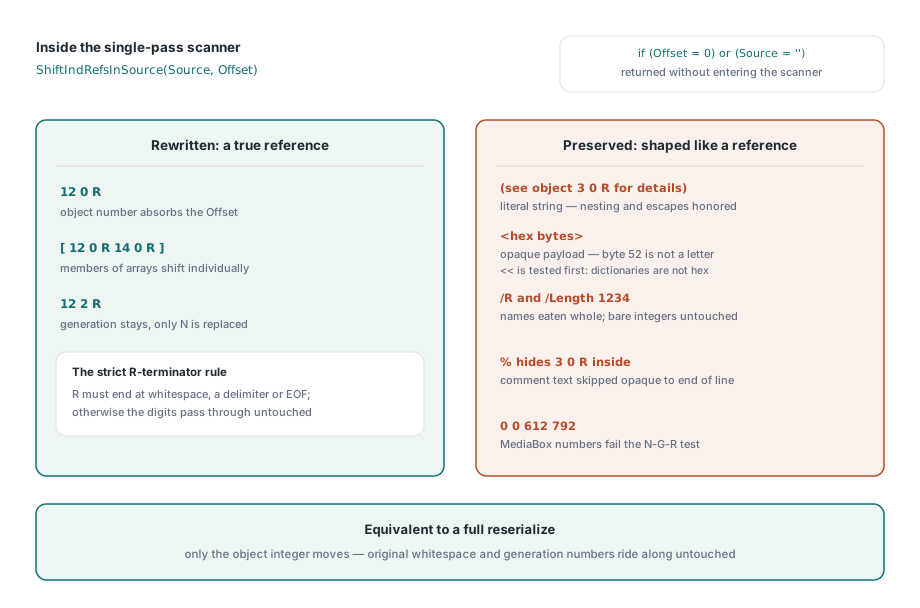
Een byte-herschrijving van indirecte referenties is bedrieglijk eenvoudig om fout te doen, omdat R en reeksen cijfers overal in een PDF-object voorkomen in contexten die geen referenties zijn. ShiftIndRefsInSource is een kleine handgeschreven scanner die de bytes één keer doorloopt en alleen een getal herschrijft wanneer het, met PDF-whitespace tussen de tokens, gevolgd wordt door nog een getal en daarna een R-delimiter. De goedkope exits komen eerst: als de offset nul is of de bron leeg, worden de bytes ongemoeid teruggegeven zonder dat de scanner überhaupt start
De correctheid van de scanner steunt op het herkennen van de contexten waarin een referentie-achtig patroon juist met rust moet worden gelaten. Dit zijn de grenzen die het makkelijkst te missen zijn, en elk ervan wordt expliciet afgehandeld:
- Letterlijke strings tussen
(en)worden letterlijk gekopieerd, met nesting depth en backslash-escapes, zodat een ge-escapete haak het diepteteller niet scheef trekt. Een string als(see object 3 0 R for details)bevat een textbook referentiepatroon dat in werkelijkheid gewoon proza is, en moet byte-for-byte intact blijven - Hexadecimale strings tussen
<en>gaan zonder interpretatie door. De bytes52in een hex string zijn de ASCII-code voorR, en een scanner die hex payload als tekst behandelt, kan een spookreferentie verzinnen. De opening<<van een dictionary wordt eerst gedetecteerd zodat een dictionary niet voor een hex string wordt gehouden - Name objects die met
/beginnen, worden in hun geheel geconsumeerd, van de slash tot de volgende whitespace of delimiter. Zonder dit zou een naam als/R, een veelgebruikte resource key, als deRvan een referentie kunnen worden gelezen - Comments die met
%beginnen, lopen tot het einde van de regel en worden als opaque tekst overgeslagen - De nummer-then-R-test is streng. Een referentie wordt alleen herkend als
NwhitespaceGwhitespaceR, met deRafgesloten door whitespace, een delimiter of het einde van input. Als het generatiegetal ontbreekt, of eenRgevolgd wordt door een letter, worden de cijfers ongewijzigd uitgegeven. Dit beschermt het getal in/Length 1234en de vier cijfers van eenMediaBoxtegen stil incrementeren
De kern van die strikte test leest bijna precies zoals de speczin hem beschrijft:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // verschoven objectnummer
  AppendBytes(E1, P - E1);                 // original whitespace + generation
  AppendBytes(P, 1);                       // the 'R'
end;
Alleen het objectnummer wordt herschreven; het generatiegetal en de exacte originele witruimte tussen tokens worden gekopieerd, dus de uitvoer is byte-identiek aan de invoer op dat ene integer na dat moest wijzigen. Die precisie is het hele punt — het is wat het hergebruiken van bronbytes gelijkwaardig maakt aan een volledige herserialisatie, niet er slechts dichtbij. Schrijf je zelf zo een scanner, test hem dan tegen kale referenties, referenties in arrays, niet-referentiegetallen, literal strings, hex-strings en generatiegetallen ongelijk nul met een toegepaste offset
Waarom bookmarks AppendOutline niet konden hergebruiken
De bookmarks van meerdere documenten in één outline-boom samenvoegen lijkt een klus voor de bestaande AppendOutline-helper, die al weet hoe de top-level bookmarks van het ene document op een ander worden geënt. Het is hier het verkeerde gereedschap, en de reden is een subtiële laagingsmismatch. AppendOutline vindt de huidige laatste top-level bookmark door de reader over de originele bestandsbytes te laten lopen. Maar het snelle merge-pad zet zijn bewerkingen via ChangeObject klaar in een new-objects-buffer; de reader ziet die bewerkingen nooit. Koppel je drie of meer documenten aan elkaar, dan zou elke append de originele laatste bookmark van het eerste document opnieuw naar het nieuwste document laten wijzen, waardoor de bookmarks van alle tussenliggende documenten uit de keten vallen — alleen de cumulatieve /Count blijft kloppen, wat het probleem gemakkelijk onopgemerkt laat tot iemand het bookmarkpaneel opent
Het fast pad lost dat op met een twee-fasen, metadata-gedreven injectie die de reader nooit opnieuw doorloopt. Een eerste pass over alle inputs verzamelt per document de outline root object- en generatiegetallen, de eerste en laatste top-level bookmarknummers en de /Count van de root. Op basis van die samenvatting berekent de code de globale objectnummers van elke link die hij moet smeden, elk document's top-level /Parent naar de gedeelde root, de /Prev van de eerste bookmark naar de laatste van het vorige document, de /Next van de laatste bookmark naar de eerste van het volgende document, met pure objectnummeraritmetiek. Er zit een write-ordering constraint achter: de objecten van het eerste document worden geschreven voordat er ook maar een volgend document geopend is, dus alle outline edits van het eerste document, root /Count en /Last, en de /Next van de oude laatste bookmark, moeten als rekenwerk uitgedrukt kunnen worden dat geen later document nodig heeft. De edits van elk volgend document worden in place toegepast nadat het is geopend maar voordat het wordt geschreven, zodat ze via hetzelfde change-object-pad meegaan
De offset-alignment invariant die alles samenbindt
Zowel de reference shift als de bookmarkinjectie hangen af van één rekenkundige invariant, en dat is de fragielste aanname in het hele ontwerp. Een referentie die in een volgend document wordt geïnjecteerd, wordt geschreven als het globale objectnummer van het doel minus de Offset van dat document, zodat wanneer het object later door ShiftIndRef(Offset) wordt verschoven de waarde op het bedoelde globale nummer belandt. Het eerste document krijgt Offset = 0 en gebruikt globale nummers direct. Voor die aftrekking correct is, moet de lopende offsetreeks die tijdens injectie wordt gebruikt overeenkomen met de offsetreeks die uiteindelijk bij het schrijven van objecten wordt gebruikt
Dat doet hij, dankzij een eigenschap van hoe de page- en form-merges werken: AddPages, AddFields en AddFieldFonts wijzigen alleen de bestaande objecten van het eerste document, ze voegen er nooit nieuwe toe. Daardoor blijft het objectenaantal van het eerste document onveranderd tijdens de page-merge-fase, en blijft de offset van elk volgend document, de som van alle voorafgaande objecten, stabiel van injectie tot write-out. Breek dat, voeg een fase toe die halverwege een nieuw object creëert, en elke page- en bookmarkreferentie stroomafwaarts zou afwijken met het aantal objecten dat je hebt toegevoegd. De invariant is stil, maar hij draagt de hele constructie
Drie entry points boven één engine
Het snelle pad is geen afsplitsing van de mergecode. De byte-level engine is één interne routine, MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode), en de openbare API's zijn dunne wrappers die twee vlaggen kiezen:
MergeFileListFastroept de engine aan met structure-tree preservation uit, het lichtste pad, waarbij de tagged-PDF-structuurboom wordt weggelaten zodat het byte-pad op de meeste objecten kan worden toegepastMergeFileListroept hem aan met preservation aan, zodat de structure tree blijft bestaan en het resultaat een bruikbare tagged PDF blijft. Dit gewone pad erft ook de multi-document bookmark- en form-mergingMergeFileListStrictzet strict mode aan: de eerste metadata-pass stopt bij de eerste input die geen schone merge rapporteert, zodat alleen de documenten tot vóór het slechte bestand worden meegenomen, in plaats van het slechte bestand over te slaan en door te gaan
Omdat alle drie één engine delen, loopt ook de gewone merge als één lineaire passage die elke invoer één keer opent, in plaats van een paarsgewijze O(N²)-lus die bestand één en twee samenvoegt, dat resultaat met drie samenvoegt, enzovoort, waarbij de groeiende accumulator elke stap opnieuw wordt geparsed. De twee-bestanden- en twee-streams-ingangen, MergeFiles en MergeStreams, blijven beschikbaar voor aanroepers die echt een paarsgewijze merge willen
Een kanttekening bij het gedrag van de structuurboom, omdat het telt als je uitvoer verifieert door bytes te inspecteren. Het snelle pad laat de boom vallen door de catalogusverwijzing van het eerste document naar /StructTreeRoot te verwijderen; het structuurboom-object zelf wordt nog steeds weggeschreven, zonder verwijzing. De bytes van de snelle uitvoer bevatten dus nog steeds de tekenreeks /StructTreeRoot, en naar die string zoeken onderscheidt snelle van gewone uitvoer niet — het echte verschil is of de catalogus de structuurboom nog bereikt, en dat bepaalt of het bestand nog een navigeerbare getagde PDF is
Wanneer je welk pad pakt
Het byte-pad is een doorvoeroptimalisatie voor het samenvoegen van veel documenten waarin je de getagde-PDF-structuurboom niet nodig hebt — rapportbundels, statementruns, batchconcatenatie. Over herhaalde merges van middelgrote tot grote invoersets gemeten, haalt het hergebruiken van bytes ruwweg vier tot dertien procent van de wall-clock-tijd af, afhankelijk van de objectmix, en kleine of misvormde invoeren gedragen zich exact als op het volledige pad, want elk object waarvan de scanner niet kan bewijzen dat het veilig is, valt terug op de volledige parse. Heb je de structuurboom nodig voor toegankelijkheid, gebruik dan het gewone tagged-PDF-mergepad, die hem bewaart; en werk je met zeer grote afzonderlijke bestanden in plaats van veel invoeren, dan passen de byte-kopieertechnieken uit het companionstuk over grote PDF merge en split met directe bestandstoegang dezelfde filosofie van bytes kopiëren en de volledige objectboom vermijden toe op bestandsschaal
De merge-routines en hun fast en strict varianten maken deel uit van de PDF Library for Delphi Delphi PDF Library, waarvan de documentatie de volledige referentie bevat voor de file-list API en de mergeopties die hier zijn beschreven