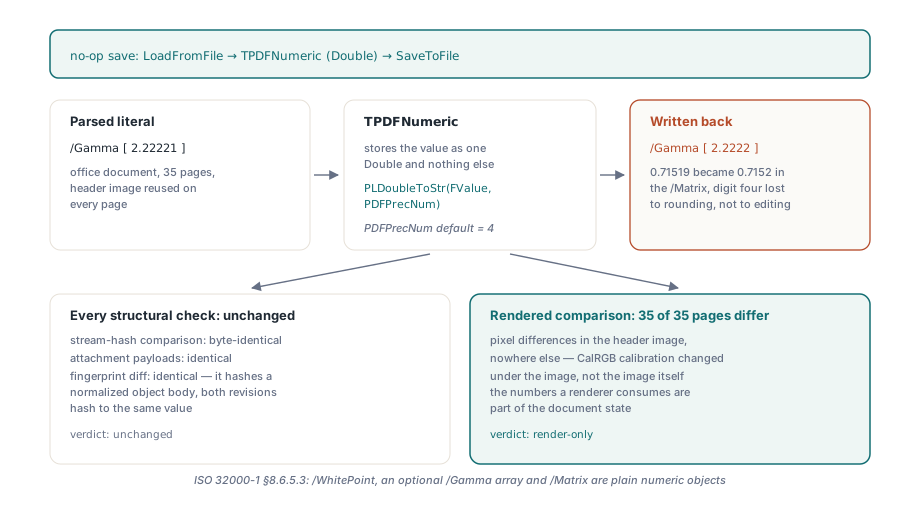
Laad een gekalibreerde PDF, verander niets, sla hem onder een nieuwe naam op en diff de kleurruimte-dictionary: /Gamma [2.22221 2.22221 2.22221] ging erin, /Gamma [2.2222 2.2222 2.2222] kwam eruit. De writer herformatteerde een getal dat hij nooit had hoeven aanraken, en de pagina rendert nu in iets andere kleuren. Het middel is elk geparseerd decimaal als twee dingen tegelijk behandelen, een waarde voor rekenwerk en een literal voor uitvoer, en de literal blijven uitgeven totdat iemand echt een nieuwe waarde toekent
Waarom een no-op save CalRGB-kleuren kan verschuiven
De pixels verschuiven omdat de renderer iets andere kalibratiedata krijgt aangereikt terwijl de imagebytes identiek blijven. ISO 32000-1 §8.6.5.3 definieert een CalRGB-kleurruimte via een verplichte /WhitePoint, een optionele /Gamma-array van drie elementen en een optionele /Matrix van negen elementen, en allemaal zijn het gewone numerieke objecten in de kleurruimte-dictionary. Duw die door een Double en een formatter die vastzit op vier decimalen, en 2.22221 wordt 2.2222 terwijl een matrixentry van 0.71519 0.7152 wordt. Een gamma-waarde is een exponent die over elke component van elke pixel valt die door die ruimte gaat, dus de verandering is overal zichtbaar waar de ruimte gebruikt wordt
Voor een bestand dat één CalRGB-ruimte declareert voor een headerafbeelding die op 35 pagina's hergebruikt wordt, renderen alle 35 headers met verschoven kleuren en verandert er verder niets op die pagina's. De controles waar mensen eerst naar grijpen komen schoon terug. Een hash van gedecodeerde streambytes vergelijkt imagedata, en de imagedata is echt identiek; de schade zit in een dictionary. De revisiediff uit het artikel over het modification level fingerprint een genormaliseerde objectbody, dus ook daar hashen de twee revisies naar dezelfde waarde. Een gerenderde paginavergelijking is wat hem vangt. Voor elke pipeline die PDF's van andere software herschrijft, zouden we een per-pagina rendervergelijking vóór elke structurele controle zetten
Hoe een echt getal in een PDF eruit mag zien
ISO 32000-1 §7.3.3 definieert een echt getal als een decimale string: een optioneel teken, cijfers, een punt, meer cijfers. Geen radix-notatie. Geen exponentvorm. Annex C, dat implementatielimieten opsomt, verwacht dat grofweg vijf significante decimale cijfers in de fractionele aanduiding worden gerespecteerd. Een standaarduitvoerprecisie van vier zit daarmee al een cijfer onder wat de specificatie lezers laat behouden, en het bestand deed niets fout door er vijf te gebruiken
Rond nul presteert een naïeve formatter het slechter dan een cijfer verliezen. De gebruikelijke manier om een Double op N plaatsen te printen is vermenigvuldigen met 10^N, afronden op een geheel getal en de cijfers uitschrijven, en als dat getal nul is, is de uitvoer 0. Geef hem de eerste operand van 0.00001 0 0 1 0 0 cm op vier plaatsen en het resultaat is 0 0 0 1 0 0 cm, een singuliere matrix die alles wat eronder getekend wordt doet verdwijnen. Een /Matrix-entry van -0.000012345 gaat dezelfde kant op
Als PDF Library for Delphi (PDFlibPas) zelf een Double moet formatteren, houdt hij voor een niet-nulwaarde kleiner dan de precisiestap het gevraagde aantal significante cijfers aan in plaats van 0 te schrijven. Op vier plaatsen wordt 0.00001 geschreven als 0.00001 en 0.0000123 als 0.0000123; alleen groottes onder grofweg 5E-16 komen er nog als 0 uit. Daarmee blijven nieuw geschreven getallen gezond. Een geparseerd getal dat nooit herformatterd hoefde te worden is een andere zaak, en de bibliotheek pakt dat aan door het helemaal niet te herformatteren
Hoe PDFlibPas de literal bewaart die hij parste
TPDFStructure.Decode houdt de brontekst van elke standaard real die hij tokeniseert vast, dus een token met een decimale punt en zonder exponentmarkering, vlak naast de omgerekende Double. TPDFNumeric.Output schrijft die tekst terug zodra hij aanwezig is en formatteert de Double pas op de PDFPrecNum van de structuur als dat niet zo is. TPDFNumeric.SetTo gooit de tekst weg, want een bewerkt getal is een nieuw getal en hoort de huidige uitvoerprecisie te volgen
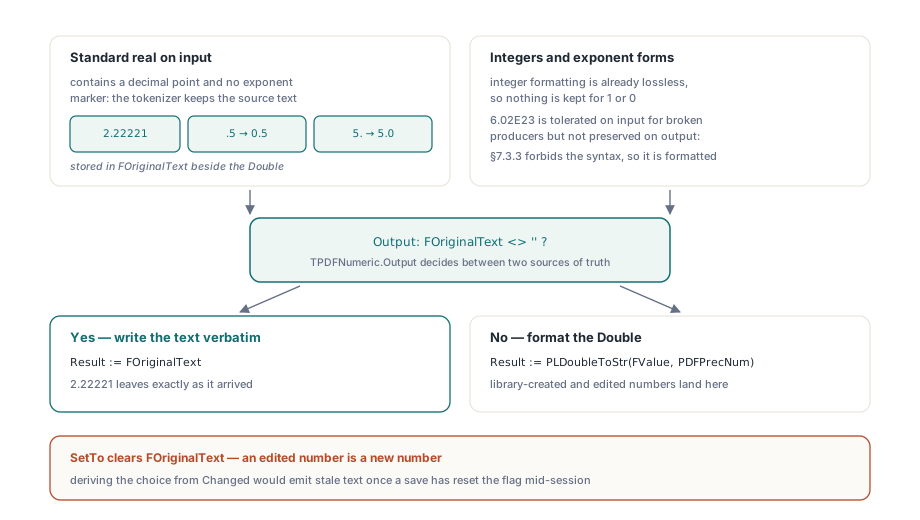
De reset aan SetTo knopen was bewust. De verleidelijke snelkoppeling is de originele tekst uitgeven tenzij de Changed-vlag van het object staat, want die vlag bestaat al op elk object. Alleen wist de save-pipeline Changed zodra een object geschreven is, dus een waarde die bewerkt, opgeslagen en in dezelfde sessie nog eens bewerkt wordt, zou bij de tweede save terugvallen op het uitzenden van zijn oude literal. De tekst in de toekenning zelf wissen betekent dat literal en waarde nooit kunnen uiteenlopen
Een paar grenzen zijn bewust gekozen. Integers worden niet als tekst bewaard, omdat integerformattering al verliesvrij is. Exponentvormen zoals 6.02E23 worden op invoer geaccepteerd voor producenten die ze toch schrijven, maar worden bij de uitvoer geformatteerd als elk door de bibliotheek gegenereerd getal, want ze terughandhaven zou een syntaxis in stand houden die §7.3.3 uitsluit. De tokenizer past ook zijn gebruikelijke kleine reparatie toe voordat hij de tekst bewaart: een literal met beginpunt zoals .5 wordt als 0.5 bewaard, een literal met eindpunt zoals 5. als 5.0. Elke lezer behandelt elk paar als hetzelfde getal, en de gerepareerde spelling wordt veel breder geaccepteerd
Het onderstaande fragment haalt de CalRGB-waarden rechtstreeks door de objectlaag, zodat elke regel te zien is zonder een PDF-bestand te openen. De Assert-regels zijn controles die we aanraden in je eigen tests; het zijn geen aanroepen van de bibliotheek
uses
  PDFlibStruct;

var
  Structure: TPDFStructure;
  Values: TPDFArray;
  Number: TPDFNumeric;
begin
  Structure := TPDFStructure.Create;
  try
    Structure.PDFPrecNum := 4;
    Values := TPDFArray(Structure.Decode('[2.22221 0.71519 -0.000012345 1 0.12567]'));

    // Eigen controle: onaangeroerde invoer overleeft letterlijk, inclusief de
    // waarde die een naïeve formatter op vier plaatsen tot 0 zou laten kelderen
    Assert(Values.Output = '[ 2.22221 0.71519 -0.000012345 1 0.12567 ]');

    // Een bewerking gooit de originele tekst weg en volgt PDFPrecNum
    Number := TPDFNumeric(Values.Item[0]);
    Number.SetTo(0.123456);
    Assert(Number.Output = '0.1235');
    Assert(Structure.NewNumeric(0.123456).Output = '0.1235');

    // Kleine nieuwe waarden behouden significante cijfers in plaats van 0 te worden
    Assert(Structure.NewNumeric(0.0000123).Output = '0.0000123');

    // De precisie achteraf verlagen reikt niet tot onaangeroerde invoer
    Structure.PDFPrecNum := 2;
    Assert(TPDFNumeric(Values.Item[1]).Output = '0.71519');
  finally
    Structure.Free;
  end;
end;
Eén valkuil bij het schrijven van assertions als deze: de Round van Delphi gebruikt bankers rounding, en 0.000012345 * 1e8 evalueert binair tot 1234.4999… in plaats van 1234.5. We liepen bij het controleren van het near-zero-formatteerpad dwars door die waarde heen. Kies testinvoer die geen binair middelpunt is zodra een assertion afhangt van hoe de laatste cijfer afrondt
Wat regelt SetPrecision?
TPDFlib.SetPrecision zet het aantal decimalen van getallen die de bibliotheek schrijft: graphics getekend via de painter, getallen gemaakt uit een Double zoals via NewNumeric, en geparseerde waarden die sindsdien met SetTo zijn veranderd. Hij accepteert 2 tot en met 8 en geeft 0 terug voor alles daarbuiten. Een geparseerd decimaal dat niemand heeft bewerkt houdt zijn invoertekst, welke instelling er ook staat, en de instelling na LoadFromFile veranderen reikt er niet terug naar in. Bron die aan SetObjectFromString wordt doorgegeven loopt door dezelfde tokenizer en wordt op dezelfde manier bewaard
Ons advies is SetPrecision met rust te laten, tenzij de geometrie die je genereert fijnere stappen nodig heeft. Verhogen om invoerbestanden te beschermen levert niets op, want onaangeroerde invoer behoudt toch al zijn eigen cijfers, en het maakt elk getal dat je tekent langer. Vijf plaatsen is een verstandige keuze voor tekenwerk onder de punt; acht maakt content streams vooral dikker
uses
  PDFlibrary;

var
  PDF: TPDFlib;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;

    // Stuurt de getallen die vanaf hier worden geschreven; de geparseerde /Gamma-,
    // /Matrix- en /WhitePoint-arrays houden hun originele tekst
    PDF.SetPrecision(5);

    PDF.SelectPage(1);
    PDF.SetLineWidth(0.123456);       // getekende getallen gebruiken vijf plaatsen
    PDF.DrawLine(72, 72, 300, 72);

    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Content streams: bewerkingen houden operands, normaliseren is opt-in
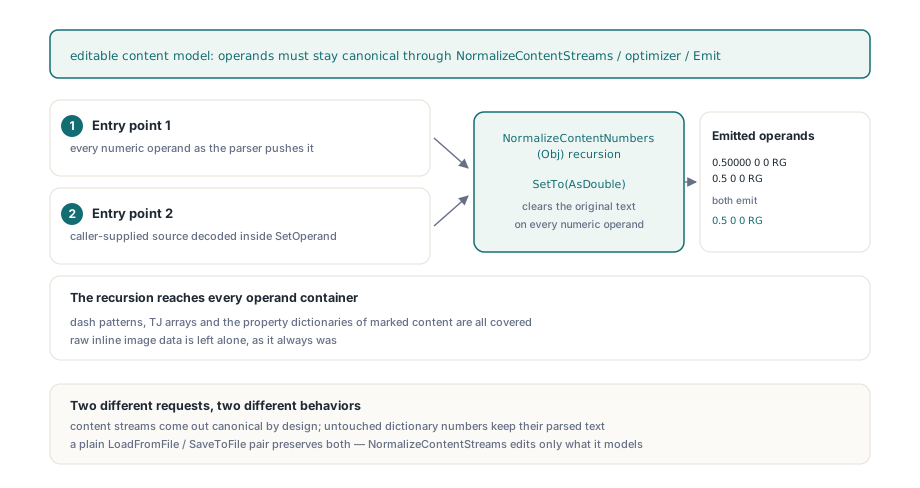
Het bewerkbare contentmodel houdt operandtekst standaard vast en canoniseert getallen alleen wanneer canonieke uitvoer het doel van de aanroep is. TPDFContentProgram.CanonicalNumbers staat standaard op False, dus een laag die ParsePageContentLayer teruggeeft, hetzelfde model waarop de graphics-state tracker is gebouwd, geeft elke onaangeroerde numerieke operand exact zoals geschreven opnieuw uit. Paginabewerkingen die een hele laag herschrijven, inclusief ScalePage, TransformPageElement, DeletePageElement, RedactRegion, ConvertTextToPaths en je eigen programma dat met WritePageContentLayer wordt teruggeschreven, veranderen alleen de operands die de bewerking raakte
De andere standaard ziet er netter uit: canoniseren bij elke parse, zodat het bewerkingspad en NormalizeContentStreams altijd dezelfde spelling produceren. Wij vinden dat de verkeerde standaard voor bewerken. Een ScalePage-aanroep op een laag met 0.123456 w zou 0.1235 w terugschrijven, en elke andere operand in de laag zou mee worden herschreven, ook al vroeg de aanroeper alleen om schalen. Canonieke vorm hoort bij bewerkingen waarvan het doel vergelijkbare uitvoer is
Die bewerkingen krijgen hem ook. NormalizeContentStreams en de contentoptimizer die bij het opslaan draait zolang content wordt gecomprimeerd, parsen met CanonicalNumbers op True, want hun taak is stabiele uitvoer uit willekeurige invoer; als 0.50000 0 0 RG en 0.5 0 0 RG verschillend werden uitgegeven, zou elke downstream-vergelijking meebewegen met de formatteringsgewoonten van de producent. Canoniseren loopt door arrays en dictionaries heen, dus dashpatronen, TJ-arrays en marked-content-property-dictionaries zijn gedekt, terwijl ruwe inline imagedata met rust wordt gelaten. Operands die via SetOperand worden aangeleverd, worden canoniseerd wat de vlag ook zegt. Een contentprogramma draagt zijn eigen getalopslag met vier decimalen vast, onafhankelijk van SetPrecision, dus een bewerkte operand komt met vier decimalen uit. Alleen Parse leest de vlag, wat betekent dat hij vóór het parsen gezet moet zijn; voor een programma dat ParsePageContentLayer al heeft geparsd, zet de vlag en roep Parse(Emit) aan
uses
  PDFlibrary, PDFlibContentModel, PDFlibContentOps;

var
  PDF: TPDFlib;
  Prog: TPDFContentProgram;
  I: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('calibrated.pdf', '') <> 1 then
      Exit;
    PDF.SelectPage(1);
    Prog := PDF.ParsePageContentLayer(1);
    if Prog = nil then
      Exit;
    try
      // Verander één lijndikte; elke andere operand houdt zijn brontekst
      I := Prog.FindNextOp(0, coLineWidth);
      if I >= 0 then
        Prog.SetOperand(I, 0, '0.123456');   // uitgegeven als 0.1235
      PDF.WritePageContentLayer(1, Prog);

      // Canonieke kopie alleen ter vergelijking, niet teruggeschreven:
      // Parse is de enige lezer van de vlag, dus opnieuw parsen na het zetten
      Prog.CanonicalNumbers := True;
      Prog.Parse(Prog.Emit);
      // Prog.Emit schrijft 0.50000 en 0.5 nu op dezelfde manier
    finally
      Prog.Free;
    end;
    PDF.SaveToFile('calibrated-out.pdf');
  finally
    PDF.Free;
  end;
end;
Samengevat is de regel voor aanroepers kort. Een kale LoadFromFile gevolgd door SaveToFile laat onaangeroerde content streams en onaangeroerde dictionarygetallen zoals ze waren. Een pagina bewerkt via het contentmodel houdt de tekst van elke operand die de bewerking niet veranderde vast. NormalizeContentStreams, de optimizer die bij het opslaan draait zolang content wordt gecomprimeerd, en elk programma dat met CanonicalNumbers op True is geparsd produceren opzettelijk canonieke getallen, en de rest van het document blijft bewaard
Wat het kost, en waar de garantie ophoudt
Elke TPDFNumeric draagt één extra AnsiString-referentie, en elk geparseerd decimaal houdt zijn brontekst in leven zolang het object leeft. Op een document met miljoenen echte getallen is dat meetbaar geheugen, en het hoort in elke large-document-benchmark die je draait. De garantie is ook begrensd tot het document van het getal zelf. Objecten tussen documenten kopiëren, of waarden via de object-API herbouwen, levert nieuwe getallen op, en nieuwe getallen volgen de uitvoerprecisie
Bewaarde getallen en byte-identieke uitvoer zijn gescheiden eigenschappen. Een load-and-save van een onaangeroerd document houdt de kalibratiegetallen vast die de renderer verbruikt, maar byte-identiteit hangt ook af van objectnummering, streamcompressie en de trailer-identifier uit het artikel over de deterministische PDF-ID. De fingerprint-diff blijft de genormaliseerde body hashen, wat betekent dat afrondingsverschillen in bestanden van andere tools buiten zijn vergelijking vallen; een rendervergelijking blijft de controle voor die gevallen
De numerieke behandeling en de exacte SetPrecision-semantiek staan in de referentie van de losLab PDF Developer Library, samen met de contentmodel-aanroepen die hierboven werden gebruikt