인프로세스 Tesseract 호출의 5,000 ms 인식 타임아웃은 호출이 5초 뒤에 돌아온다는 뜻이 아닙니다. 큰 다국어 모델 세트라면 호출 스레드가 그 훨씬 넘어서까지 네이티브 라이브러리 안에 머물 수 있습니다. 마감을 강제하는 progress monitor는 워드가 인식되는 동안에만 폴링되는데, 모델 로딩과 페이지 레이아웃 분석은 첫 폴링 전에 일어나기 때문입니다. 그 공백, C 반환 타입이 한 바이트짜리 cancel 콜백, 그리고 절대 해제해서는 안 되는 메모리를 내어주는 반복자가 Tesseract C API를 Delphi에 묶는 실제 작업입니다. 나머지는 배관입니다
Tesseract DLL을 HotPDF 텍스트 레이어에 물리기
HotPDF는 인프로세스 경로를 HPDFTesseractRecognition 유닛의 HPDFCreateTesseractDLLOCREngine으로 노출합니다. 팩토리는 C API를 익스포트하는 Tesseract DLL을 로드하고 TessBaseAPIInit2와 TessBaseAPIRecognize, 결과 반복자를 몰아주며 IHPDFOCREngine을 돌려줍니다. THotPDF.ApplyLoadedOCRTextLayer는 그 엔진을 받아 스캔 페이지에 보이지 않는 검색 가능한 유니코드 텍스트 레이어를 얹고, 모든 HotPDF OCR 엔진이 거치는 바로 그 호출입니다
팩토리는 선제적으로 검증합니다. DLL 파일과 tessdata 디렉터리가 존재해야 합니다. 언어 식별자는 ASCII 글자, 숫자, _, +만 담을 수 있고 chi_sim+eng 같은 조합의 모든 모델에는 맞는 .traineddata 파일이 필요합니다. 21개 필수 익스포트 전부가 해석되어야 엔진을 돌려받습니다. 설정 오류는 이름까지 적어 EArgumentException을 던지고, 로드되지 않는 DLL은 아키텍처와 의존성 점검 힌트를 얹은 Windows 오류 코드와 함께 EOSError를 던집니다
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Win64 애플리케이션에는 64비트 DLL이 필요하고, 파일 이름은 빌드에 따라 다르며,
  // 의존성 DLL들은 같은 폴더에 둡니다
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default를 씀
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // 빈 페이지 목록은 모든 페이지를 뜻하고, 이미 텍스트를 얹은 페이지는 건너뜁니다
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;THPDFTesseractOptions.Default는 PageSegMode를 tpsAuto로, EngineMode를 temDefault로, TimeoutMilliseconds를 60,000으로, MaxPixels를 16,777,216으로 놓습니다. 이 픽셀 예산은 사람들이 기대하는 것보다 빨리 물립니다. 기본 300 DPI의 US Letter 페이지는 2,550 × 3,300픽셀, 약 840만으로 들어옵니다. 같은 페이지를 600 DPI로 올리면 5,100 × 6,600, 약 3,370만 픽셀이 되고, 엔진은 Tesseract가 이미지를 보기도 전에 Invalid Tesseract DLL OCR request or pixel budget으로 거부합니다. MaxPixels를 올리거나(천장은 67,108,864) 본문 텍스트에는 충분한 300 DPI에 머무세요. 각 변은 32,767픽셀로도 갈립니다
DLL은 LoadLibraryEx와 DLL 자체 폴더 더하기 기본 safe 디렉터리 검색 플래그로 로드됩니다. 덕분에 Tesseract가 의존하는 이미지 라이브러리들은 곁에 둘 수 있고, PATH를 만지거나 현재 디렉터리에 기대지 않아도 됩니다. HotPDF는 OCR 런타임이나 언어 모델을 번들하거나 다운로드하지 않습니다. 둘 다 직접 공급합니다
tesseract.exe와 비교한 DLL 경로의 차이
같은 인식기는 BMP를 쓰고 TSV를 파싱하는 외부 tesseract.exe 어댑터로도 닿습니다. 두 어댑터는 하나의 텍스트 레이어 파이프라인에 먹이므로 좌표 매핑, 신뢰도 필터링, all-or-nothing 커밋은 똑같이 동작합니다. 다른 것은 픽셀이 어떻게 들어가고, 워드가 어떻게 나오고, 인식기가 말썽을 부릴 때 무슨 일이 벌어지는가입니다
| 측면 | tesseract.exe 어댑터 | Tesseract DLL 어댑터 |
|---|---|---|
| 팩토리 | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| 픽셀 입력 | private 임시 디렉터리의 BMP 파일 | 메모리의 8비트 그레이스케일 버퍼 |
| 워드 출력 | 워드 단위 TSV, 64 MiB로 갈림 | 결과 반복자, 워드별 UTF-8 |
| 베이스라인 | TSV에 없음, 파이프라인이 추정 | TessPageIteratorBaseline에서 전달 |
| 페이지 분할과 엔진 모드 | --psm과 --oem으로 보내지는 THPDFTesseractOptions 오버로드 | TessBaseAPISetPageSegMode와 TessBaseAPIInit2로 보내지는 THPDFTesseractOptions |
| 픽셀 예산 | 옵션을 넘길 때 MaxPixels | 항상 MaxPixels, 변당 32,767픽셀 추가 |
| 타임아웃 | 하드: 자식 프로세스가 종료됨 | 협력적: Tesseract가 알아차려야 함 |
| 크래시와 메모리 격리 | 별도 프로세스 | 없음, 주소 공간을 공유 |
비용 하나는 DLL에 그대로 남습니다. 각 Recognize 호출은 자기 API 인스턴스를 만들고 TessBaseAPIInit2를 돌리므로, 언어 모델이 페이지마다 초기화됩니다. 파일 캐시가 재로드의 부담을 덜어 주지만, 큰 다국어 모델 세트에서는 페이지당 가장 큰 고정 비용으로 남고 인식 마감에도 집계됩니다. 인프로세스 RapidOCR DLL 엔진은 반대 선택을 해 엔진 수명 내내 ONNX 모델을 상주시키는데, 경계 문제들(C ABI, 빌린 버퍼, 중단할 수 없는 네이티브 작업)은 같은 계열에 속합니다
그렇다면 프로덕션에는 어느 쪽이 맞을까요? 몇백 장의 스캔을 다루는 데스크톱 도구나 배치 작업이라면 DLL이 더 맞습니다. 페이지마다 프로세스를 띄우지 않고, 디스크에 임시 비트맵을 놓지 않고, 기울어진 행에 대한 진짜 베이스라인을 얻습니다. 낯선 이들의 PDF를 받는 오래 도는 서버라면 tesseract.exe에 머무세요. 네이티브 크래시나 폭주하는 할당이 여러분 서비스 대신 자식 프로세스 하나를 끌고 내려갑니다
Delphi는 Tesseract monitor 구조체를 왜 복사할 수 없을까?
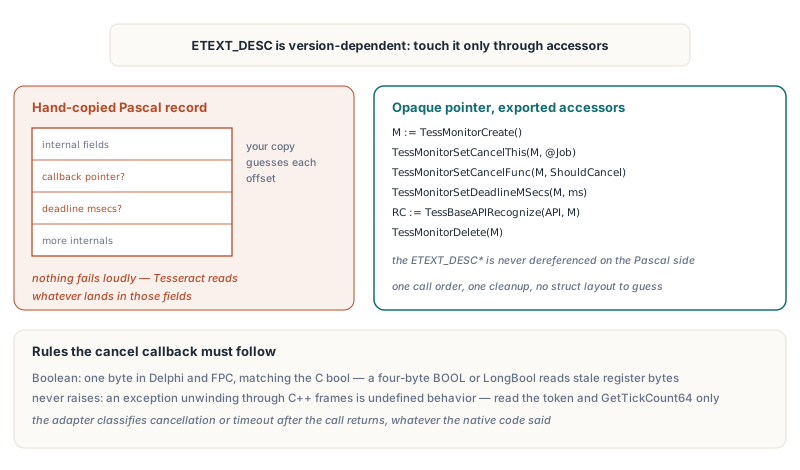
Delphi는 Tesseract의 progress monitor를 안전하게 미러링할 수 없습니다. ETEXT_DESC가 Tesseract 빌드마다 달라지는 내부 필드를 갖기 때문입니다. 한 헤더에서 손으로 번역한 레코드는 cancel 콜백과 마감을 그 헤더가 쓰던 오프셋에 놓습니다. 다른 빌드에 대해 돌리면 Tesseract는 이제 다른 것을 뜻하는 필드에서 여러분의 콜백 포인터를 읽거나 마감을 아예 찾지 못하고, 인식은 그저 끝까지 돕니다
그래서 HotPDF 어댑터는 monitor를 불투명 포인터로 취급하고 익스포트된 함수로만 만집니다. TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs, TessMonitorDelete가 그 대상입니다. 아래 스케치는 HotPDF API가 아니라 여러분의 바인딩 코드이며, 그 선언들은 어댑터가 GetProcAddress로 해석하는 것들과 일치합니다
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, 절대 역참조 금지
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // 여러분의 작업 상태, HotPDF 타입이 아님
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Tesseract의 스택에서 돎: 플래그와 시계만 읽고, 절대 raise하지 않음
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// 사용법. 함수 포인터는 GetProcAddress로 해석:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
스케치는 콜백을 Boolean, 즉 Delphi와 Free Pascal 모두에서 한 바이트로 타이핑하는데, 이는 TessCancelFunc의 C bool과 맞습니다. 네 바이트 Windows BOOL과 Delphi LongBool은 호환돼 보이지만 다른 타입입니다. 한쪽은 한 바이트를 쓰고 다른 쪽은 네 바이트를 읽으면 위 세 바이트는 레지스터에 남아 있던 무엇이든 되고, false가 true로 도착할 수 있습니다. TessPageIteratorBoundingBox는 int를 돌려주므로 Pascal 쪽에서 Integer로 선언합니다. API 전체에 규칙 하나를 가정하지 말고 반환값마다 C 타입을 읽으세요
콜백은 또한 절대 raise하지 않습니다. Tesseract의 C++ 프레임을 지나 언와인딩되는 Delphi 예외는 정의되지 않은 동작입니다. HotPDF 콜백은 취소 토큰과 단조 증가하는 GetTickCount64 값만 읽고, 어댑터는 TessBaseAPIRecognize가 돌아온 뒤 그 결과를 취소나 타임아웃 진단으로 바꿉니다. 이 검사는 네이티브 반환 코드가 0이든 아니든 돌립니다
Delphi 쪽은 어떤 네이티브 포인터를 소유할까?
HotPDF Tesseract DLL 어댑터는 요청마다 세 네이티브 객체(API 인스턴스, monitor, 결과 반복자)를 소유하고 나머지는 모두 빌립니다. 각 Recognize 호출은 자기 세트를 만들고 finally 블록 안에서 고정된 순서로 해제합니다. TessResultIteratorDelete, 이어서 TessMonitorDelete, 이어서 TessBaseAPIDelete입니다. 엔진 인터페이스를 해제하면 DLL에 FreeLibrary를 부릅니다
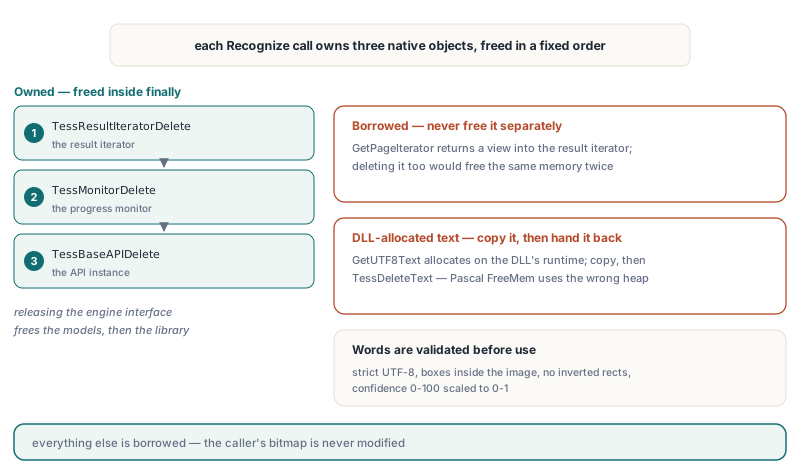
TessResultIteratorGetPageIterator는 새 객체가 아니라 결과 반복자 안을 보는 뷰를 돌려줍니다. 어댑터는TessPageIteratorBoundingBox와TessPageIteratorBaseline에 그것을 쓰고 절대 해제하지 않습니다. 이것까지 지우면 같은 메모리를 두 번 해제합니다TessResultIteratorGetUTF8Text는 DLL 자체 런타임이 할당한 문자열을 돌려줍니다. 어댑터는 그것을 디코딩하고finally블록에서TessDeleteText로 돌려줍니다. PascalFreeMem은 엉뚱한 힙에서 해제합니다- 워드 텍스트는 길이 검사를 거친 엄격한 UTF-8 디코딩을 통과합니다. 제어 문자를 담았거나, UTF-8이 망가졌거나, 이미지 밖의 박스, 뒤집힌 사각형, 0-100 밖의 신뢰도를 가진 워드는 요청을 실패시킵니다. 어댑터는 덧수선하지 않습니다
- 요청당 텍스트는 1,048,576 UTF-16 코드 단위로 갈리고, 워드 수는
ApplyLoadedOCRTextLayer가 페이지마다 내려주는 예산 안에 들어야 합니다
신뢰도는 0-100으로 도착해 0-1로 스케일되므로, THPDFOCRTextLayerOptions.MinimumConfidence는 모든 엔진에서 같은 뜻입니다. Tesseract가 베이스라인을 보고하면 양 끝점이 그대로 전달되고, 주로 수직인 워드에는 박스 폭이 텍스트 높이로 쓰입니다. 베이스라인이 없으면 텍스트 레이어 파이프라인은 TSV 입력일 때와 마찬가지로 기하학적 추정으로 폴백합니다
DLL에 닿기 전에 enum 옵션 범위 검사하기
팩토리는 PageSegMode와 EngineMode의 raw 바이트를 범위 검사 전에 Integer로 복사합니다. 컴파일러는 enum 변수가 항상 선언된 값을 담는다고 가정할 권리가 있으므로, enum에 바로 쓴 Ord(X) > Ord(High(T)) 같은 검사는 상수 false로 접혀버릴 수 있습니다. 그 서수들은 평범한 정수로 DLL에 닿습니다. THPDFTesseractPageSegMode는 Tesseract의 0부터 13까지 페이지 분할 번호를 따르고 THPDFTesseractEngineMode는 0부터 3까지 엔진 모드 번호를 따릅니다. FillChar로 지워졌거나, 스트림에서 읽었거나, C++Builder에서 정수 캐스트로 채워진 옵션 레코드는 200 같은 바이트를 달고 있을 수 있고, 사본을 검증하면 그것이 팩토리 시점의 EArgumentException으로 바뀝니다. 팩토리는 또한 워드를 돌려주지 않는 tpsOSDOnly와 tpsAutoOnly를 거부하고, tpsAutoOSD와 tpsSparseTextOSD에는 osd.traineddata를 요구합니다
인식 타임아웃은 실제로 무엇을 보장할까?
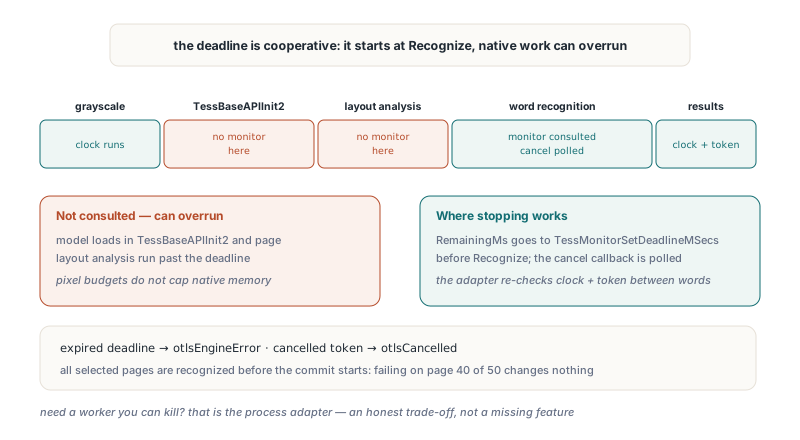
Tesseract DLL 타임아웃은 협력적입니다. HotPDF는 자기 작업을 멈추고 Tesseract에도 멈춰 달라고 할 수 있지만, 네이티브 코드가 반환하도록 강제할 수는 없습니다. 시계는 Recognize가 시작될 때 돌기 시작하므로, 그레이스케일 변환과 모델 초기화도 인식과 같은 예산을 씁니다. 어댑터는 그레이스케일 변환 중 64행마다, 초기화 뒤, 그리고 결과를 훑는 동안 워드마다 경과 시간과 취소 토큰을 확인합니다. TessBaseAPIRecognize 직전에는 남은 밀리초를 TessMonitorSetDeadlineMSecs에 넘깁니다
공백은 네이티브 호출 안쪽에 있습니다. Tesseract는 워드 인식 중에만 monitor를 참조하므로, TessBaseAPIInit2나 페이지 레이아웃 분석 안에서는 느린 모델 로드나 병적인 레이아웃이 타임아웃이 보고되기 전에 마감을 넘어설 수 있습니다. 픽셀과 출력 예산도 네이티브 라이브러리 자체의 메모리 사용을 갈지 않습니다. 그냥 죽일 수 있는 워커가 필요하다면 그 도구는 프로세스 어댑터입니다
페이지 분할이 곤란한 입력에서 DLL 어댑터가 빛을 보는 지점입니다. 흩어진 필드를 가진 양식, 라벨, 스캔 테이블은 존재하지 않는 단과 문단을 조립하려 드는 자동 분할보다 tpsSparseText에서 더 잘 인식되곤 합니다. 아래의 타임아웃은 양식 페이지 치고 짧지만 그래도 모델 초기화까지 커버해야 합니다
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // 흩어진 필드, 단 조립 없음
  TessOptions.EngineMode := temLSTMOnly;     // tessdata에 LSTM 모델 필요
  TessOptions.TimeoutMilliseconds := 20000;  // 모델 초기화 포함
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
타임아웃은 진단에 Tesseract DLL OCR timed out을 실은 otlsEngineError로 드러납니다. THPDFOCRTextLayerOptions.CancellationToken으로 넣은 토큰은 otlsCancelled로 드러납니다. 두 경우 모두 ApplyLoadedOCRTextLayer는 커밋을 시작하기 전에 선택된 모든 페이지를 인식하므로, 50페이지 중 40페이지의 실패는 로드된 문서를 그대로 둡니다. tpsSingleLine, tpsSingleBlock, tpsSparseText는 분할만 바꿉니다. 어느 것도 기울어진 스캔을 펴 주지는 않습니다
Free Pascal과 Lazarus: 낡은 픽셀과 잃어버린 중국어
두 Tesseract 팩토리는 라자루스 패키지가 대상 아키텍처로 재빌드만 되면 Windows Free Pascal과 Lazarus Win32, Win64 빌드에서 동작합니다. 일반적인 포팅은 Free Pascal과 Lazarus Win64의 HotPDF가 다룹니다. FPC가 달라지는 곳은 입력 처리입니다
scanlines로 기록한 LCL TBitmap은 Windows 비트맵 핸들을 새로 고치지 않은 채 raw 이미지를 갱신할 수 있습니다. 그 핸들에 GetDIBits를 부르면 옛 픽셀이 돌아옵니다. 증상은 당황스럽습니다. 비트맵에 직접 그린 텍스트는 인식되는데, scanlines로 렌더링한 페이지는 워드를 하나도 못 얻습니다. FPC에서는 DLL 어댑터가 CreateIntfImage로 포맷을 아는 스냅샷을 읽어 raw 이미지의 픽셀 포맷과 행 순서를 존중합니다. Delphi 빌드는 private 24비트 사본 위에서 GetDIBits 경로를 유지하고, 어느 빌드도 호출자의 비트맵을 수정하지 않습니다
tesseract.exe 어댑터는 다른 문제를 만납니다. FPC의 TStringList는 ANSI 문자열을 저장하므로, 디코딩된 UTF-8 TSV 텍스트를 Lines.Text에 넣으면 시스템 ANSI 코드 페이지가 표현하지 못하는 중국어와 보충 평면 문자가 모두 떨어져 나갑니다. FPC 경로는 TSV를 UTF-8 바이트로 유지하고, BOM을 바이트 수준에서 잘라내고, 각 워드를 자체적으로 UnicodeString으로 디코딩합니다. DLL 어댑터는 각 워드를 반복자에서 바로 디코딩하므로 이 문제를 만나지 않습니다
Tesseract DLL 어댑터는 프로세스 어댑터들과 내장 OCR 엔진과 함께 Delphi, C++Builder, Free Pascal용 HotPDF에 실려 나갑니다. 에디션과 다운로드는 HotPDF Delphi PDF component 페이지에 나열되어 있습니다