끝을 알리지 않는 파이프는 OCR 기능에서 잡기 이상한 버그입니다. 애플리케이션의 한 스레드는 헬퍼 프로그램의 표준 출력을 읽으며 ReadFile이 ERROR_BROKEN_PIPE로 실패하기를 기다립니다. 다른 스레드는 bInheritHandles를 True로 놓고 CreateProcess로 tesseract.exe를 띄우는데, 자식 프로세스에게 표준 오류용 파일을 물겨 주는 방법이 바로 그것이니까요. 헬퍼의 파이프 쓰기 끝이 상속 가능했으므로 Tesseract가 그 사본을 쥐게 되고, 읽는 스레드는 Tesseract가 페이지를 끝낼 때까지 멈춥니다 — 두 언어 모델을 로드한 300 DPI 스캔에서는 빠른 일이 아닙니다
외부 인식기는 멈춤보다 더 가져옵니다. 자식이 무엇을 볼 수 있는지, 절반쯤 유효한 출력을 어떻게 다룰지, 픽셀 박스를 검색 가능한 PDF 텍스트로 어떻게 바꿀지가 그것입니다. 내장 템플릿 매칭 OCR 엔진은 기계 인쇄 ASCII 글자와 숫자를 표방하고 커버합니다. 악센트 붙은 이름, 중국어 계약서, 다국어 아카이브는 학습된 언어 모델이 필요하고, Tesseract가 통상의 후보입니다. 실행 파일 옆에 설치할 수 있는 명령줄 프로그램이니까요
Tesseract를 HotPDF OCR 텍스트 레이어에 꽂기
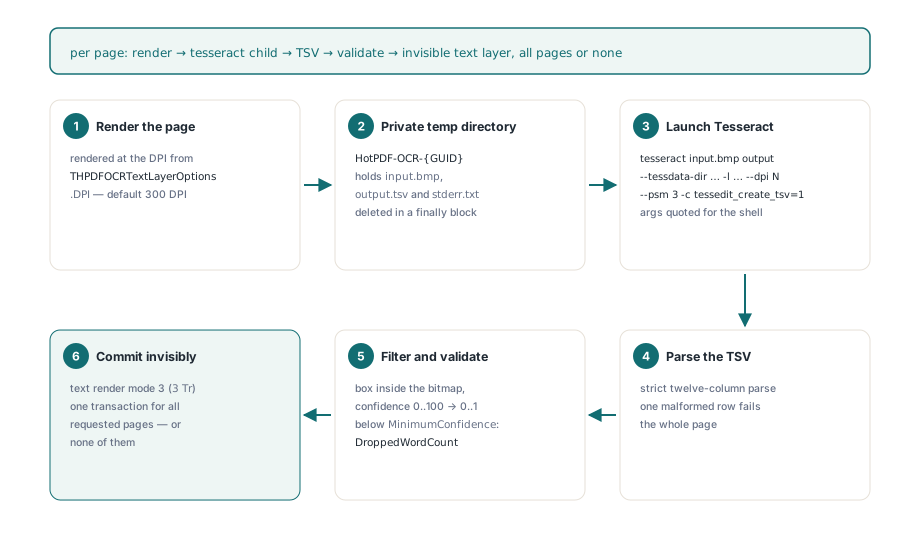
HotPDF는 로컬에 설치된 Tesseract 실행 파일을 HPDFTesseractRecognition 유닛의 HPDFCreateTesseractOCREngine으로 IHPDFOCREngine으로 감쌉니다. 그 엔진을 THotPDF.ApplyLoadedOCRTextLayer에 넘기면 각 요청 페이지를 렌더링하고 페이지마다 Tesseract를 한 번 돌리고, 워드를 걸러, 요청된 모든 페이지의 보이지 않는 유니코드 텍스트 레이어를 한 트랜잭션으로 기록하거나 아무것도 기록하지 않습니다. 좌표 매핑, 회전, 신뢰도 필터링, 커밋은 내장 엔진이 이미 쓰는 파이프라인입니다. 바뀌는 것은 인식뿐입니다
팩토리는 어떤 페이지도 만지기 전에 EArgumentException을 던집니다. 실행 파일과 tessdata 디렉터리가 존재해야 하고, 타임아웃은 1과 3,600,000 밀리초 사이여야 하며, 언어는 ASCII 글자, 숫자, _, +만 담을 수 있습니다. 결국 명령줄에 올라가기 때문입니다. eng+chi_sim은 합법이고 따옴표나 공백을 담은 값은 터지기를 기다리는 인젝션입니다. 두 번째 오버로드는 THPDFTesseractOptions 레코드를 받습니다. 그 Default는 --psm 3, --oem 3, 페이지당 60초, 16,777,216픽셀 상한을 주며, 워드를 돌려주지 않는 두 모드인 tpsOSDOnly와 tpsAutoOnly를 거부합니다
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFTesseractRecognition;

function MakeSearchable(const SourceFile, TargetFile: string;
  Token: THPDFCancellationToken): Boolean;
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default; // psm 3, oem 3, 60 s, 16,777,216 px
  TessOptions.TimeoutMilliseconds := 120000;    // 페이지마다 적용
  // 실행 파일이나 tessdata 폴더가 없거나, 언어 식별자가 나쁘거나,
  // 옵션이 범위 밖이면 EArgumentException을 던짐
  Engine := HPDFCreateTesseractOCREngine(
    'C:\OCR\Tesseract\tesseract.exe',
    'C:\OCR\Tesseract\tessdata',
    'eng+chi_sim',                              // 모델은 '+'로 연결
    TessOptions);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default; // 300 DPI, MinimumConfidence 0.5
    Options.CancellationToken := Token;
    // 빈 페이지 목록은 모든 페이지를 뜻하고, 이미 텍스트가 있는 페이지는 건너뜀
    Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
    if Result then
    begin
      Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
        ' words kept, ', Info.DroppedWordCount, ' below the threshold');
      Doc.SaveLoadedDocument(TargetFile);
    end
    else
      case Info.Status of
        otlsCancelled:      Writeln('Cancelled, document unchanged');
        otlsEngineError:    Writeln('Engine: ', string(Info.Diagnostic));
        otlsBudgetExceeded: Writeln('Budget: ', string(Info.Diagnostic));
      else
        Writeln(string(Info.Diagnostic));
      end;
  finally
    Doc.Free;
  end;
end;
픽셀 산술은 한 번만 하세요. 300 DPI의 A4 페이지는 약 2,481 × 3,508픽셀, 대략 870만으로 들어옵니다. 같은 해상도의 A3는 약 3,508 × 4,961, 1,740만에 가까워 픽셀 예산 진단으로 실패하고 실행은 otlsEngineError로 끝납니다. 타임아웃만 받는 오버로드는 픽셀 상한을 전혀 적용하지 않습니다. 밖에서 온 파일을 받는 서비스라면 옵션 오버로드를 유지하고, 큰 포맷이 예상될 때 MaxPixels를 올리거나(최대 67,108,864) THPDFOCRTextLayerOptions.DPI를 의도적으로 낮추세요
페이지마다 엔진은 temp 경로 아래에 private HotPDF-OCR-{GUID} 디렉터리를 만들고 비트맵을 input.bmp로 저장한 뒤 tesseract input.bmp output --tessdata-dir … -l … --dpi N --psm 3 -c tessedit_create_tsv=1을 돌리는데, 엔진 모드가 설정되면 --oem을 더합니다. 경로는 백슬래시와 내장 따옴표의 Windows 규칙으로 인용되고, --dpi는 렌더 해상도를 실어 Tesseract가 절대 추측하지 않게 합니다. Tesseract와 .traineddata 파일은 번들되지 않습니다. 공급은 애플리케이션의 몫입니다. 우리 Linux 테스트 기계에서는 인식기를 바이너리와 공유 라이브러리 클로저, tessdata 폴더의 사용자 수준 번들로 돌립니다. /usr/bin/tesseract에 기대는 것은 시스템 패키지가 깔린 곳에서만 통하기 때문입니다
깨진 TSV 행 하나가 왜 페이지 전체를 비울까?
Tesseract 어댑터는 첫 malformed 행에서 페이지 전체를 실패시킵니다. 부분적으로 파싱된 워드 목록은 이미지와 어긋난 텍스트 레이어를 내고, 저장된 PDF는 어떤 워드가 빠졌는지 알려 주는 게 없기 때문입니다. 출력은 내장 NUL 없는 엄격한 UTF-8로 디코딩돼야 합니다. 첫 행은 선택적 BOM을 떼어낸 뒤 Tesseract의 12열 헤더, level부터 text까지와 같아야 합니다. 각 행은 정확히 12개 필드로 갈라져야 하고, 분할은 열한 번째 탭 뒤에 멈추므로 인식된 텍스트 안의 탭은 13번째 열을 만드는 대신 텍스트 필드에 착지하고, 아래의 제어 문자 검사가 그것을 거부합니다
레벨 5 행만 워드입니다. 페이지, 블록, 문단, 행 행은 건너뛰며, 비어 있거나 순수 공백인 워드도 그렇습니다. 제어 문자(U+0020 미만, 혹은 U+007F부터 U+009F)를 담은 워드는 페이지를 실패시킵니다. 나머지는 정수 기하와, 독일 로케일 애플리케이션도 93.5를 읽게 하는 불변 포매팅으로 파싱된 신뢰도, 비트맵 안에 완전히 들어간 박스, 0부터 100까지의 신뢰도가 필요합니다. 유효한 워드 하나 뒤에 깨진 행 하나는 워드 0개를 낳습니다
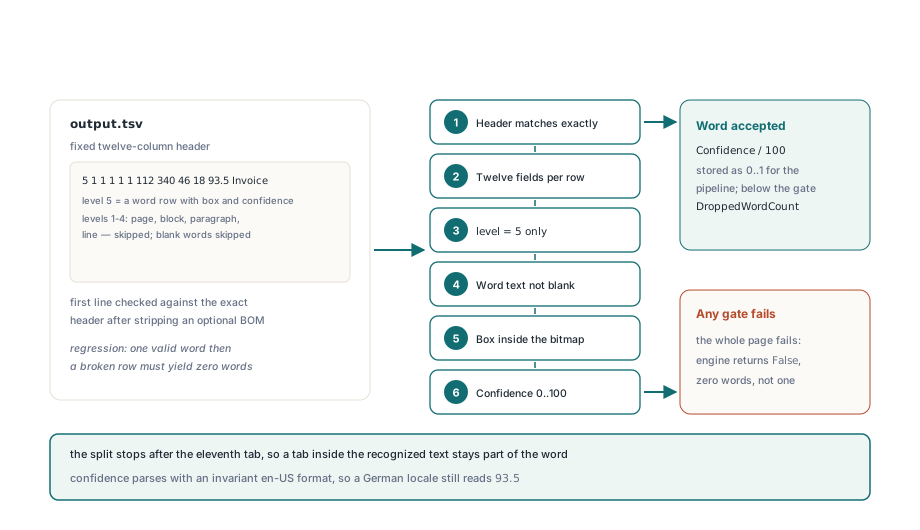
따라서 이상한 행 하나가 실행 전체를 실패시키고 모든 페이지를 그대로 둡니다. 맞는 거래입니다. 재실행은 싸고, 송장 번호 검색이 중요한 그 한 페이지를 놓치는 검색 가능 PDF는 몇 달 뒤 남의 손에서 표면화되기 마련입니다
마지막 단계는 예상 밖의 기본값도 만납니다. Tesseract는 신뢰도를 0부터 100으로 보고하고 파이프라인은 100으로 나누며, THPDFOCRTextLayerOptions.MinimumConfidence의 기본은 0.5라서 50 미만 워드는 페이지 대신 Info.DroppedWordCount에 갑니다. 깨끗한 스캔에서 그 바닥은 합리적입니다. 시끄러운 팩스에서는 텍스트의 큰 몫을 지워버릴 수 있으니, 낮추기 전에 Info.ReceivedWordCount와 Info.AcceptedWordCount를 비교하세요
이미 텍스트를 갖춘 파일에 OCR 다시 돌리기
SkipPagesWithText는 기본이 True라 두 번째 시도에서 사람들을 놀라게 합니다. 배치가 eng로 처리됐는데 이제 eng+deu가 필요하다고 치면, 모든 페이지가 이미 보이지 않는 텍스트를 달고 있어 Info.SkippedPageCount가 페이지 수와 같아집니다. HotPDF는 자기가 기록하는 콘텐츠 스트림에 자기 OCR 레이어라는 표시를 하고, ReplaceExistingOCRTextLayer는 그 표시로 그 페이지들을 다시 인식하며 옛 레이어를 떼어내고 원본 페이지 콘텐츠는 지킵니다
Options := THPDFOCRTextLayerOptions.Default;
Options.ReplaceExistingOCRTextLayer := True;  // 우리가 남긴 레이어를 교체
Options.UseOptionalContentGroup := True;      // 'OCR Text Layer'라 이름 붙은 레이어
Options.CancellationToken := Token;
if Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
  Writeln(Info.ReplacedPageCount, ' replaced, ',
    Info.SkippedPageCount, ' skipped, ',
    Info.RecognizedPageCount, ' recognized')
else
  Writeln(string(Info.Diagnostic));
스캐너 드라이버가 OCR한 파일에는 그런 표시가 없어 그 페이지들은 여전히 텍스트 있는 페이지로 셉니다. SkipPagesWithText를 끄면 첫 레이어 위에 두 번째 보이지 않는 레이어가 쌓이고 모든 검색 히트가 두 번 나타납니다. 그런 파일은 그냥 두세요
Tesseract 프로세스는 어느 핸들을 상속하나?
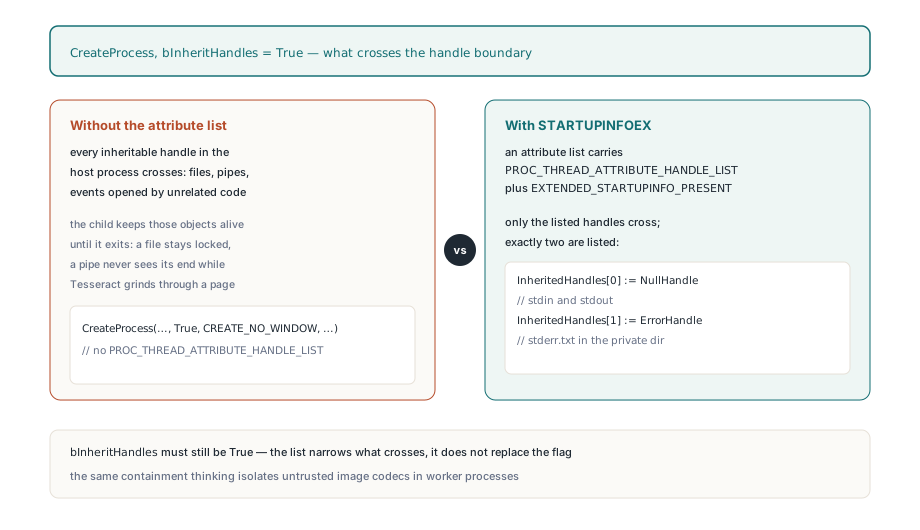
Tesseract 자식 프로세스는 HotPDF에서 정확히 두 핸들을 상속합니다. 표준 입력과 출력용으로 NUL에 연 합니다, 그리고 private 디렉터리의 stderr.txt용 하나입니다. 위의 파이프 멈춤은 CreateProcess 자신에게서 옵니다. 표준 핸들을 넘기려면 bInheritHandles = True가 필요하고, 그 자체로는 호스트가 연 상속 가능한 모든 핸들, 무관한 코드가 연 파이프와 파일, 이벤트까지 넘깁니다. HotPDF는 PROC_THREAD_ATTRIBUTE_HANDLE_LIST를 담은 속성 목록과 EXTENDED_STARTUPINFO_PRESENT 플래그를 갖춘 STARTUPINFOEX를 씁니다. bInheritHandles는 True로 남지만, 목록에 오른 핸들만 경계를 넘습니다
같은 패턴은 애플리케이션이 띄우는 다른 모든 자식 프로세스에도 속합니다. 전부 상속하는 런처 하나면 프로세스 안의 모든 파이프 리더를 멈추게 하기에 충분하니까요
// 여러분 CreateProcess 호출용 패턴 (조각: NullHandle, ErrorHandle,
// Exe, CommandLine, WorkDir, ProcessInfo는 다른 곳에 선언됨).
// 오래된 Delphi RTL은 속성 목록 함수를 선언하지 않습니다. 컴파일러가
// 못 찾으면 kernel32의 external 선언을 직접 추가하세요
// 프로덕션 코드에서는 각 BOOL 결과를 점검하세요
type
  TStartupInfoExRec = record
    StartupInfo: TStartupInfo;
    AttributeList: Pointer;
  end;
const
  HANDLE_LIST_ATTRIBUTE = $00020002;   // PROC_THREAD_ATTRIBUTE_HANDLE_LIST
  EXTENDED_STARTUP_FLAG = $00080000;   // EXTENDED_STARTUPINFO_PRESENT
var
  Startup: TStartupInfoExRec;
  HandleList: array[0..1] of THandle;
  Size: NativeUInt;
begin
  FillChar(Startup, SizeOf(Startup), 0);
  HandleList[0] := NullHandle;         // bInheritHandle = True로 생성
  HandleList[1] := ErrorHandle;        // 마찬가지
  Size := 0;
  InitializeProcThreadAttributeList(nil, 1, 0, Size);
  GetMem(Startup.AttributeList, Size);
  InitializeProcThreadAttributeList(Startup.AttributeList, 1, 0, Size);
  UpdateProcThreadAttribute(Startup.AttributeList, 0, HANDLE_LIST_ATTRIBUTE,
    @HandleList[0], SizeOf(HandleList), nil, nil);
  Startup.StartupInfo.cb := SizeOf(Startup);
  // ... dwFlags와 hStdInput / hStdOutput / hStdError는 평소처럼 설정 ...
  CreateProcess(PChar(Exe), PChar(CommandLine), nil, nil,
    True,                              // 핸들 목록과 함께도 여전히 필요
    CREATE_NO_WINDOW or EXTENDED_STARTUP_FLAG,
    nil, PChar(WorkDir), Startup.StartupInfo, ProcessInfo);
  // 자식이 끝난 뒤: DeleteProcThreadAttributeList, FreeMem, CloseHandle
end;
브리지 스크립트는 Windows 세부를 하나 더 얹습니다. Python 런처는 두 번째 인터프리터 프로세스를 띄울 수 있고, 우리가 만든 프로세스를 종료해도 그것은 살아 남습니다. 엔진에 스크립트 경로가 주어지면, 아래의 RapidOCR 어댑터처럼, HotPDF는 자식을 suspended로 시작해 JOB_OBJECT_LIMIT_KILL_ON_JOB_CLOSE를 단 잡 객체에 넣은 뒤 재개하므로, 잡을 닫으면 트리 전체가 끝납니다. 같은 가두기 발상이 워커 프로세스로 PDF 이미지 코덱을 격리하기를 움직이는데, 거기서 자식은 신뢰할 수 없는 존재입니다. 여기서 자식은 신뢰되지만, 그 안에 핸들을 쥔 코드가 우리 프로세스만인 건 아닙니다
취소, 타임아웃, 전부 아니면 전무 커밋
IHPDFOCREngine.Recognize는 Boolean 하나를 돌려주고 False는 "Tesseract 실패"와 "사용자가 Cancel을 누름"을 함께 커버합니다. 어댑터는 Tesseract가 돌는 동안 25밀리초마다 토큰과 타임아웃을 폴링하고, 취소 시 정리한 뒤 False를 돌려줍니다. 표면대로 받아들이면 otlsEngineError로 읽히므로, ApplyLoadedOCRTextLayer는 Recognize가 False를 돌려줄 때마다 토큰을 먼저 확인합니다. 인식과 콘텐츠 구성은 문서 트랜잭션이 열리기 전에 요청된 모든 페이지에 대해 끝나므로, 50페이지 중 40페이지의 취소는 otlsCancelled를 보고하고 50페이지 전부를 로드된 채로 둡니다. 나머지 한도들도 같은 스타일입니다
- 타임아웃은 각
Recognize호출 시작부터 돌므로, 기본 60,000 ms는 페이지당 한도입니다 - 타임아웃이나 취소 시점에 아직 도는 자식은 종료되고 최대 5초까지 기다려집니다. private 디렉터리는
finally블록에서 제거되며, 프로세스가 끝난 뒤에도 출력 파일이 잠깐 잠길 수 있어 삭제는 최대 1초까지 재시도됩니다 output.tsv는 64 MiB로,stderr.txt는 1 MiB로 갈리며, 자식이 도는 동안과 끝난 뒤에 점검됩니다- 페이지당 워드와 UTF-16 코드 단위는
MaxWordsPerPage,MaxTotalWords,MaxTextCodeUnits의 남은 예산으로 갈리고, 넘어서면 목록을 잘라내는 대신 실행이 실패합니다 - 0이 아닌 종료 코드는
stderr.txt의 최대 4,096자와 함께 돌아오는데,.traineddata파일이 빠졌다는 걸 알리는 가장 빠른 방법입니다
페이지 안에서 보이지 않는 텍스트 레이어의 모습
HotPDF는 워드를 텍스트 렌더링 모드 3으로 기록합니다(채우지도 칠하지도 않음, ISO 32000-1 §9.3.6). 그래서 스캔은 보이는 채로 검색과 복사가 워드 위에서 동작합니다. 콘텐츠 스트림은 BT를 3 Tr로 열고, 각 워드는 베이스라인에 Tm 행렬과, 렌더 DPI로 나눈 박스 높이 픽셀 × 72의 폰트 크기, 행을 박스 폭까지 늘리는 Tz 스케일을 받습니다. 그 늘임이 이미지에서 검색 하이라이트를 워드 위에 유지합니다
TSV에는 박스는 있지만 베이스라인이 없어, 각 베이스라인은 아래 끝에서 박스 높이의 5분의 1 위에 놓입니다. 라틴이나 키릴 같은 공백 분리 문자 체계의 왼쪽에서 오른쪽 행에서 이웃 워드 사이에는 늘어난 공백이 간격을 채워 복사된 텍스트가 단어 나눔을 지키지만, 중국어는 그것이 없습니다. 글리프는 Identity-H 인코딩과 생성된 ToUnicode CMap을 갖춘 공유 비내장 Type0 폰트로 가며, 서로 다른 Unicode 스칼라마다 CID 하나씩이라 중국어와 악센트 라틴, 보충 평면 문자가 복사와 검색을 살아 남습니다. 한 런은 최대 65,535개 서로 다른 스칼라를 담고, ISO 19005가 내장 폰트를 요구하므로 PDF/A 출력에는 적합한 폰트를 별도로 내장해야 합니다. 결과를 확인하려면 저장하고 다시 로드해 Delphi에서 로드된 PDF에서 텍스트 추출하기의 평범한 경로를 돌리세요. 기대한 워드들이 기대한 페이지에서 돌아오면 레이어는 진짜입니다
같은 계약 위의 RapidOCR와 네이티브 DLL
간체 중국어 스캔에는 HPDFCreateRapidOCREngine(PythonExecutable, BridgeScript, ModelDirectory, TimeoutMilliseconds)가 같은 프로세스 러너와 TSV 파서를 재사용합니다. 브리지 스크립트 경로는 Python 실행 파일을 따르고 언어는 chi_sim으로 고정됩니다. HotPDF는 브리지를 tools/OCR/rapidocr_tsv.py로 실어 나르는데, rapidocr와 onnxruntime 패키지, 로컬 ONNX 모델, 폰트 파일이 필요하고, 자동 다운로드를 거부하며, Tesseract 모양의 TSV를 기록합니다. THPDFRapidOCROptions 오버로드가 모델 파일과 스레드 수, 픽셀 상한을 설정합니다. 두 어댑터 뒤의 범용 팩토리, HPDFLocalTSVRecognition의 HPDFCreateLocalTSVOCREngine은 Tesseract식 인자를 받고 12열 TSV를 기록하는 어떤 프로그램이든 받아들이며 핸들 목록과 타임아웃, 취소, 예산을 상속합니다
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language)는 대신 Tesseract C API를 인프로세스로 로드하고 Tesseract (native DLL)로 보고하며, 요청된 모든 .traineddata 파일의 존재를 미리 점검하고, 취소와 타임아웃을 Tesseract 자신의 progress monitor에 사상합니다. 페이지마다 프로세스 시작과 BMP 왕복 하나를 아낍니다. 실행 파일 쪽은 인식기의 크래시와 메모리 성장을 우리 주소 공간 밖에 둡니다. 사용자 자신의 스캔을 다루는 데스크톱 도구라면 DLL로 충분합니다. 낯선 이들의 문서를 삼키는 서비스라면 명령줄 엔진이 더 안전한 선택입니다. 어느 쪽이든 인식은 Windows에서, 한 번에 한 페이지씩, 렌더링된 비트맵 위에서 돌므로, 기울어진 스캔과 지저분한 스캔은 엔진에 닿기 전에 펴고 닦으세요
OCR 어댑터들과 텍스트 레이어 라이터, 그것들에 먹이를 주는 렌더러, 출력을 검증하는 추출이 모두 Delphi와 C++Builder용 네이티브 VCL 컴포넌트 하나에 삽니다. 캡처나 아카이빙 애플리케이션이 검색 가능 PDF 출력이 필요하다면, HotPDF Delphi PDF component가 직접 설치한 OCR 엔진만 빼고 전부를 커버합니다