UI가 기다려 주는 시간보다 오래 스캔 페이지 한 장을 붙들고 있는 OCR 호출을 멈추는 방법으로 TerminateThread가 자명해 보입니다. Windows 문서는 왜 그렇지 않은지 설명합니다. 대상 스레드가 프로세스 힙 락을 쥐고 있다면 그 락은 영영 풀리지 않고, 다른 어떤 스레드의 다음 할당이든 영원히 막힐 수 있습니다. OCR이 우리 프로세스 안에서 돌는 순간 안전한 정지는 협력적인 것뿐입니다. 추론 단계 사이의 체크포인트에서 멈추는 방식이고, ONNX 모델을 한 번 로드해 따뜻하게 유지하는 것의 대가가 바로 이겁니다
Delphi 팀이 대개 먼저 시도하는 대안은 자식 프로세스입니다. 페이지마다 Python 워커를 두면 언제든 죽일 수 있어 매력적이지만, 호출마다 인터프리터를 띄우고 런타임을 임포트한 뒤 픽셀 하나 읽기 전에 탐지와 인식 모델을 로드합니다. 아카이브 작업이 500페이지라면 그 시작세가 500번 돌고, 배포에는 네이티브 실행 파일 곁에 Python 환경이 붙습니다
HPDFCreateRapidOCRDLLOCREngine으로 스캔에서 검색 가능한 PDF 만들기
HotPDF는 HPDFCreateRapidOCRDLLOCREngine을 통해 인프로세스 RapidOCR를 돌립니다. 이 팩토리는 HPDFRapidOCRRecognition 유닛에 선언되어 있고, HotPDFRapidOCR.dll을 로드해 ONNX 탐지, 선택적 각도 분류, 인식 모델을 한 번 초기화한 뒤 IHPDFOCREngine을 반환합니다. 그 엔진은 다른 OCR 엔진과 똑같이 THotPDF.ApplyLoadedOCRTextLayer에 꽂힙니다. 문서가 각 페이지를 렌더링하면 DLL이 CPU 추론을 돌리고, 결과는 보이지 않는 Unicode 텍스트 레이어로 커밋됩니다. Python도 자식 프로세스도 없습니다. 어댑터는 Delphi, C++Builder, Windows FPC/Lazarus 빌드용으로 함께 실려 나갑니다
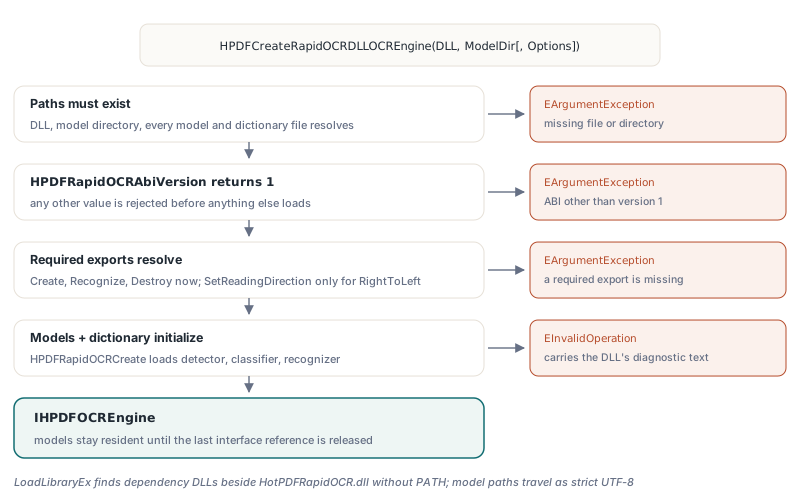
검증은 어떤 페이지도 만지기 전에 팩토리에서 일어납니다. 모든 모델과 사전 파일이 해석되어야 하고, HPDFRapidOCRAbiVersion은 1을 반환해야 하며, 필수 익스포트들이 HPDFRapidOCRCreate가 모델을 빌드하기 전에 존재해야 합니다. 설정 실수는 EArgumentException을 던지고, 로드를 거부하는 모델은 DLL 자체 진단을 실은 EInvalidOperation을 던집니다. 인식 모델과 맞지 않는 사전 같은 경우입니다
uses
  SysUtils, HPDFTypes, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // 모델은 여기서, 인식 마감 밖에서 로드됩니다.
  // THPDFRapidOCRDLLOptions.Default의 상대 이름은 모델
  // 디렉터리를 기준으로 해석됩니다
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models');
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // 빈 페이지 목록 = 모든 페이지, SkipPagesWithText는 기본적으로 True
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;THPDFRapidOCRDLLOptions.Default는 CPU 스레드 하나, 16,777,216픽셀 입력 한도, 인식 호출당 60,000 ms 마감과 함께 ch_PP-OCRv3_det_infer.onnx, ch_PP-OCRv3_rec_infer.onnx, ch_ppocr_mobile_v2.0_cls_infer.onnx, ppocr_keys_v1.txt를 가리킵니다. 다른 문자 체계는 THPDFRapidOCRDLLOptions.ForLanguage가 그 기본값을 유지한 채 아홉 프로파일 중 하나의 <profile>/recognition.onnx와 <profile>/dictionary.txt로 바꿔 꽂습니다. 번체 중국어와 키릴부터 아랍어, 데바나가리까지입니다. 엔진 하나는 한 언어를 읽으니 프로파일은 페이지별로, 혹은 문서별로 고르면 됩니다. 모델과 사전이 늘 한 쌍으로 다니는 이유는 HotPDF의 RapidOCR 다국어 모델과 CTC 사전이 다룹니다
엔진은 Info.EngineName에서 자신을 RapidOCR (native DLL)로 보고합니다. 이 문자열을 로그로 남기세요. 같은 서비스가 외부 Tesseract OCR 프로세스 어댑터나 내장 템플릿 매칭 OCR 엔진도 함께 돌린다면, 나쁜 페이지를 낸 인식기가 어느 쪽인지 가장 빨리 가려 주는 방법입니다
C ABI는 왜 int32_t와 UTF-8 바이트만 말할까?
HotPDFRapidOCR.dll 경계는 고정폭 정수, raw 포인터, 명시적 바이트 길이를 씁니다. Delphi, C++Builder, Free Pascal은 C 호출 규약 너머로 MSVC와 공유하는 것이 아무것도 없기 때문입니다. std::string이나 std::vector, C++ 예외는 하나의 컴파일러와 하나의 런타임 라이브러리에 속하는 메모리 레이아웃과 언와인딩 모델을 갖고, 그중 무엇이든 Pascal 코드로 넘어가면 끝은 깨진 스택이거나 엉뚱한 할당자가 해제한 힙 블록입니다
ABI 버전 1은 짧은 규칙 목록입니다. 모든 익스포트는 cdecl이고 int32_t 상태를 반환합니다. 1은 성공, 0은 실패입니다. 실패할 수 있는 모든 함수는 호출자 소유의 진단 버퍼와 바이트 단위 크기를 받고, DLL은 크기에 맞게 잘린 NUL 종료 UTF-8 메시지를 씁니다. DLL 안쪽에서 각 익스포트 본문은 catch (const std::exception &)와 catch (...)를 모두 갖춘 try로 감싸여, ONNX Runtime 오류나 OpenCV 어서션, 잘못된 사전이 상태 0 더하기 텍스트가 됩니다
| 익스포트 | 역할 | 어댑터가 해석하는 시점 |
|---|---|---|
HPDFRapidOCRAbiVersion | 1을 반환하며 다른 값은 거부됨 | DLL이 로드되자마자 |
HPDFRapidOCRCreate | 탐지, 선택적 분류, 인식 모델과 사전을 로드 | 팩토리 안에서 |
HPDFRapidOCRRecognize | 비트맵 하나를 실행하고 텍스트 행마다 콜백 하나를 내보냄 | 팩토리 안에서 |
HPDFRapidOCRDestroy | 모델 인스턴스를 해제 | 팩토리 안에서 |
HPDFRapidOCRSetReadingDirection | 선택적 오른쪽에서 왼쪽 행 순서 | RightToLeft가 설정됐을 때만 |
읽기 방향 익스포트는 의도적으로 느긋하게 해석됩니다. 그 익스포트 없이 빌드된 DLL도 왼쪽에서 오른쪽 요청은 모두 처리할 수 있어야 하기 때문입니다. 어댑터는 LoadLibraryEx와 DLL 자체 폴더와 기본 safe 디렉터리를 커버하는 검색 플래그로 라이브러리를 로드하므로, HotPDFRapidOCR.dll 곁에 둔 ONNX Runtime이나 OpenCV 의존성은 PATH를 건드리지 않고도 발견됩니다. 모델과 사전 경로는 UTF-8로 경계를 넘고, DLL은 와이드 문자 API로 파일을 열기 전에 strict 모드 MultiByteToWideChar로 변환합니다. C:\Users\Łukasz 아래의 모델 디렉터리나 키릴 사용자 이름도 정상적으로 열립니다
한 규칙은 헤더가 아니라 빌드 파일에 삽니다. DLL은 ONNX Runtime과 OpenCV를 정적으로 링크하고, CMake 프로젝트는 정적 릴리스 CRT(/MT)가 기본입니다. /MD로 빌드된 정적 라이브러리를 섞으면 운이 좋으면 링크 오류이고, 운이 나쁘면 서로 독립인 힙 두 개입니다. DLL과 같은 CRT 모드로 빌드된 라이브러리를 공급하세요
TBitmap과 텍스트 행 사이에서 무슨 일이 벌어질까?
HotPDF는 렌더링된 페이지의 독립적인 top-down BGR 사본을 DLL에 넘기고, DLL은 인식된 행마다 콜백 하나로 돌려줍니다. 그 콜백의 텍스트는 빌려온 것입니다. 포인터는 콜백이 반환할 때까지만 유효하므로 어댑터는 그 자리에서 복사합니다
Delphi에서는 사본을 pf24bit로 강제한 private TBitmap이 음수 biHeight로 GetDIBits를 불러 만듭니다. 그러면 4바이트 정렬로 패딩된 top-down 행이 생기고, 스트라이드는 명시적 인자로 DLL에 전달됩니다. FPC에서는 어댑터가 CreateIntfImage로 읽습니다. 호출자의 비트맵은 수정되지 않습니다. 크기 검사는 사본 할당 전에 돌습니다. 한 변 최대 32,767픽셀, 총합은 MaxPixels 이하인데 기본값은 16,777,216이고 67,108,864까지 올릴 수 있습니다
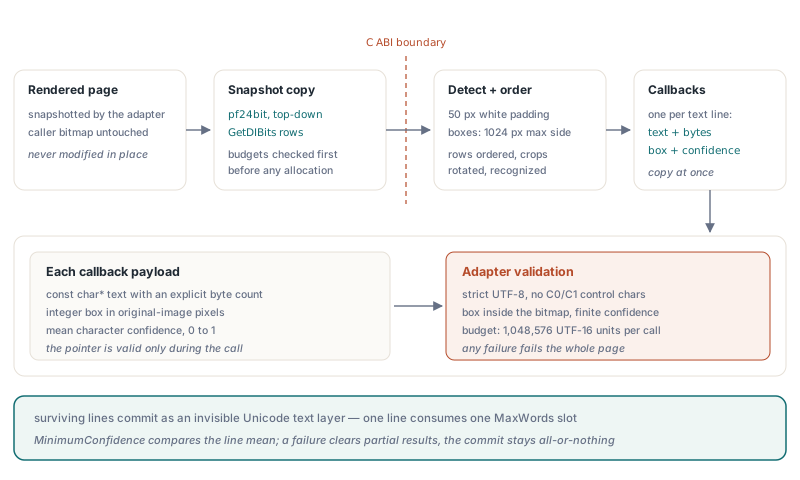
DLL 안에서 이미지는 50픽셀 흰 테두리를 입고, 텍스트 영역은 긴 변을 최대 1,024픽셀로 맞춰 탐지되며, 박스는 가로 행들로 정렬됩니다. 각도 분류기가 켜져 있으면 뒤집힌 점수가 0.9를 넘을 때만 크롭이 180도 돌려지는데, 이는 약한 예측이 짧은 단어를 뒤집는 일을 막습니다. 각 행은 const char*와 바이트 수, 원본 이미지 픽셀 좌표의 정수 박스, 평균 문자 신뢰도로 도착합니다. 어댑터가 받아들이는 것에 대한 기준은 엄격합니다
- UTF-8은
MB_ERR_INVALID_CHARS로 디코딩됩니다. 잘못된 바이트 시퀀스는 검색 가능한 레이어에 치환 문자를 심는 대신 그 페이지를 실패시킵니다 - C0과 C1 제어 문자는 거부되고, 공백뿐인 행은 건너뜁니다
- 박스는 비트맵 안에 있어야 하고, 신뢰도는 0부터 1 사이의 유한한 값이어야 합니다
- 텍스트는 요청의
MaxTextCodeUnits에 집계되며 호출당 하드 천장은 1,048,576 UTF-16 단위입니다. 기본 다국어 평면 밖의 문자는 두 단위입니다 - 콜백 안의 Pascal 예외는 그 자리에서 잡혀 저장되고 0 반환으로 바뀌며, 이는 DLL을 멈추게 합니다. 저장된 메시지는
Info.Diagnostic이 됩니다
출력을 튜닝할 때 두 가지 세부가 중요합니다. 단위는 단어가 아니라 행입니다. 행마다 MaxWords 슬롯 하나를 쓰고, Info.AcceptedWordCount와 Info.DroppedWordCount는 행을 세며, 검색 히트는 행 박스 전체를 하이라이트합니다. 그리고 MinimumConfidence는 행의 평균 문자 신뢰도와 비교되므로, 깨끗한 스무 글자 사이의 흐린 글자 하나가 행을 가라앉히는 일은 드뭅니다. 기준을 0.7이나 0.8로 올리면 사라지는 것은 행 전체지 문자 하나가 아닙니다. 빈 페이지는 0행으로 성공하고, 실패는 부분 결과를 모두 버려 다중 페이지 커밋이 all-or-nothing을 유지합니다
엔진 하나, 모델 사본 하나, 한 번에 한 호출
각 RapidOCR DLL 엔진은 자기 수명 내내 정확히 하나의 모델 인스턴스를 소유하고, 그 엔진의 Recognize 호출은 임계 영역으로 직렬화됩니다. IHPDFOCREngine 참조를 쥐고 있는 것이 모델을 메모리에 유지하는 장치이므로, 배치 작업은 엔진을 한 번 만들어 모든 문서에 재사용해야 합니다
procedure OcrBatch(const Files: TStrings; const OutputDir: string);
var
  Models: THPDFRapidOCRDLLOptions;
  Engine: IHPDFOCREngine;
  Doc: THotPDF;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
  I: Integer;
begin
  Models := THPDFRapidOCRDLLOptions.ForLanguage('ru-RU');
  Models.UseAngleClassifier := False;    // 바로 선 스캔: 분류기 모델 로드 안 함
  Models.Threads := 4;                   // 1..64, 활성 프로세서 수로 클램프
  Models.TimeoutMilliseconds := 120000;  // Recognize 호출당, 협력적
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Options := THPDFOCRTextLayerOptions.Default;
  for I := 0 to Files.Count - 1 do
  begin
    Doc := THotPDF.Create(nil);
    try
      Doc.AutoLaunch := False;
      if (Doc.LoadFromFile(Files[I]) > 0) and
        Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
        Doc.SaveLoadedDocument(IncludeTrailingPathDelimiter(OutputDir) +
          ExtractFileName(Files[I]))
      else
        Writeln(Files[I], ': ', string(Info.Diagnostic));
    finally
      Doc.Free;
    end;
  end;
end; // 마지막 참조 해제: 모델 파괴, 이후 DLL 언로드Threads는 엔진 안 모든 ONNX 세션의 intra-op와 inter-op 스레드 수를 함께 설정하고, DLL은 그 값을 활성 프로세서 수로 클램프합니다. 하나의 엔진을 공유하는 두 스레드는 추론을 병렬로 돌리지 못하고, 둘째는 기다립니다. 그 대기는 맹목적인 EnterCriticalSection이 아닙니다. 어댑터는 TryEnterCriticalSection으로 락을 시도하고, 시도 사이에 25 ms를 자며, 매번 취소 토큰과 마감을 확인하므로 대기 중인 요청도 여전히 취소할 수 있습니다
마감 시계는 락이 잡히기 전, Recognize에 진입하는 순간 시작됩니다. 다른 페이지 뒤에서 대기한 시간도 TimeoutMilliseconds에 집계됩니다. 하나의 엔진에 워커 스레드 넷과 60초 마감이라면 넷째 페이지는 모델에 닿기도 전에 타임아웃될 수 있습니다. 대신 워커마다 자기 엔진을 주세요. 엔진당 모델 사본 하나가 메모리에 더 얹히는 대신, 예측 가능한 타임아웃과 진짜 병렬성을 삽니다. 엔진 하나를 공유하는 게 맞는 경우는 요청이 거의 대기하지 않을 만큼 드문 때뿐입니다
네이티브 OCR 호출은 왜 추론 중간에 죽일 수 없을까?
네이티브 RapidOCR 호출은 추론 도중에 죽일 수 없습니다. 호출은 우리 스레드 위, 우리 프로세스 안에서 돌고, 실행 중인 Run에 중단 API를 갖지 않는 ONNX Runtime 세션의 한가운데 있기 때문입니다. DLL 어댑터의 취소는 협력적입니다. DLL은 탐지 전후, 크롭마다 분류 후, 인식된 행마다 abort 콜백을 부르고, 콜백이 0을 반환하는 첫 체크포인트에서 멈춥니다. 이미 시작된 Run 하나는 먼저 끝까지 돕니다
강제 옵션들은 기다리는 것보다 나쁩니다. TerminateThread는 CRT 힙 락과 ONNX Runtime의 스레드 풀, OpenCV 상태를 당시 그대로의 조건으로 남깁니다. 호출이 아직 실행 중일 때 FreeLibrary를 부르면 스택 위에 있는 코드를 언맵합니다. 어느 쪽도 안전하게 만들 수 없으므로 어댑터는 시도조차 하지 않습니다. 만료된 마감은 타임아웃 진단을 실은 otlsEngineError로, 취소된 토큰은 otlsCancelled로 돌아옵니다
// Token은 호출자가 만들어 UI 스레드와 공유하며,
// 사용자가 Stop을 누르면 UI 스레드가 Token.Cancel을 부릅니다
function OcrWithStop(Doc: THotPDF; const Engine: IHPDFOCREngine;
  Token: THPDFCancellationToken): Boolean;
var
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Options := THPDFOCRTextLayerOptions.Default;
  Options.CancellationToken := Token;
  Result := Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info);
  if not Result then
    case Info.Status of
      otlsCancelled:
        // 다음 단계나 행 체크포인트에서 정지, 문서는 그대로
        Writeln('Cancelled');
      otlsEngineError:
        // 협력적 마감 만료와 네이티브 진단을 포함
        Writeln('Engine: ', string(Info.Diagnostic));
      otlsBudgetExceeded:
        // Options의 페이지, 픽셀, 단어, 콘텐츠 한도에 도달
        Writeln('Budget: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
이것이 프로세스 어댑터와 인프로세스 DLL 사이의 실제 트레이드오프이며, 어느 쪽도 모든 행에서 이기지 못합니다
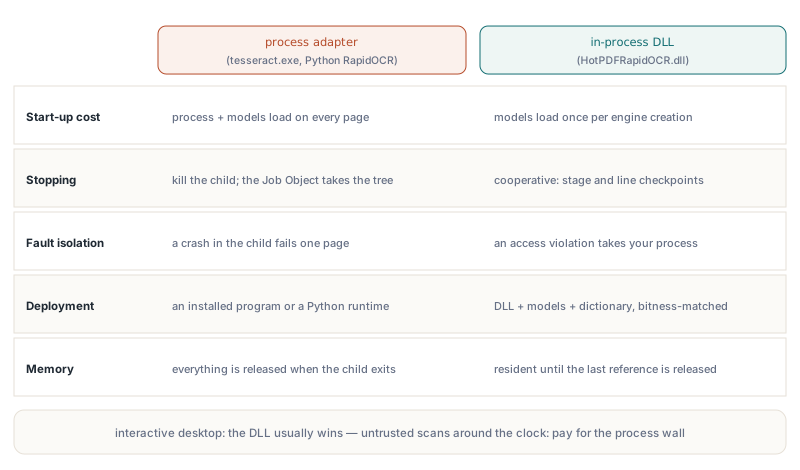
- 시작 비용: Tesseract와 Python RapidOCR 어댑터는 페이지마다 프로세스를 띄우고 모델을 로드합니다. DLL은 엔진당 모델을 한 번 로드합니다
- 정지: 자식 프로세스는 그냥 종료할 수 있고 Python 워커는 kill-on-close 잡 오브젝트 안에서 돌아 프로세스 트리 전체가 따라갑니다. DLL은 단계와 행 체크포인트에서 멈춥니다
- 고장 격리:
tesseract.exe의 크래시는 한 페이지의 실패입니다. DLL 안의 access violation은 우리 프로세스를 끌고 내려갑니다 - 배포: 프로세스 어댑터는 설치된 프로그램이나 Python 환경이 필요합니다. DLL은 자기 자신과 모델, 사전이 응용 프로그램의 비트니스에 맞기만 하면 됩니다
- 메모리: 프로세스 어댑터는 자식이 끝나면 모든 것을 해제합니다. DLL 엔진은 마지막 인터페이스 참조가 사라질 때까지 모델을 상주시킵니다
한 번에 한 페이지씩 OCR하고 추론 단계 하나 안에 돌아오는 반응성 좋은 Stop 버튼이 필요한 인터랙티브 데스크톱 응용 프로그램이라면 DLL을 고르세요. 신뢰할 수 없는 스캔을 밤낮으로 삼키는 서버라면 페이지당 시작 비용을 지불하고 프로세스 경계를 유지하세요. 인식기를 크래시시키는 조작된 이미지는 한 페이지의 값이어야 하고, 자식 프로세스라면 실제로 그렇습니다
HotPDFRapidOCR.dll 빌드와 모델 고르기
HotPDFRapidOCR.dll은 Native/RapidOCR의 C++ 소스를 MSVC, C++17, Windows SDK, CMake 3.20 이상으로 빌드합니다. tools/Build-HotPDFRapidOCR.ps1 헬퍼는 네이티브 소스와 ONNX Runtime, OpenCV 디렉터리에 -Platform Win32나 Win64를 받아 결과를 Lib/Native/RapidOCR/<Platform>/에 씁니다. 둘 다 배포한다면 둘 다 빌드하세요. 32비트 Delphi 응용 프로그램은 64비트 DLL을 로드할 수 없고, 공급하는 정적 라이브러리도 CRT 모드뿐 아니라 대상 아키텍처까지 맞아야 합니다
모델에는 자체 호환성 규칙이 있습니다. 탐지기는 DB 텍스트 탐지기입니다. 인식기는 NCHW 레이아웃의 입력 높이가 32나 48로 고정된 CTC 모델을 받고, 모델이 동적 높이라고 선언하면 48을 씁니다. 모델 포맷은 정적 링크된 ONNX Runtime이 이해하는 것이어야 하며, PP-OCRv5 같은 더 새 익스포트는 더 새 런타임을 요구할 수 있고 읽을 수 없는 모델은 진단과 함께 초기화에 실패합니다. tools/Install-RapidOCRModels.ps1은 고정된 SHA256 해시로 검증된 PP-OCRv3와 PP-OCRv4 팩을 설치하며, Default가 기대하는 파일 이름 아래 공유 탐지기와 분류기를 놓습니다. 런타임 빌드까지 직접 관리하지 않는다면 이 팩에 머무세요
사전은 BOM 없는 UTF-8이고, 모델의 문자 순서 그대로여야 하며, 엔트리 수가 모델의 출력 클래스와 맞아야 합니다. CRLF 행 끝은 괜찮습니다. 모델이 자체 문자 목록을 메타데이터로 내장하면 모델 초기화가 모든 엔트리와 그 위치를 사전 파일과 비교하므로, 길이만 맞는 사전은 여전히 실패합니다. DLL은 빠진 모델을 다운로드하지 않습니다
HotPDF는 네이티브 RapidOCR 어댑터를 프로세스 기반 OCR 어댑터들, 그것들에 페이지를 먹이는 페이지 렌더러, 보이지 않는 Unicode 텍스트 레이어 라이터와 함께 Delphi와 C++Builder용 네이티브 VCL 컴포넌트 하나 안에 묶어 실어 나릅니다. Python이 깔리지 않은 기계에서도 검색 가능한 PDF를 내야 하는 캡처와 아카이빙 소프트웨어에게 HotPDF Delphi PDF component는 배포할 것을 DLL과 모델 파일만 남깁니다