키릴 모델을 로드했는데 중국어 문자 사전을 그대로 읽는 인식기를 거친 러시아어 송장은, 형태가 완벽하게 정상인 한자 행들로 돌아옵니다. 모든 행은 UTF-8로도 멀쩡하고 검색 가능한 텍스트 레이어에도 자리 잡지만, 페이지에 인쇄된 어떤 단어로 검색해도 아무것도 나오지 않습니다. 모델은 제 소임을 다한 상태입니다. CTC 인식기는 문자가 아니라 클래스 번호만 출력하고, 클래스 1,204를 글리프로 사상하는 존재는 사전 파일 하나뿐입니다
관련 실패 세 가지가 바로 곁에 붙어 있습니다. 모든 행이 마지막 문자를 잃거나, 영어 텍스트가 단어 간격 없이 도착하거나, 아랍어 텍스트 박스가 왼쪽에서 오른쪽 순서로 돌아오는 것입니다. 하나하나가 사전 규칙, 루프 경계, 정렬 순서에서 비롯되며, 어느 것이나 거의 맞게 만들기 쉽습니다. 네 가지 모두 같은 지점에서 시작합니다. 언어 태그를 모델과 사전으로 바꾸는 그 단계입니다
HotPDF의 RapidOCR 언어 프리셋: 하나의 태그, 하나의 고정 쌍
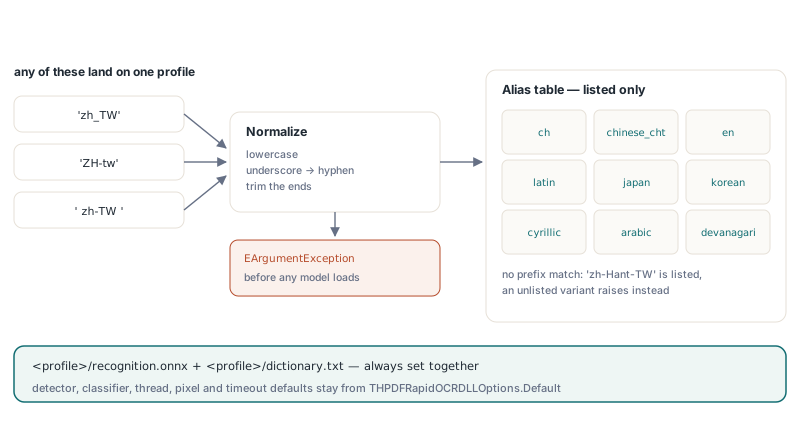
HotPDF에서 THPDFRapidOCRDLLOptions.ForLanguage는 언어 태그를 모델 디렉터리 아래의 <profile>/recognition.onnx와 <profile>/dictionary.txt를 가리키는 옵션으로 바꿉니다. 나머지는 모두 THPDFRapidOCRDLLOptions.Default에서 옵니다. 공유 탐지기, 선택적 각도 분류기, 스레드 하나, 요청당 16,777,216픽셀 예산, 60초 타임아웃이 그것입니다. 태그는 소문자로 바꾸고 밑줄은 하이픈으로 바꾸며 주변 공백은 잘라내므로, 'zh_TW', 'ZH-tw', ' zh-tw '는 모두 같은 프로파일로 해석됩니다
매치는 접두 매치가 아니라 명시적인 별칭 목록에 대해 이뤄집니다. 'zh-Hant-TW'와 'zh-MO'는 목록에 있으니 받아들여지고, 'pt-AO'는 없으므로 ForLanguage가 어떤 파일도 열기 전에 EArgumentException을 던집니다. 이 엄격함은 의도된 것입니다. 접두 규칙을 두면 'zh-Hant-SG'나 미래의 어떤 태그든 앞 두 글자를 공유하는 프로파일로 조용히 보내지는데, 중국어는 앞 두 글자만으로 문자 체계를 알 수 없습니다
| 프로파일 | 언어 | 예시 태그 | 행 안의 박스 순서 |
|---|---|---|---|
ch | 간체 중국어와 영어 | zh, zh-CN, zh-Hans, chi_sim | 왼쪽에서 오른쪽 |
chinese_cht | 번체 중국어 | zh-TW, zh-HK, zh-Hant, chi_tra | 왼쪽에서 오른쪽 |
en | 영어 | en, en-US, en-GB, eng | 왼쪽에서 오른쪽 |
latin | 프랑스어, 독일어, 스페인어, 포르투갈어, 이탈리아어, 네덜란드어, 튀르키예어 | fr, de, es-419, pt-BR, tr | 왼쪽에서 오른쪽 |
japan | 일본어 | ja, ja-JP, jpn | 왼쪽에서 오른쪽 |
korean | 한국어 | ko, ko-KR, kor | 왼쪽에서 오른쪽 |
cyrillic | 러시아어, 우크라이나어, 불가리아어, 벨라루스어 | ru, ru-RU, uk, bg | 왼쪽에서 오른쪽 |
arabic | 아랍어, 페르시아어, 우르두어 | ar, ar-SA, fa, ur | 오른쪽에서 왼쪽 |
devanagari | 힌디어, 마라티어, 네팔어 | hi, mr, ne | 왼쪽에서 오른쪽 |
어댑터는 아무것도 다운로드하지 않습니다. 모델 파일은 함께 실려 나가는 헬퍼로 한 번만 공급하면 됩니다. 예컨대 tools/Install-RapidOCRModels.ps1 -Destination C:/OCR/models -Language ch,chinese_cht,cyrillic처럼, 아홉 프로파일 전부라면 -Language All을 쓰면 됩니다. 헬퍼는 공유 탐지기와 분류기를 Default가 기대하는 루트 파일 이름에 놓고 각 프로파일은 제 폴더에 넣습니다. 엔진 생성, DLL 경계, 스레딩은 인프로세스 RapidOCR DLL에 관한 글이 다룹니다. 파일만 제자리에 있으면 간체 중국어 스캔은 이렇게 검색 가능해집니다
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

procedure MakeChineseScanSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Models: THPDFRapidOCRDLLOptions;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // ch/recognition.onnx + ch/dictionary.txt, 공유 탐지기와 분류기
  Models := THPDFRapidOCRDLLOptions.ForLanguage('zh-CN');
  // 모델은 여기서 로드, 엔진은 문서들에 걸쳐 재사용
  Engine := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Layer := THPDFOCRTextLayerOptions.Default;  // 300 DPI, MinimumConfidence 0.5
    // 빈 페이지 목록 = 모든 페이지, SkipPagesWithText는 텍스트 있는 페이지를 그대로 둠
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Layer, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' lines, ', Info.UniqueScalarCount, ' distinct characters');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
그 출력의 두 숫자는 주의해서 읽어야 합니다. 네이티브 파이프라인은 탐지된 텍스트 행마다 결과 하나를 보고하므로 여기서 AcceptedWordCount는 행을 세고, MinimumConfidence는 행 전체의 평균 문자 신뢰도와 비교됩니다. 평균 0.45짜리 행은 통째로 버려집니다. UniqueScalarCount는 텍스트 레이어가 폰트와 ToUnicode 테이블에 사상해야 했던 서로 다른 Unicode 스칼라의 개수입니다. 중국어 본문 페이지라면 이 수치가 라틴 페이지 필요량 몇십 개를 훨씬 넘어야 정상이고, 중국어 스캔에서 라틴 영역의 낮은 수치가 나오면 대개 잘못된 프로파일이 로드된 신호입니다
인식 모델만 바꾸면 왜 엉터리가 나올까?
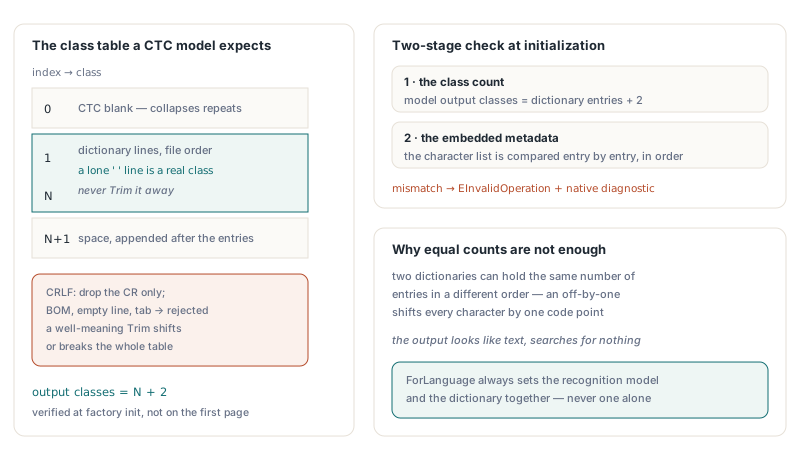
모델과 사전은 하나의 룩업 테이블의 두 반쪽이고, 인덱스가 무슨 뜻인지 아는 쪽은 사전뿐이기 때문입니다. RecognitionModel을 cyrillic/recognition.onnx로 가리키되 CharacterDictionary는 중국어 파일을 가리킨 채로 두면, 모델은 합법적인 키릴 인덱스를 내보내고 옛 사전이 그것을 무작위 한자로 번역합니다. ForLanguage는 두 필드를 항상 함께 설정합니다. 손으로 만든 옵션도 같은 규칙을 따라야 합니다. 하나만 바꾸고 다른 하나를 두지 마세요
사전 크기를 모델 출력 폭과 비교하는 자명한 안전 검사는 필요하지만 여전히 부족합니다. 두 사전은 같은 개수의 엔트리를 다른 순서로 담을 수 있고, 한 칸 어긋나면 모든 문자가 한 자리씩 밀립니다. 그래서 HotPDF RapidOCR DLL은 팩토리가 인식기를 초기화하는 동안 두 번 검사합니다. 모델의 출력 클래스 수는 사전 엔트리 더하기 2와 같아야 합니다. 이어서 ONNX 파일이 character 메타데이터 목록을 내장하고 있으면 각 사전 행을 순서대로 그것과 비교합니다. 어느 쪽이든 어긋나면 HPDFCreateRapidOCRDLLOCREngine가 네이티브 진단을 담아 EInvalidOperation을 던지므로, 오류는 고객 아카이브가 아니라 기동 시점에 드러납니다
"더하기 2"는 클래스 배치에서 나옵니다. 클래스 0은 CTC blank이고, 클래스 1부터 N까지는 파일 순서의 사전 행들이며, 마지막 클래스는 공백입니다. 일부 사전은 자체 공백 엔트리 하나를 더 갖고 있는데, 그 행은 있는 그대로 살아남아야 합니다. 선의의 Trim이 실제 피해를 입히는 지점이 바로 여기입니다. 공백 엔트리를 빈 문자열로 만들어 테이블을 밀거나 부러뜨립니다. DLL은 뒤따르는 캐리지 리턴을 잘라 CRLF 파일도 로드하게 하고, UTF-8 바이트 오더 마크, 빈 행, 탭이나 엉뚱한 캐리지 리턴을 담은 엔트리는 거부합니다
직접 사전을 관리한다면 빌드나 배포 스크립트에 사전 점검을 넣어 두는 것이 엔진보다 먼저 이런 문제를 잡아 줍니다. 아래 함수는 위 규칙들을 그대로 반영해 쓴, 여러분 자신의 코드입니다
// 여러분 자신의 헬퍼, HotPDF API가 아님: CTC 인식기가 기대하는
// 클래스 테이블을 만들고 DLL이 거부하는 사전 결함을 거부합니다
uses
  SysUtils, IOUtils;

function BuildCTCClassTable(const FileName: string): TArray<string>;
var
  Text, Entry: string;
  Lines: TArray<string>;
  I, Last: Integer;
begin
  Text := TEncoding.UTF8.GetString(TFile.ReadAllBytes(FileName));
  if (Text <> '') and (Text[1] = #$FEFF) then
    raise EArgumentException.Create('Dictionary must be UTF-8 without a BOM');
  Lines := Text.Split([#10]);
  Last := High(Lines);
  if (Last >= 0) and (Lines[Last] = '') then
    Dec(Last);                                   // 파일 끝의 개행
  if Last < 0 then
    raise EArgumentException.Create('Dictionary is empty');
  SetLength(Result, Last + 3);
  Result[0] := '';                               // 클래스 0: CTC blank
  for I := 0 to Last do
  begin
    Entry := Lines[I];
    if (Entry <> '') and (Entry[Length(Entry)] = #13) then
      SetLength(Entry, Length(Entry) - 1);       // CRLF: CR만 제거
    if (Entry = '') or (Pos(#9, Entry) > 0) or (Pos(#13, Entry) > 0) then
      raise EArgumentException.CreateFmt('Invalid dictionary line %d', [I + 1]);
    Result[I + 1] := Entry;                      // 절대 Trim 금지: ' '도 클래스
  end;
  Result[Last + 2] := ' ';                       // 마지막 클래스: 공백
  // Length(Result)는 모델 출력 클래스 수와 같아야 합니다
end;
greedy CTC 디코딩과 세 가지 경계 함정
greedy CTC 디코딩은 매 시간 단계에서 가장 점수 높은 클래스를 골라 연속된 반복을 한 문자로 접고 blank는 버립니다. 진짜 겹친 글자가 살아남는 것은 blank 덕분입니다. 인식 모델은 텍스트 행을 좁은 세로 조각들의 나열로 읽고, 조각마다 모든 클래스의 확률을 출력합니다. AA中을 담은 행은 A A blank A 中 space라는 argmax 시퀀스를 낼 수 있습니다. 앞의 두 A 단계는 하나로 접히고, blank가 다음 A와 갈라 놓으며, 출력은 뒤 공백까지 그대로 AA中 이 됩니다. blank 규칙이 없다면 book과 bok이 똑같이 디코딩될 겁니다
디코더가 짧으면 경계를 하나씩 잘못 잡기 쉽고, 실수마다 고유한 증상을 남깁니다. 안쪽 argmax 루프를 한 클래스 일찍 끝내면 공백 클래스는 이길 일이 없어 영어나 라틴 행이 전부 한 긴 단어로 돌아오고 구문 검색이 죽습니다. 바깥쪽 루프를 한 시간 단계 일찍 끝내면 모든 행의 마지막 문자가 사라지는데, 두 글자 라벨에서라면 텍스트의 절반입니다. blank가 반복 가드를 리셋하게 두지 않으면 겹친 문자가 접힙니다. hello의 ll, 혹은 겹친 谢谢가 그렇습니다. 커스텀 파이프라인용 디코더를 직접 만든다면 이 세 사례가 알찬 테스트 세트가 됩니다. HotPDF 디코더는 마지막 클래스와 마지막 단계를 커버하고, blank로 갈라진 반복은 유지하며, 유한하지 않거나 0과 1 범위를 벗어나는 점수, 사전과 어긋나는 클래스 수는 거부합니다
// 여러분 파이프라인용 설명, HotPDF API가 아님: 경계가 올바른
// greedy CTC 디코딩. Scores는 Steps * Classes 크기의
// 확률을 담고, 시간 단계마다 한 행입니다
function GreedyCTCDecode(const Scores: array of Single;
  Steps, Classes: Integer; const Characters: array of string): string;
var
  Step, C, Best, Previous: Integer;
  BestScore: Single;
begin
  if (Classes < 3) or (Length(Characters) <> Classes) or
    (Length(Scores) <> Steps * Classes) then
    raise EArgumentException.Create('Model output does not match the dictionary');
  Result := '';
  Previous := 0;                            // 클래스 0은 CTC blank
  for Step := 0 to Steps - 1 do             // 마지막 시간 단계까지 포함
  begin
    Best := 0;
    BestScore := Scores[Step * Classes];
    for C := 1 to Classes - 1 do            // 마지막 클래스(공백)까지 포함
      if Scores[Step * Classes + C] > BestScore then
      begin
        Best := C;
        BestScore := Scores[Step * Classes + C];
      end;
    if (Best <> 0) and (Best <> Previous) then
      Result := Result + Characters[Best];
    Previous := Best;                       // blank가 반복 가드를 리셋
  end;
end;
언어 모델을 갖춘 beam search는 greedy 디코딩이 틀리는 모호한 조각 일부를 해소해 주지만, 속도 비용이 크고 버전을 맞춰야 하는 파일 세트가 하나 더 늘어납니다. 300 DPI로 렌더링한 인쇄 문서라면 greedy 디코딩이 맞는 기본값이고, 모델이 보지 못하는 것을 디코더가 보상할 자리는 아닙니다. 문자 치환 테이블도 마찬가지입니다. 모델이 악센트 문자를 밑글자로 읽어버렸을 때 치환 테이블로 출력을 고치면 한 언어는 살리고 다른 언어를 부러뜨립니다. 검색 가능한 레이어의 잘못된 문자는 빠진 문자보다 더 나쁩니다. 검색이 "문서 없음"이 아니라 "잘못된 문서"를 찾아 주기 때문입니다. 그래서 인식된 텍스트는 모델이 내 놓은 그대로 PDF에 들어갑니다
오른쪽에서 왼쪽 아랍어는 텍스트 행을 어떻게 정렬할까?
DLL은 탐지된 텍스트 박스를 위에서 아래로 정렬하고, 작은 박스 높이의 절반 이상 수직으로 겹치는 박스들을 한 행으로 묶으며, 각 행은 왼쪽에서 오른쪽으로, RightToLeft가 설정되면 오른쪽에서 왼쪽으로 배열합니다. 인식된 행 안의 문자가 뒤집히는 일은 없습니다. 행 묶음이 중요한 이유는 탐지기가 하나의 눈에 보이는 행을 여러 박스로 쪼개는 일이 잦기 때문입니다. 넓은 간격으로 갈라진 라벨과 값이 대표적이고, 순수한 top 좌표 정렬이라면 꼭대기가 한두 픽셀 어긋난 것만으로 다음 행과 섞여 버립니다
아랍어 프로파일만 ForLanguage가 RightToLeft := True를 설정하는데, 이는 DLL이 각 행을 박스의 오른쪽 모서리 기준으로, 오른쪽 여백에서 시작해 배열하게 만듭니다. 효과는 그게 전부입니다. 모델이 행에 대해 돌려주는 텍스트는 이미 Unicode 논리 순서, 즉 아랍어 독자가 읽고 타이핑하는 순서이며, PDF 텍스트 추출과 검색이 기대하는 순서도 바로 그것입니다. Delphi 디버거에서 "제대로 보이게" 문자열을 뒤집으면 검색과 복사 붙여넣기, 스크린 리더가 모두 깨집니다. 양방향 표시와 글리프 셰이핑은 PDF 뷰어의 몫입니다
하나의 엔진이 하나의 언어 프로파일을 맡고, 자동 문자 체계 탐지는 없습니다. 문자 체계를 섞은 문서는 프로파일마다 엔진을 하나씩 두고 각자 자기 페이지에 적용합니다. ApplyLoadedOCRTextLayer는 명시적인 페이지 목록을 받고 호출마다 독립 트랜잭션으로 커밋하므로, 아랍어 페이지의 실패는 그 호출만 롤백할 뿐 이미 기록된 중국어 레이어를 건드리지 않습니다
uses
  SysUtils, HPDFDoc, HPDFRapidOCRRecognition;

function CreateRapidEngine(const Tag: string): IHPDFOCREngine;
var
  Models: THPDFRapidOCRDLLOptions;
begin
  // 목록에 없는 태그는 모델 로드 전에 EArgumentException을 던짐
  Models := THPDFRapidOCRDLLOptions.ForLanguage(Tag);
  Models.MaxPixels := 33554432;          // 300 DPI A3 페이지를 위한 여유
  Result := HPDFCreateRapidOCRDLLOCREngine(
    'C:\OCR\Win64\HotPDFRapidOCR.dll', 'C:\OCR\models', Models);
end;

procedure OCRMixedArchive(Doc: THotPDF);
var
  Chinese, Arabic: IHPDFOCREngine;
  Layer: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  Chinese := CreateRapidEngine('zh-TW');  // chinese_cht 프로파일
  Arabic := CreateRapidEngine('ar-SA');   // arabic 프로파일, RightToLeft = True
  Layer := THPDFOCRTextLayerOptions.Default;
  if not Doc.ApplyLoadedOCRTextLayer([0, 1, 2], Chinese, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
  if not Doc.ApplyLoadedOCRTextLayer([3], Arabic, Layer, Info) then
    raise Exception.Create(string(Info.Diagnostic));
end;
MaxPixels 행에는 이유가 있습니다. 요청당 기본 예산 16,777,216픽셀은 300 DPI의 A4와 US Letter를 넉넉히 커버합니다. 300 DPI A3 한 장은 가로세로 약 3508×4961픽셀, 1,740만 픽셀 남짓이라 이 요청은 거부되고 Info.Diagnostic이 잘못된 요청이나 픽셀 예산을 보고합니다. MaxPixels를 67,108,864 천장까지 올리거나, 큰 포맷에는 THPDFOCRTextLayerOptions.DPI를 낮추세요. 오른쪽에서 왼쪽 정렬은 DLL 익스포트 HPDFRapidOCRSetReadingDirection을 거치는데, 어댑터는 RightToLeft가 설정됐을 때만 이 심벌을 찾습니다. 그 익스포트가 없는 DLL 빌드라도 왼쪽에서 오른쪽 프로파일은 문제없이 서비스하고, 그 상태로 아랍어 엔진을 만들면 빠진 익스포트 이름을 적어 EArgumentException을 던집니다
고정된 모델 팩과 커스텀 쌍이 통과해야 할 검사
HotPDF RapidOCR DLL은 정적 빌드된 ONNX Runtime을 링크하므로, 그 런타임이 이해하는 ONNX 파일 포맷 버전까지만 읽고 그 이상은 읽지 못합니다. 최근 모델 익스포트는 더 새 포맷을 겨냥할 수 있는데, 그런 파일은 엔진 생성 시점에 네이티브 진단과 함께 거부됩니다. 각 언어 팩이 번들 런타임 아래에서 로드되어 클래스 검사를 통과하는 특정 인식기와 사전 한 쌍을 가리키는 이유이고, 팩이 결코 "최신"이 아닌 이유이기도 합니다
Install-RapidOCRModels.ps1은 디스크 위에서 이 쌍을 강제합니다. 매니페스트의 모든 파일은 SHA256 해시를 달고 있고, 해시가 다른 기존 파일이 있으면 설치가 멈추고 그 파일은 옮기거나 지우라고 제자리에 남습니다. 각 다운로드는 임시 이름으로 기록되고 해시가 맞는 것 확인 후에야 제자리로 이동합니다. 이는 사전 문제의 조용한 버전을 막습니다. 누군가 최신 recognition.onnx를 손으로 프로파일 폴더에 복사해 넣고, 클래스 수는 공교롭게 맞고, 첫 신호는 "눈에 보이는 단어를 검색하면 못 찾겠다"는 고객 불만이 되는 것이죠. -SkipClassifier로 설치했다면 옵션에서 UseAngleClassifier := False를 설정하세요. Default는 분류기 파일을 기대하고 엔진 생성이 그 존재를 검사합니다
인식기는 로드 시점에 모델의 입력 셰이프도 검사합니다. 높이가 32나 48픽셀로 고정된 NCHW float 입력, 혹은 48로 실행되는 동적 높이를 받습니다. 다른 고정 높이로 익스포트된 모델은 "Unsupported recognition model input or output shape" 메시지와 함께 엔진 생성에 실패합니다
아홉 프로파일 어느 것도 커버하지 않는 문자 체계라면 RecognitionModel과 CharacterDictionary를 여러분 파일로 가리킬 수 있고, 위의 모든 검사는 그대로 적용됩니다. 어긋난 쌍은 고객에게 도달하기 전에 테스트 실행의 엔진 생성 단계에서 실패합니다. RapidOCR 프로파일이 맞지 않는 페이지에는 검색 가능 PDF용 Tesseract 어댑터가 같은 ApplyLoadedOCRTextLayer 호출에 연결되고, 기계 인쇄된 ASCII 양식에는 내장 템플릿 매칭 OCR 엔진이 모델 파일 없이도 동작합니다
언어 프리셋, 네이티브 RapidOCR 어댑터, OCR 텍스트 레이어는 모두 Delphi, C++Builder, Windows FPC/Lazarus 프로젝트를 위한 HotPDF Delphi PDF Component에 포함되어 있습니다