어떤 분기가 바이트를 읽고, 처리하지 않기로 하고, 커서를 옮기지 않은 채 반환하면 파서는 망가진 PDF에서 멈춥니다. 호출자 루프는 진행도 멈출 이유도 보지 못해 영원히 돌아갑니다. HotPDF는 정확히 그 결함을 독립된 파서 세 개에서 출하했는데, 셋 다 50바이트 미만의 입력으로 도달 가능합니다
이것은 따로 이름 붙일 가치가 있는 DoS 부류입니다. 모두가 이미 막고 있는 그 부류와는 생김새가 다르기 때문입니다. 압축 해제도, 할당 증가도, 와치독을 건드릴 메모리 압박도 없습니다. 프로세스는 버퍼에 든 몇 바이트와 함께 단일 코어에서 CPU 100%로 가만히 앉아 있을 뿐입니다. 중첩 필터 증폭과 PDF 폭탄에 대해 읽고 디코드 예산을 추가했다면, 그 예산은 여기서 발화하지 않습니다. 디코딩되는 것도, 할당되는 것도 없기 때문입니다. 다른 실패, 다른 수정입니다
40바이트짜리 파일이 압축 해제 폭탄보다 더 비싼 이유
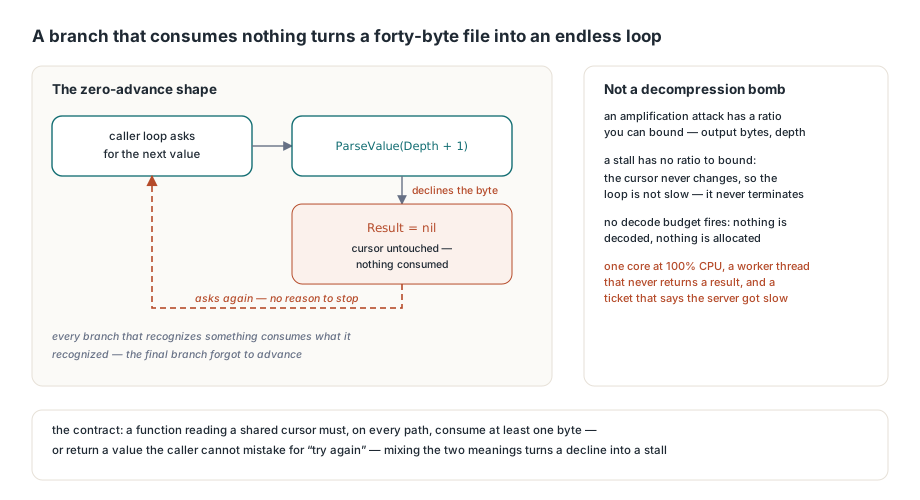
비용이 입력 크기와 전혀 무관하기 때문입니다. 증폭 공격에는 경계 지을 수 있는 비율이 있습니다. 출력 바이트를 상한으로 제한하고 재귀 깊이를 상한으로 제한하면 최악의 경우도 유한해집니다. 제로 전진 루프에는 경계 지을 비율이 없습니다. 루프 조건은 절대 변하지 않는 커서의 함수라서 느린 것이 아니라 종료되지 않는 것이며, 상류의 어떤 크기 기반 한계도 잡아내지 못합니다. 그 때문에 운영적으로도 유별나게 지저분합니다. 크래시는 스택을 주고, 메모리 부족은 로그 한 줄을 주지만, 멈춘 파서는 결과를 절대 돌려주지 않는 워커 스레드, 하류의 무엇도 시작을 알지 못해 타임아웃되지 않는 요청, 그리고 "화요일에 서버가 느려졌다"는 티켓을 줍니다. 구조적 원인은 언제나 같은 모양입니다. 토크나이저나 값 파서에는 현재 바이트를 키로 하는 분기 체인이 있습니다. 무언가를 인식하는 모든 분기는 인식한 것을 소비합니다. 그리고 마지막 분기, 또는 체인 앞의 가드가 아무도 가져가지 않은 바이트에 대해 반환하는데, 작성자는 이를 스캔 단계가 아니라 오류 경로로 여깁니다. 오류 경로는 반환합니다. 스캔 단계는 전진합니다. 한 함수가 둘 다여야 할 때 잊히는 쪽은 전진입니다
객체 파서: 누구도 소비하지 않은 구분자 두 개
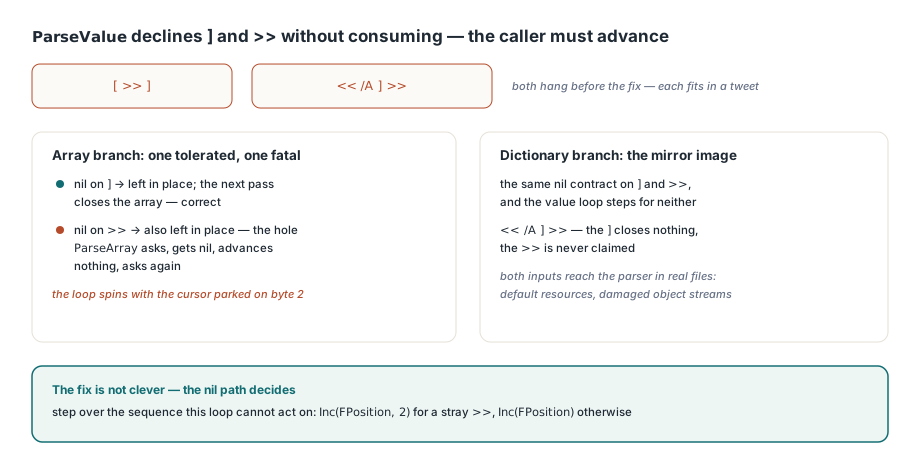
HPDFParser에서 THPDFSpanObjectParser.ParseValue 메서드는 두 바이트 시퀀스를 처음부터 곧장 거절합니다. ISO 32000-1 7.3절에 따르면 값은 ]나 >>로 시작할 수 없습니다. 그것들은 값을 여는 것이 아니라 컨테이너를 닫기 때문이며, 그래서 ParseValue는 둘 모두를 소비하지 않고 nil을 반환합니다. 그것이 올바른 계약이며, 전진의 모든 부담을 호출자에게 지웁니다. 배열 분기는 그 절반만 지켰습니다. nil 결과에서 ]를 확인해 다음 패스가 배열을 닫도록 제자리에 두고, 나머지는 전부 넘어갔습니다. 그런데 그 확인이 우연히도 떠돌이 >>도 제자리에 남기는 방식으로 작성되어 있었습니다. 그래서 [ >> ]은 멈춥니다. ParseArray가 값을 요청하고, nil을 얻고, 아무것도 전진하지 않고, 다시 요청하기 때문입니다. 딕셔너리 분기는 거울상 구멍을 지녔고, << /A ] >>도 같은 방식으로 멈춥니다. 두 입력 모두 파서에 도달할 만큼 유효하고 트윗에 들어갈 만큼 짧습니다
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // 수정 전에는 아래 두 호출 모두 결코 반환하지 않았습니다
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
수정은 영리하지 않습니다. 바로 그게 핵심입니다. nil 경로는 두 미소비 시퀀스 중 현재 루프가 처리할 수 있는 것을 명시적으로 정하고, 다른 쪽을 넘어가야 합니다
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValue는 ']'와 '>>' 둘 모두를 소비하지 않고 nil을 반환합니다.
  // ']'는 다음 패스에서 배열을 끝내지만, 배열 안의 떠돌이 '>>'는
  // 넘어가야 합니다. 그러지 않으면 파싱이 전진하지 않습니다
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;
여기서 주목할 게 하나 더 있습니다. THPDFSpanObjectParser.RecordError는 THPDFParserViewStatistics의 ErrorCount만 늘리고 아무것도 상한을 두지 않습니다. 파서는 중첩을 제한하도록 HPDFParserMaximumDepth를 64로 두지만, 오류 횟수에는 그에 맞는 상한이 없으며, 아무도 읽지 않는 카운터는 놓친 회로 차단기입니다. 전진을 복원해도 바이트마다 오류 하나를 내는 입력은 큰 객체를 전체 순회보다 조기 종료가 더 맞을 속도로 갉아먹습니다. 매 파싱 후 statistics record의 Valid를 확인하고, 큰 ErrorCount를 진단용 장식이 아니라 그 객체를 더 이상 믿지 말아야 할 이유로 취급하세요
CMap 토크나이저와 XFDF 리더의 같은 모양
HPDFCMapReader.NextToken은 폴백 분기에 동일한 결함을 지녔습니다. 함수는 TCMapTok을 반환하며 <, (, /는 전용 분기로 처리합니다. 나머지는 전부 "공백이나 구분자까지 읽기"로 떨어집니다. 시작 바이트 자체가 ISO 32000-1 7.2.2절 집합의 구분자일 때 그 루프는 0회 실행되고, 토큰은 빈 채로 돌아오며, 호출자는 같은 토큰을 다시 요청합니다. 거기에 떨어질 수 있는 여섯 문자 중 [만 bfrange 처리가 앞서 가로챘으므로, ToUnicode CMap 어디에서든 떠돌이 ), >, ], {, } 하나면 텍스트 추출을 멈추기에 충분했습니다
// 키워드 또는 숫자: 공백이나 구분자까지 읽음
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// 위 분기 중 어느 것도 가져가지 않는 구분자(떠돌이 ')', '>',
// '[', ']', '{', '}')는 P를 제자리에 두고 빈 키워드를
// 반환하므로 호출자는 같은 토큰을 영원히 요청하게 됩니다
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;
XFDF 쪽은 기원은 다르고 효과는 같은 변형이 있었습니다. HPDFXFDFXml.ParseElement은 P가 여는 <를 가리키는 상태에서 맨 위에 Result := P를 설정하고, 그 후에야 로컬 커서를 올리므로, 뒤따르는 모든 조기 종료는 Result를 먼저 덮어쓰지 않는 한 진입 위치를 반환합니다. XML 1.0 2.8절의 doctype 선언이나 <1a>처럼 파싱 가능한 태그 이름이 없는 다른 무엇이든 Result를 갱신하지 않는 종료를 타서, 자식 요소 루프는 넘겨준 그 위치를 그대로 받았습니다. 속성 루프에는 이런 게 세 개 더 있었습니다. ReadName, 공백 건너뛰기, = 처리가 모두 이름 문자도 공백도 =, >, /도 아닌 바이트를 거절했는데, 그중 어느 것도 그것을 소비하지 않았기 때문입니다. 이웃한 CDATA 수리는 가드를 추가하는 대신 책임을 옮긴 것이었습니다. XML 1.0 2.7절의 CDATA 섹션은 <로 시작하므로, 자식 루프는 예전에 그것을 ParseElement에 넘겼고, 파서는 섹션 콘텐츠에서 태그 이름을 읽었습니다. 자식 루프에서 IsCDATAStart로 인식하고 IsCDATAEnd까지 바이트를 텍스트 버퍼에 복사하는 것이 올바른 분담이며, 옛 건너뛰기도 마커가 !부터 세어 여덟 바이트인데 한 바이트 짧았습니다
데이터보다 오래 사는 선언된 개수
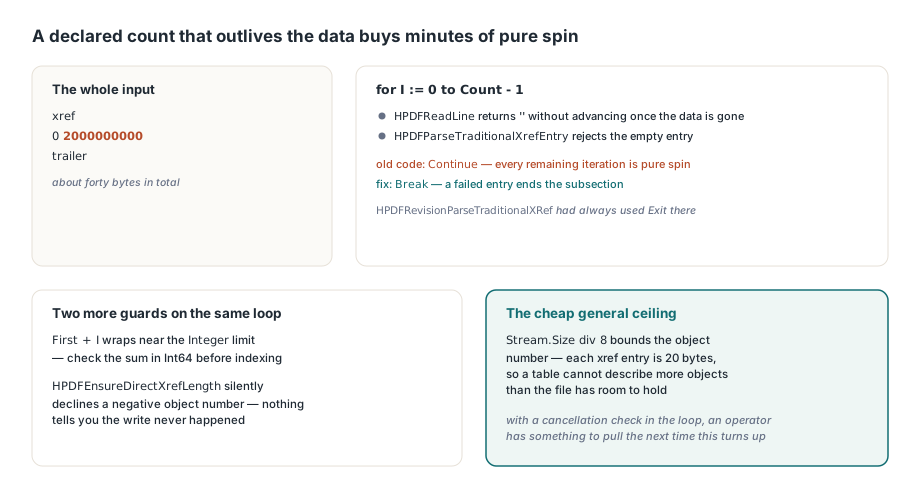
이후 릴리스에서 같은 패턴이 반대 방향으로 드러났는데, 그게 여러분의 코드에 존재할 가능성이 가장 높은 변형입니다. ISO 32000-1 7.5.4절의 크로스 레퍼런스 서브섹션 헤더는 first count 쌍이며, HotPDF의 전통적 xref 파서 둘 모두에서 for I := 0 to Count - 1 루프가 항목 파싱 실패 시 Break가 아니라 Continue를 썼습니다. 나쁜 줄 하나를 용납하는 것으로 읽힙니다. 실제로는 아닙니다. HPDFReadLine은 데이터가 바닥나면 전진하지 않고 빈 문자열을 반환하며, HPDFParseTraditionalXrefEntry는 빈 항목을 즉시 거절하므로, 선언된 개수의 남은 반복은 전부 순수 스핀입니다. 산술도 매정합니다. 헤더 xref\n0 2000000000\ntrailer에 최소 래퍼를 더하면 40바이트쯤 되고, 루프 어디에도 취소 확인이 없는 채 바쁜 코어를 수십 초 태웁니다. 단서는 같은 유닛 안에 있었습니다. HPDFRevisionParseTraditionalXRef는 그 위치에서 항상 Exit을 썼기 때문입니다. 두 함수가 같은 문법을 파싱하면서 실패한 항목이 서브섹션을 끝내는지에 대해 의견이 갈리면, 그중 하나는 수정을 받지 못한 포크입니다. 전통적 테이블과 스트림이 같은 객체를 기술하는 하이브리드 크로스 레퍼런스 처리에서 나타나는 것과 같은 시그니처입니다
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // 테이블보다 큰 선언 개수는 이 자리에서 읽을 데이터 없이
  // 스핀했을 것입니다
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // First는 서브섹션 헤더에서 오므로 Integer 한계 부근의
  // 선언된 시작점에서는 합이 래핑되고, 성장 헬퍼는
  // 음수 인덱스를 조용히 거절합니다
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... 항목을 기록 ...
end;
Break 뒤의 경계 두 개는 같은 수리에 속합니다. HPDFEnsureDirectXrefLength는 음수 객체 번호에 대해 배열 성장을 거절하면서 아무 말도 하지 않고, First + I는 Integer 한계 부근의 선언된 시작점에서 래핑되므로, 음수 인덱스가 아래 쓰기에 닿습니다. 객체 번호 상한 Stream.Size div 8은 저렴한 일반적 답입니다. 어떤 전통적 크로스 레퍼런스 테이블도 파일이 담을 공간보다 많은 객체를 기술할 수 없고, 그 반대를 주장하는 헤더는 존재하지 않는 파일을 기술하는 것이기 때문입니다. 손상된 테이블을 손수 복구한다면, 수작업으로 편집된 PDF 진단 및 복구 노트가 다루는 영역인 반대쪽에서도 같은 추론이 적용됩니다
멈춤 수정이 실제로 작동함을 어떻게 증명할까요?
옛 코드를 다시 읽는 것이 아니라 실행해서 증명합니다. 스톨은 수정을 계측 없이 이진 신호로 검증할 수 있는 몇 안 되는 결함 부류입니다. 프로세스가 반환하거나 반환하지 않거나 둘 중 하나이며, 제어 흐름에 대해 추론하는 것은 정확히 그 버그를 처음에 만든 기술이기 때문입니다. 그 절차는 베껴 쓸 가치가 있습니다. 변경된 유닛의 수정 전 리비전을 스크래치 디렉토리에 꺼내고, 유닛 검색 경로에서 그 디렉토리를 실제 라이브러리보다 앞에 두어 작은 probe 하나를 컴파일합니다: dcc32 -U<scratchdir>;<Lib> probe.dpr. 컴파일러는 먼저 찾은 것은 옛 소스로, 나머지는 현재 소스로 취하므로, probe 바이너리 하나가 나머지 라이브러리와 함께 옛 파서를 시험합니다. 타임아웃 아래에서 실행하세요. 40초면 넉넉하며, 종료 코드 124를 단언으로 취급하세요. 그다음 스크래치 디렉토리에서 유닛을 하나씩 빼고 다시 빌드합니다. 세 스톨 모두 이 방식으로 재현되었고 각각 특정 유닛에 귀속되었으며, 수정된 소스가 경로에 돌아오자 세 개 모두 반환했습니다. 유닛당 컴파일 한 번의 비용으로 말입니다
시도하기 전에 알 만한 함정이 두 개 있습니다. 유닛 검색 경로는 조용히 관대합니다. -U에 셸의 유닉스식 경로, 예컨대 $PWD를 주면 컴파일러는 그 디렉토리를 한마디도 없이 무시합니다. 즉 probe가 현재 소스로 컴파일되어 틀린 이유로 통과했다는 뜻입니다. 경로를 먼저 네이티브 Windows 형식으로 바꾸세요. 둘째, 스크래치 디렉토리는 include 파일을 담지 않으므로 HotPDF.inc용 -I<Lib>도 필요하며, 없으면 빌드가 경로 문제가 아니라 소스 문제처럼 보이는 방식으로 실패합니다. 그리고 이 방법이 주지 않는 것이 무엇인지 솔직해지세요. 특정 입력이 특정 빌드에서 멈추지 않게 되었다는 것을 확인할 뿐, 떠올리지 못한 입력에 대해서는 아무것도 말하지 않습니다. 제로 전진 결함은 페이징이나 모든 토크나이저의 모든 분기를 읽어서 발견되지, 사후에 작성된 회귀 테스트로는 발견되지 않습니다
여러분의 파서에서 무엇을 감사할까요?
재사용 가능한 규칙은 체크리스트 항목이 아니라 계약입니다. 공유 커서를 읽는 모든 함수는 실패 경로를 포함한 모든 경로에서 최소 한 바이트를 소비하거나, 호출자가 "다시 시도"로 오인할 수 없는 값을 반환해야 합니다. 두 의미를 단일 nil이나 단일 빈 토큰에 섞는 것이 거절을 스톨로 바꿉니다. 그래서 증상이 아니라 모양을 감사하세요. 종료가 다른 함수가 소유한 커서에 달린 루프를 모두 찾고, 그 함수가 현재 바이트를 거절하면 무슨 일이 일어나는지 물어보세요. "X까지 읽기"로 작성된 폴백 분기를 모두 찾고, 커서가 이미 X 위에 앉아 있을 때 무엇을 하는지 물어보세요. 파일에서 나온 개수로 경계 지어진 루프를 모두 찾고, 실패한 요소가 반복을 건너뛰는 대신 루프를 끝내게 하세요. 같은 문법이 두 곳에서 파싱되면 diff를 뜨세요. 하나는 받고 다른 하나는 받지 못한 수정이 있을 것이기 때문입니다. 그리고 호출자가 공급한 반복 횟수만큼 돌 수 있는 모든 루프 안에 취소 확인을 넣어, 다음에 이런 게 프로덕션에서 나타났을 때 운영자가 당길 무언가가 있게 하세요
여기서 설명한 파서들은 Delphi와 C++Builder용 최신 HotPDF Delphi Component에 출하되며, statistics record와 깊이 한계가 노출되어 여러분의 자체 강화가 그 위에 세울 수 있습니다