Microsoft Word나 Excel이 만든 PDF를 열어 페이지를 훑으면 아무런 이상이 없어 보입니다. Delphi 프로그램에 로드해 페이지 수를 다시 읽어도 숫자는 맞습니다. 그런데 암호화를 켠 채 다시 저장하면 저장 단계가 예외를 던지거나, 출력이 손상된 상호 참조 경고와 함께 열립니다. 파일은 한 번도 손상되지 않았습니다. 이것은 하이브리드 참조 파일이고, 15년 된 뷰어가 열게 해 주는 바로 그 구조가 읽기를 너무 일찍 멈추는 로더를 이기는 구조입니다
이것은 모든 내부 테스트를 통과한 PDF 파이프라인이 양방향 처리(round-trip)할 수 없는 파일을 만나는 가장 흔한 방식 중 하나입니다. 입력 파일들이 모두 자체적으로 생성되었기 때문에 하이브리드 형식이 아니었던 것입니다. 최초의 하이브리드 파일은 고객이 스프레드시트에서 내보낸 인보이스를 전달하는 그날 도착하게 됩니다
Word와 Excel이 실제로 작성하는 내용
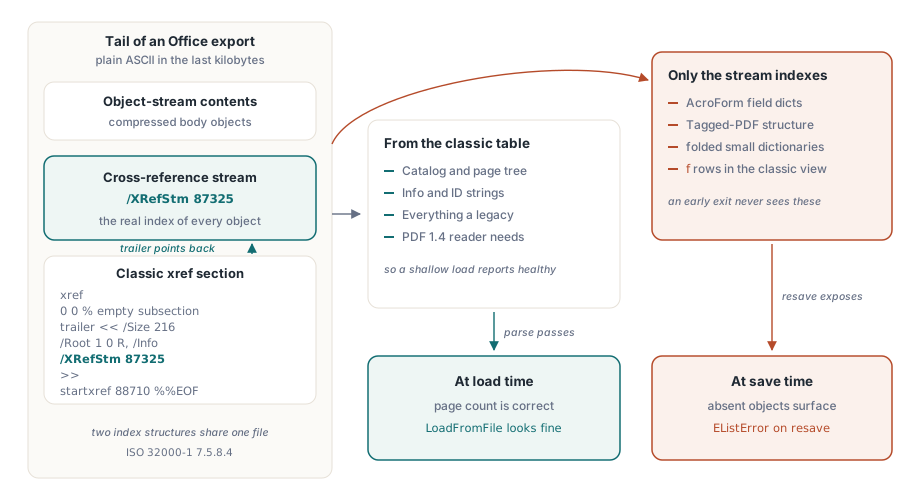
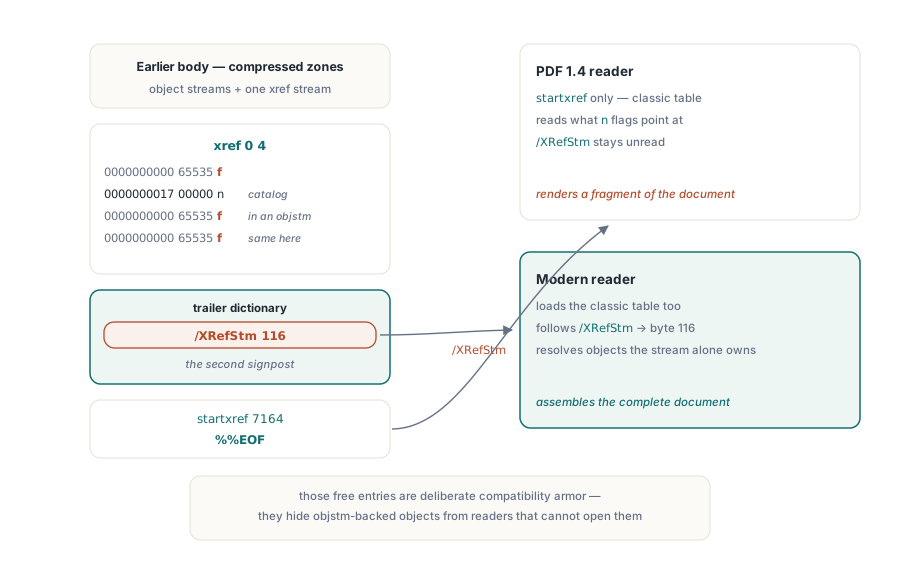
ISO 32000-1은 §7.5.8.4에서 하이브리드 참조 레이아웃을 설명합니다. 개체 스트림(object streams)과 같은 PDF 1.5 기능을 원하면서도 PDF 1.4 리더(reader)가 파일을 열 수 있게 하려는 애플리케이션은 상호 참조 정보를 두 번 씁니다. 버전 1.4까지 모든 PDF의 끝에 위치했던 고정 폭 ASCII 행인 클래식 상호 참조 테이블(classic cross-reference table)이 있고, 나머지를 인덱싱하는 상호 참조 스트림(cross-reference stream)이 존재합니다. 클래식 섹션의 트레일러(trailer)에는 해당 스트림의 바이트 오프셋을 값으로 갖는 /XRefStm 항목이 포함되어 있습니다
역할 분담은 의도적입니다. 오래된 리더가 닿아야 하는 객체, 그중에서도 카탈로그와 페이지 트리는 클래식 테이블에서 주소 지정이 됩니다. 압축된 개체 스트림으로 접힌 객체들은 클래식 테이블에서 type f 항목의 free로 표시되어, 1.4 리더는 그것들을 그냥 지나치고 파싱할 수 없는 구조에서 넘어지지 않습니다. 그것들의 실제 위치는 오직 상호 참조 스트림에만 삽니다. 그런 파일의 특징은 꼬리입니다. 레거시 리더에게 필요한 객체만 커버하는 짧은 클래식 섹션이 있고, 그 trailer가 실제 복구 데이터가 사는 /XRefStm을 가리킵니다
하이브리드 꼬리는 레거시 리더가 필요로 하는 객체를 위한 클래식 테이블을 유지하고, 그 trailer의 /XRefStm 오프셋이 객체 인덱스의 나머지를 담은 스트림으로 이끕니다
정확한 페이지 수가 아무것도 증명하지 못하는 이유
카탈로그와 페이지 트리는 의도적으로 클래식 테이블에서 접근할 수 있도록 되어 있기 때문에, 해당 테이블만 읽는 로더는 /Root를 찾아 페이지 트리를 순회하고 정확한 페이지 수를 보고합니다. 이전 버전의 리더가 필요로 하는 모든 것이 존재하므로 파일은 정상인 것처럼 보입니다. 누락된 개체들은 개체 스트림에 포장된 것들입니다. AcroForm 필드 사전(dictionaries), 태그가 지정된 PDF(tagged-PDF) 구조 요소, 그리고 레거시 뷰어에 표시될 필요가 없었던 수많은 작은 사전들이 여기에 해당합니다
무언가가 그 개체들을 건드리기 전까지는 간극(gap)을 알아차리지 못하며 전체를 다시 저장하는(resave) 과정에서는 모든 개체를 건드리게 됩니다. 문서를 다시 암호화하거나 다시 작성하기 위해 순회(walking)하는 것은 모든 개체 번호를 순서대로 요청하는 작업이므로, 증상이 원인과 멀리 떨어진 로드(load) 시점이 아니라 저장 시점에 나타나는 것입니다
xref를 보고 멈추는 탐지기의 함정
파일이 어떻게 인덱싱되는지 결정하는 쉬운(cheap) 방법은 startxref를 따라가서 가리키는 첫 번째 바이트를 검사하는 것입니다. xref 키워드는 클래식 테이블을 의미하고 스트림 개체는 상호 참조 스트림을 의미합니다. 이 테스트는 한 가지 방식을 고수하는 모든 파일에 대해 정확합니다. 하지만 하이브리드 파일의 경우에는 틀립니다. 하이브리드 파일의 startxref는 오직 이전 버전의 리더를 만족시키기 위한 목적으로 클래식 섹션을 겨냥하는 반면, 문서의 대부분이 실제로 인덱싱되는 곳은 해당 섹션의 트레일러에 있는 /XRefStm입니다. 만나는 첫 번째 xref에서 "클래식"을 반환하는 탐지기는 /XRefStm을 절대 읽지 않으며, 스트림에만 존재하는 모든 개체는 보이지 않게 됩니다
var
  Pdf: THotPDF;
  PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    PageCount := Pdf.LoadFromFile('Invoice_XLS.pdf');  // 클래식 테이블에서 페이지들이 닿는다
    // 여기서 로드된 문서를 검사하거나 편집합니다
    Pdf.SaveLoadedDocument('Invoice_secured.pdf');     // 모든 객체가 필요하다. 스트림만 있는 것들도
  finally
    Pdf.Free;
  end;
end;
그 순서를 초기 탈출 탐지기 중심으로 만들어진 로더에서 돌리면 로드는 멀쩡해 보이고, 다시 저장이 빠진 객체들의 존재를 알립니다. 해법은 시작에서 더 많은 바이트를 읽는 게 아니라, 하이브리드 trailer를 알아보고 파일이 끝났다고 결정하기 전에 /XRefStm을 따라가는 것입니다
병합 순서는 타협할 수 없습니다
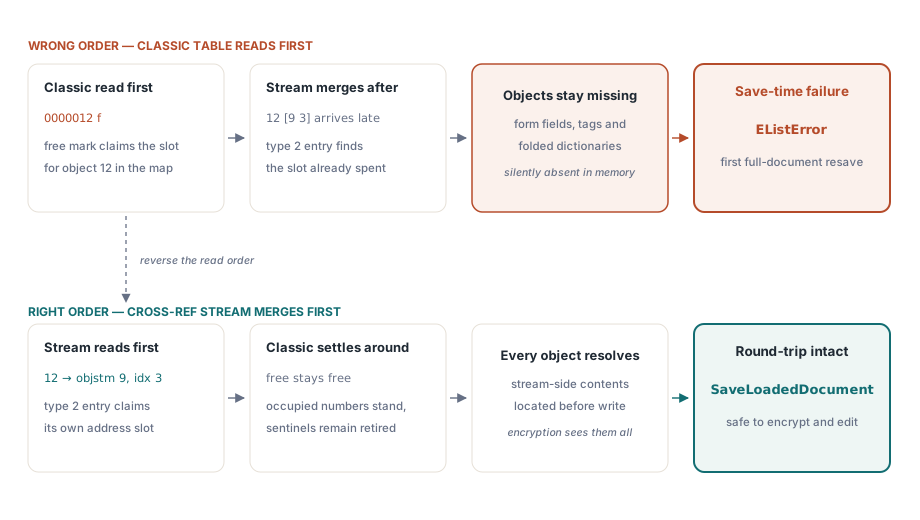
두 인덱스를 모두 읽고 나면 한 방향으로만 결합될 수 있습니다. 상호 참조 스트림을 먼저 병합하고 그 주변을 클래식 항목으로 채워야 합니다. 그 이유는 포맷의 핵심에 있는 작은 속임수 때문입니다. 하이브리드 파일은 압축된 개체들을 이전 버전의 리더가 무시하도록 클래식 테이블에 사용 가능(free)으로 표시합니다. 처음 본 것이 우선순위를 갖는(first-seen-wins) 정책을 존중하여 클래식 테이블을 먼저 읽는 로더는 해당 개체 번호를 사용 가능으로 기록한 다음, 슬롯이 이미 차지되어 있기 때문에 이들의 실제 위치를 가리키는 스트림 항목을 삭제하게 됩니다. 순서를 뒤집으면 스트림의 유형(type) 2 항목(각각 개체-스트림 번호와 인덱스로 구성됨)들이 자신들이 가져야 할 슬롯을 차지하고, 그 주위에 클래식 항목들이 자리 잡게 됩니다
동일한 원칙이 삭제된 개체를 이전 리비전(revision)이 부활시키는 것을 방지해줍니다. 증분 업데이트(Incremental updates)는 /Prev를 통해 역방향으로 연결되며, 유형(type) 0 자유 항목(free entry)은 더 최근의 섹션이 개체 번호를 폐기했음을 알리는 감시자(sentinel) 역할을 합니다. 체인상에서 더 나중의, 더 오래된 섹션이 오래된(stale) 위치로 해당 감시자를 덮어쓰도록 허용해서는 안 됩니다. 자유 마커(free markers)에 대해 가장 먼저 확인된 것(first-seen)을 권위있는 것으로 취급하면 삭제된 개체는 삭제된 상태로 유지됩니다. 하지만 부주의하게 다루면 파일 자체의 기록이 최신 리비전에서 제거한 콘텐츠를 다시 되살려내게 됩니다
스트림을 먼저 읽으면 type 2 항목들이 제자리를 차지해, 클래식 테이블이 그것들을 지우는 대신 그 주위에 자리 잡습니다
두 관점은 어떻게 벌어지나
위의 모든 것은 두 인덱스가 합의한다고 가정합니다. Word에서 곧바로 나온 파일은 그렇습니다. 각 관점은 자기가 선언한 범위 안에서 같은 문서를 묘사합니다. 문제는 파일이 둘 중 하나만 이해하는 도구를 지날 때 시작됩니다. 스탬핑 유틸리티가 단골 용의자입니다. 어떤 앱은 클래식식 증분 업데이트를 덧붙입니다. 새 객체 몇 개, 새 xref 섹션, 이전 섹션으로의 /Prev 링크, 새 trailer죠. 그 trailer가 /XRefStm을 빼먹으면 스트림 관점은 고아가 됩니다. 옛 값을 앞으로 복사하면 스트림 관점은 여전히 스탬프가 찍히기 전의 문서를 묘사합니다. 어느 쪽이든 인덱스는 이제 서로 다릅니다
하나의 trailer 키가 관점을 결정합니다. 클래식 테이블은 오래된 리더를 섬기고, /XRefStm은 최신 리더에게 나머지 전부를 찾는 스트림을 넘깁니다
일단 알면 특징은 알아보기 쉽습니다. 한 관점에서 보이는 객체가 다른 관점에서는 없거나 낡았습니다. 스트림으로 해석하는 리더는 갱신된 객체의 수정 이전 버전을 찾거나, 덧붙은 객체의 항목을 전혀 찾지 못합니다. 테이블만 믿는 리더는 편집을 보지만 스트림만이 찾을 수 있는 압축 객체 전부를 잃습니다. 사용자는 이것을 한 뷰어에서는 나타났다가 다른 뷰어에서 사라지는 폼 필드, 스탬핑 패스가 지워 버린 것처럼 보이는 주석, 엉뚱한 객체에 착지하는 룩업으로 묘사합니다
이 파일들을 쫓아다니기 비싸게 만드는 것은 Adobe Acrobat입니다. 선언된 인덱스가 바이트와 어긋나면 Acrobat은 보통 개체 헤더를 스캔해 상호 참조 데이터를 조용히 재구축합니다. 그래서 망가진 파일을 만든 사람은 그것을 열어 아무 이상 없는 것을 확인하고 넘겨 버립니다. 실패는 나중에, 다른 곳에서 드러납니다. 프리플라이트 검증기, 서명 서비스, 아카이브 수집 작업처럼 선언된 구조를 믿고 누락된 객체나 상호 참조 불일치를 보고하는 소비자들에서요. "Acrobat에서는 잘 열리는데"가 하이브리드 비동기화 티켓의 거의 항상 첫 문장입니다
이것이 HotPDF에서 의미하는 바
엔진이 하이브리드 참조 파일을 대신 해석하며, 상호 참조 데이터를 파싱해야 하는 모든 경로에서 그렇게 합니다. LoadFromFile이나 LoadFromStream으로 문서를 로드하고, 변경을 가하고, SaveLoadedDocument를 호출하거나, 입력을 읽어 출력을 쓰는 EncryptFile 같은 단발 연산을 돌리세요. 어느 쪽이든 복구는 /XRefStm을 읽고, 스트림 섹션을 클래식 항목들 앞에 병합하며, 쓰기가 객체들을 나열하기 전에 스트림에 사는 객체들을 해석합니다. AES-256 암호화 경로에서 이것이 가장 눈에 띄게 중요한데, 문서를 암호화하면 모든 객체를 다시 쓰므로 모든 객체가 이미 찾아져 있어야 하기 때문입니다
알아둘 만한 세부 사항은 API의 상위 단계(upstream)에 있습니다. Word, Excel, PowerPoint 그리고 수많은 "PDF로 저장" 파이프라인에서 생성된 파일들은 일상적으로 하이브리드 형식을 띱니다. 따라서 사용자가 직접 만든 생성기의 출력물로만 로더를 테스트하면 이러한 파일을 한 번도 만나지 못할 수 있습니다. 자체 코드에서 생성한 파일뿐만 아니라 실제 Office 애플리케이션에서 내보낸(exported) 문서들을 테스트 픽스처(fixtures)에 포함시키십시오
의심되는 파일 확인하기
두 번의 검사로 이 의문을 빠르게 해결할 수 있습니다. 헥스(hex) 뷰로 파일을 열고 마지막 startxref 뒤의 바이트를 읽어보세요. 하이브리드 파일은 트레일러 사전에 /XRefStm이 포함된 짧은 클래식 섹션을 보여줍니다. 또는 전체 분석(parse) 시 보고되는 개체의 수와 트레일러의 /Size가 선언하는 가장 높은 개체 번호를 비교해보세요. 큰 차이가 난다면 로더가 열지 않은 스트림에 개체들이 숨겨져 있다는 뜻이며, 이 누락된 부분은 나중에 저장 시점의 실패로 이어지게 됩니다
일반적인 Excel 내보내기 파일의 꼬리(tail) 부분을 살펴보면 첫 번째 검사를 구체적으로 이해할 수 있습니다. 마지막 xref 키워드 뒤의 모든 것은 일반 ASCII이므로 헥스 뷰에서 바로 그 특징을 읽을 수 있습니다. (오프셋은 예시이며 주석이 추가됨)
xref
0 16                         % 개체 0-15. 레거시 리더가 필요로 하는 것들
0000000000 65535 f
0000000017 00000 n
...                          % 나머지 14개 행. 나머지는 개체 스트림 속에
trailer
<< /Size 216                 % 사용 중인 가장 큰 개체 번호보다 1 큼
   /Root 1 0 R
   /Info 15 0 R
   /ID [<5C9A...> <5C9A...>]
   /XRefStm 87325            % cross-reference stream의 바이트 오프셋
>>
startxref
88710                        % 위의 classic section을 가리킴
%%EOF
trailer의 /XRefStm 키가 결정적 증거입니다. 위의 클래식 섹션은 파일이 쓰는 216개 개체 번호 중 16개를 나열할 뿐입니다. 개체 스트림으로 포장된 것들은 그 목록에 없거나 free로 표시되어 있습니다. xref 키워드에서 멈추는 탐지기는 이 시점에서 그 부분 인덱스만 봤을 뿐입니다. 육안 대신 스크립트로 확인하고 싶다면, 마커는 파일의 마지막 몇 킬로바이트 안에 있으므로 제한된 역방향 읽기면 충분합니다. 파일이 이후 증분 업데이트를 거쳤다면 꼬리에 trailer가 하나 이상 있고, 유효한 것은 마지막입니다
// 파일의 꼬리에서 가장 최신 trailer의 /XRefStm 오프셋을 반환하고,
// 마커가 없으면 -1을 반환한다 (하이브리드가 아니거나 PDF가 아예 아님)
function FindXRefStm(const FileName: string): Int64;
var
  FS: TFileStream;
  Tail: AnsiString;
  Len, P, Q: Integer;
begin
  Result := -1;
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Len := 2048;                        // trailer는 꼬리에 산다
    if FS.Size < Len then
      Len := Integer(FS.Size);
    FS.Position := FS.Size - Len;       // 제한된 역방향 읽기: 최대 2 KB
    SetLength(Tail, Len);
    FS.ReadBuffer(Tail[1], Len);
  finally
    FS.Free;
  end;
  P := 0;                               // 마지막 마커를 유지한다. 증분 업데이트는
  Q := Pos(AnsiString('/XRefStm'), Tail); // 더 새로운 trailer를 뒤에 덧붙인다
  while Q > 0 do
  begin
    P := Q;
    Q := Pos(AnsiString('/XRefStm'), Tail, P + 1);
  end;
  if P = 0 then
    Exit;                               // 꼬리에 하이브리드 마커가 없다
  Inc(P, Length('/XRefStm'));
  while (P <= Len) and (Tail[P] in [' ', #9, #13, #10]) do
    Inc(P);                             // 키 뒤의 공백을 건너뛴다
  Result := 0;
  while (P <= Len) and (Tail[P] in ['0'..'9']) do
  begin
    Result := Result * 10 + Ord(Tail[P]) - Ord('0');
    Inc(P);
  end;
end;

// 사용법: 0 이상의 결과는 스트림이 시작되는 바이트 위치를 나타낸다
if FindXRefStm('Invoice_XLS.pdf') >= 0 then
  Writeln('hybrid-reference file: resave will need the /XRefStm section');
이 탐지를 파서가 아니라 분류(triage)로 다루세요. 다시 저장 작업이 돌기 전에 배치 안의 어떤 파일이 주의를 받아야 하는지 알려 줄 뿐, 그 이상은 아무것도 하지 않습니다
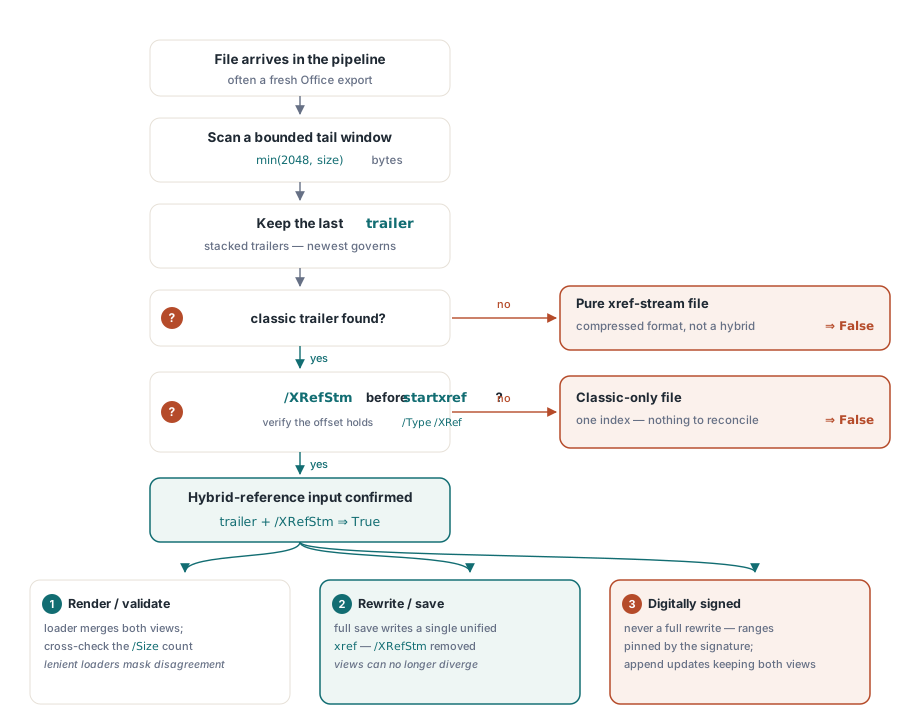
실제 입력 폴더에 겨눠 보면 파일은 셋으로 갈라집니다. 클래식 전용 파일은 꼬리에 trailer 키워드가 있지만 /XRefStm이 없어 탐지가 -1을 돌려줍니다. 상호 참조 스트림에 전면적으로 헌신한 파일도 -1을 돌려주는데, 이번에는 올바르게입니다. trailer 키워드가 전혀 없습니다. trailer 키들이 스트림 사전 안에 살기 때문입니다. 이중 인덱스 배치만 오프셋을 돌려줍니다. 분류 보고서가 앞의 둘을 구별해야 한다면 버리기 전에 같은 꼬리에서 trailer를 검색하세요. Pos 호출 하나면 됩니다
탐지를 무인으로 돌리기 전에는 두 곳에서 단단하게 만드세요. 오프셋은 주장일 뿐입니다. 그곳으로 Seek해서 사전이 /Type /XRef라고 말하는 개체가 정말 그곳에 사는지 확인하세요. 손상되거나 잘린 파일도 키는 지니고 이름 지어진 스트림은 없어져 있을 수 있습니다. 그런 파일은 건강한 하이브리드와 다른 바구니에 넣어야 합니다. 검사는 같은 파일 처리 위에 몇 줄이면 됩니다
// Offset은 FindXRefStm이 반환한 값이고, FS는 같은 방식으로 연
// TFileStream이며, Head는 AnsiString이다 (Min은 System.Math에서 온다)
if Offset >= FS.Size then
Exit(False); // 키는 살아남았지만 스트림은 그렇지 못했다
FS.Position := Offset;
SetLength(Head, Integer(Min(Int64(512), FS.Size - Offset)));
FS.ReadBuffer(Head[1], Length(Head));
Result := (Pos(AnsiString('/Type /XRef'), Head) > 0) or
(Pos(AnsiString('/Type/XRef'), Head) > 0); // PDF 문법은 두 철자를 모두 허용한다
그다음은 2 KB 창을 매개변수로 만드는 것입니다. 2킬로바이트면 평범한 Office 출력을 커버하지만, 유난히 큰 trailer 사전은 마커를 범위 밖으로 밀어 낼 수 있습니다. 창을 넓히는 쪽이 파일을 우연히 클래식이라 선언하는 것보다 낫습니다
하이브리드 파일을 파이프라인으로 흘려보내기
탐지가 값어를 하는 것은 파일의 다음 행선지를 바꿀 때입니다. 그곳이 어디인지는 파이프라인이 그 파일로 무엇을 하려 하는지에 달려 있습니다
제한된 꼬리 검색은 판정 셋을 내놓고, 이중 인덱스 사례만 진짜 하이브리드로 다음 단계에 흘러갑니다
읽기, 렌더링, 검증만 하는 파일은 두 관점을 모두 해석하는 로더로 가야 합니다. PDFium Component는 로드 동안 /XRefStm 체인을 파싱하므로 여러분 코드가 보는 개체 테이블은 이미 병합된 것이고, 개체 및 상호 참조 스트림 검증에 관한 글의 검사들은 그대로 적용됩니다. 비동기화된 하이브리드가 로드를 거부할 만큼 심하게 손상됐다면 엔진이 로드 오류 코드로 보고하는데, 구조적 손상이 내는 것이 FPDF_ERR_FORMAT입니다. 깨끗한 로드는 더 약한 증거입니다. PDFium은 설계상 관대해서 대부분의 비일관 파일을 아무 말 없이 재구축하므로, 성공은 파일이 복구 가능했다는 것만 증명하고 두 관점이 합의하는지에 대해서는 아무것도 말하지 않습니다. 그 질문으로 돌아가려면 전체 개체 순회가 찾은 것과 trailer의 /Size를 비교하세요
파이프라인이 수정하는 파일은 다른 이야기입니다. 저희 선호는 둔감합니다. 애초에 하이브리드인 채로 두지 않는 것입니다. HotPDF로 문서를 로드해 전체 저장하면 출력은 하나의 형태로 자기 일관적인 상호 참조 하나를 실어 나릅니다. /XRefStm도 없고, 흐트러질 두 번째 관점도 없으며, 모든 객체는 정확히 하나의 인덱스 항목이 소유합니다. 아카이브 수집 전에, 엄격한 하류 RIP나 서명 서비스 전에, 하이브리드 입력에 가해진 편집 뒤에 원하는 것이 바로 이 정규화입니다. 전체 저장은 로드가 찾아 낸 객체만 쓸 수 있으므로, 이것은 전적으로 앞서 말한 스트림 우선 병합에 기댑니다
서명된 문서가 예외입니다. 전체 재작성은 모든 바이트를 옮기고, 그러면 원본 바이트 범위에 대해 계산된 서명은 무효가 됩니다. 서명된 하이브리드에 가할 변경은 두 관점을 걸음맞춰 유지하는 정식 증분 업데이트로 들어가야 하고, 읽기만 필요한 서명 파일은 파이프라인이 손대지 않은 채 통과시켜야 합니다