HotPDF는 로드된 문서를 사람이 읽고 편집하기 쉽도록 설계된 진단 형식으로 저장한 다음, 편집을 마친 파일을 복구할 수 있습니다. SaveLoadedDocumentDiagnostic은 결정적인 딕셔너리 순서로 문서를 기록하며, 모든 객체를 일반 간접 객체로 두고, 객체 스트림이나 상호 참조 스트림, 선형화를 전혀 사용하지 않습니다. 그런 다음 RepairDiagnosticDocument가 편집으로 인해 무효화된 바이트 오프셋, 스트림 길이, 상호 참조 테이블, 트레일러를 다시 만들어 냅니다
이 한 쌍은 하나의 워크플로를 위해 존재합니다: PDF 안에 실제로 무엇이 들어 있는지 이해하거나 고치는 것입니다. 렌더링 문제를 디버깅해 본 개발자라면 누구나 파일을 열어서 딕셔너리 하나의 숫자 하나만 바꾸고 결과를 확인해 보고 싶었을 것입니다. 일반적인 PDF에서는 이것이 불가능한데, 콘텐츠가 객체 스트림으로 압축되어 있고 삽입하는 바이트 하나하나가 상호 참조 테이블이 정확히 기록해 둔 오프셋을 밀어내기 때문입니다
진단용 저장은 무엇이 다른가?
여섯 가지 설정이 함께 바뀝니다. 딕셔너리 키는 결정적인 순서로 기록되므로, 같은 문서를 두 번 저장해도 비교 가능한 파일이 나옵니다. 진단 출력 모드는 구조에 주석을 답니다. 전체 재작성이 강제되므로, 손대지 않은 증분 리비전으로 넘어가는 부분이 없습니다. 선형화는 꺼지는데, 선형화된 파일은 읽는 사람이 아니라 웹 뷰어를 위해 구성되기 때문입니다. 상호 참조 스트림은 꺼지므로 테이블은 순수 텍스트입니다. 그리고 객체 스트림도 꺼지므로 압축된 컨테이너 안에 숨겨진 객체가 없습니다
결과로 나온 파일은 헤더에 일반적인 %PDF- 서명과 함께 진단 마커를 담고 있으며, 본문은 어떤 편집기로도 훑어볼 수 있습니다. 객체들은 하나씩 차례로 나타나고, 딕셔너리는 읽기 쉬우며, 콘텐츠 스트림도 쉽게 찾을 수 있는 위치에 있습니다. 복구 도구는 이 마커를 확인하며 마커가 없는 파일은 거부하는데, 일반 PDF의 압축된 구조는 바이트 범위 복구 도구가 해석을 시도해서는 안 되는 대상이기 때문입니다

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // 읽기 쉽고, 블록당 객체 하나, 객체 스트림에 숨겨진 것 없음
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
왜 편집하면 파일이 깨지고, 무엇을 다시 만들어야 하는가?
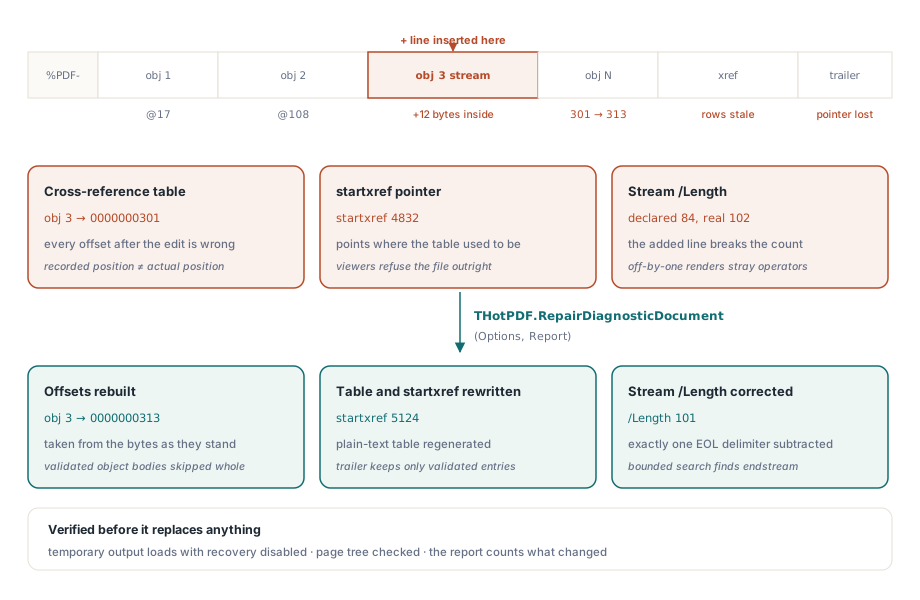
PDF 안에서 세 가지가 바이트 위치나 바이트 개수를 인코딩합니다. 상호 참조 테이블은 모든 객체 번호를 바이트 오프셋에 매핑합니다. 파일 끝의 startxref 값은 그 테이블을 가리킵니다. 그리고 모든 스트림 딕셔너리는 스트림 본문이 차지하는 바이트 수를 나타내는 /Length를 담고 있습니다
파일 끝 이전 어디서든 문자 하나를 바꾸면 그 뒤의 오프셋들은 모두 틀리게 됩니다. 콘텐츠 스트림에 줄을 하나 추가하면 그 /Length도 틀리게 됩니다. 대부분의 뷰어는 그 파일을 거부하며, 복구해 내는 뷰어들도 스캔을 통해 그렇게 하는데, 이는 실수를 고치는 것이 아니라 감추는 것입니다. 복구는 이 세 가지 모두를 바이트가 실제로 지금 말하고 있는 내용을 바탕으로 다시 만들어 냅니다
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // 교체 전에 결과를 로드해 확인

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
바이트를 복사할 뿐, 재직렬화하지 않는다
이 도구를 신뢰할 수 있게 만드는 설계 결정은, 문서를 로드해서 다시 써내는 일을 결코 하지 않는다는 점입니다. 검증을 마친 객체들의 바이트 범위를 복사하고, 잘못된 /Length 값만 바꾼 다음, 그 주위로 테이블·트레일러·startxref를 다시 만듭니다
로드 후 재직렬화하는 방식이라면 구현하기는 훨씬 쉽겠지만 조용히 여러 것을 바꿔 버립니다. 알 수 없는 객체 구문은 정규화되고, 문자열 이스케이프는 작성기가 선호하는 형식으로 다시 쓰이며, 이미 인코딩된 스트림 페이로드가 다시 인코딩될 수도 있습니다. 디버깅 도구로서는 이것을 받아들일 수 없습니다. 숫자 하나를 편집했다면 diff에도 숫자 하나만 나타나야 하며, 부수적인 서식 변경 수천 개가 나타나서는 안 됩니다. 두 파일 사이에 정확히 무엇이 바뀌었는지 알고 싶다면 그것은 비교의 문제이며, 구조와 픽셀로 두 PDF 파일 비교하기에서 다룹니다

가짜 객체를 막는 두 가지 파싱 규칙
바이트 범위 스캐너는 명백한 함정에 직면합니다: 객체 헤더처럼 보이는 텍스트가 스트림 페이로드나 문자열 내부에 나타날 수 있다는 것입니다. 순진한 스캔은 콘텐츠 스트림 한가운데를 가리키는 상호 참조 행을 만들어 낼 것이고, 그 결과 파일은 새롭고 더 혼란스러운 방식으로 깨지게 됩니다
HotPDF는 검증된 각 객체의 전체 바이트 범위를 기록된 끝 오프셋을 이용해 건너뛰는 방식으로 이를 피하므로, 객체 본문 내부의 어떤 것도 후보로 간주되지 않습니다. 객체 사이에는 PDF 공백과 주석만 허용되며, 그 밖의 것이 있다면 그 영역은 이해되지 않은 것이므로 해당 바이트는 출력으로 끌어올 수 없습니다
스트림 길이는 동일한 주의가 필요합니다. 실제 페이로드 길이는 작성기가 endstream 앞에 삽입하는 줄 끝 구분자를 제외한 값입니다. 선언된 길이가 정확히 그 마커 위치에 맞아떨어지면 그 선언이 그대로 받아들여집니다. 맞지 않는다면 복구 도구는 endstream과 endobj 쌍에 대해 범위가 제한된 검색을 수행하고 CR, LF, CRLF 중 정확히 구분자 하나만큼을 뺍니다. 여기서 1바이트라도 틀리면 파일은 열리고 페이지도 렌더링되지만, 콘텐츠 스트림 끝에 엉뚱한 연산자 하나가 남게 됩니다
트레일러가 유지해도 되는 것
다시 만들어진 트레일러는 예전 것의 복사본이 아닙니다. /Size, /Prev, /XRefStm은 모두 이전 파일 레이아웃을 설명하는 값이므로 다시 계산되거나 제거됩니다. 대상이 검증된 항목만 남는데, /Info, /ID, /Encrypt가 그것입니다. 그리고 /Root는 정확히 하나의 Catalog 객체로 해석되어야 합니다. 0개도, 여러 개도 안 되는데, 여러 개가 되는 경우는 대개 객체 블록을 복사해 붙여넣어 조립한 파일에서 나타납니다
출력 안전성은 사람들이 신경 쓰는 파일을 다루는 도구답게 처리됩니다. 결과는 대상 디렉터리의 임시 파일에 기록된 다음, 상호 참조 복구를 비활성화한 일반 경로로 로드해 검증되므로, 복구 기능 덕분에만 열리는 파일은 실패로 처리됩니다. 페이지 트리가 검증된 후에야 임시 파일이 대상 파일을 원자적으로 대체합니다. 실패한 복구는 결코 기존 출력을 덮어쓰지 않습니다
예산과 정직한 실패 코드
작업을 제한하는 세 가지 한도가 있습니다: 입력 바이트, 후보 객체 개수, 최대 객체 번호이며, 기본값은 각각 8GiB, 200만, 200만입니다. 객체 번호 상한선은 보이는 것보다 중요한데, 몇 안 되는 객체 번호가 수십억 단위로 흩어져 있는 희소한 테이블이라면 그렇지 않을 경우 다시 만들어진 상호 참조 테이블이 엄청나게 부풀어 오르기 때문입니다. 고전적인 상호 참조 테이블은 10자리를 넘는 십진 숫자가 필요한 오프셋도 거부하는데, 이는 구현상의 선택이 아니라 포맷 자체의 한계입니다
실패는 불리언이 아니라 구체적인 상태를 보고합니다: 잘못된 인자, 소스가 너무 큼, 진단 파일이 아님, 객체 한도 초과, 잘못된 객체, 중복 객체, 카탈로그 누락, 잘못된 트레일러, 출력 오류, 검증 실패입니다. 각각은 서로 다른 해결책으로 이어집니다. 중복 객체는 객체 블록을 두 번 붙여넣었다는 뜻입니다. 카탈로그 누락은 대개 /Type /Catalog를 담고 있던 객체가 손상되었다는 뜻입니다. 검증 실패는 이제 구조는 일관되지만 페이지 트리가 로드되지 않는다는 뜻이며, 이는 대개 /Kids 배열이 /Count와 어긋나게 편집되었을 때 나타납니다
실무적인 참고 사항 두 가지로 마무리하겠습니다. 복구된 파일뿐 아니라 진단 파일도 보관해 두면, 다음 편집을 읽기 쉬운 기반에서 다시 시작할 수 있습니다. 그리고 진단 출력을 최종 사용자에게 배포하지 마세요. 아무것도 객체 스트림으로 압축되어 있지 않기 때문에 일반 저장보다 크며, 파일을 작게 유지하는 프로덕션 경로는 객체 스트림과 증분 업데이트에서 설명하는 일반 저장 경로입니다. 목표가 파일을 고치는 것이 아니라 무엇이 잘못됐는지 찾는 것이라면, 프리플라이트 보고서 자동화의 자동화된 경로가 바이트를 직접 읽는 것보다 더 빠르게 답을 줍니다
진단용 저장, 복구, 프리플라이트, 비교는 모두 Delphi와 C++Builder에서 동일한 로드된 문서 모델을 대상으로 동작합니다. 전체 기능 목록은 HotPDF Delphi PDF 컴포넌트 페이지에서 확인할 수 있습니다