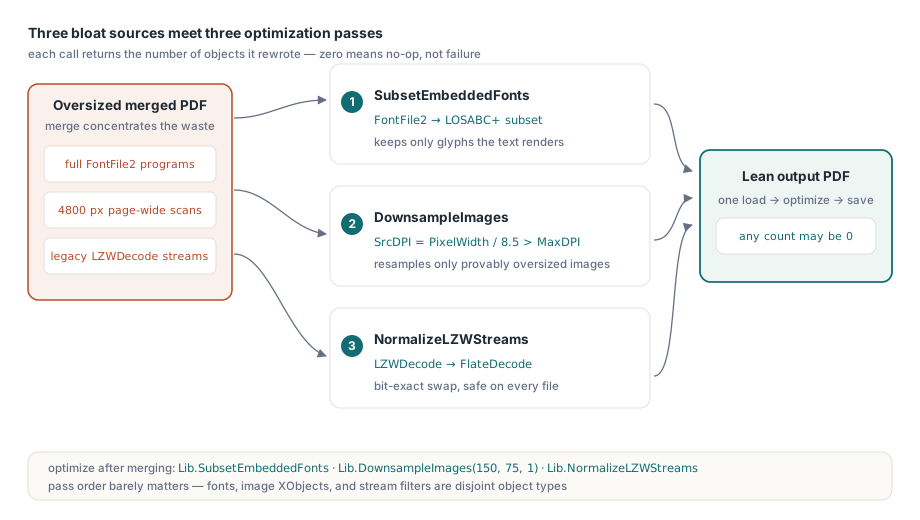
Delphi에서 PDF 파일 크기를 줄이기 위해 losLab PDF Library는 비대화의 3대 원인을 정면으로 공격하는 API 세 개를 제공합니다. SubsetEmbeddedFonts는 임베드된 모든 TrueType 폰트 프로그램을 문서가 실제로 그리는 글리프만 남도록 다시 쓰고, DownsampleImages는 목표 DPI를 넘는 래스터 이미지를 재샘플링하며, NormalizeLZWStreams는 오래된 LZWDecode 압축을 FlateDecode로 교체합니다. 각각은 자신이 바꾼 객체 수를 반환하므로, 0이라는 값은 조용한 실패가 아니라 그 패스가 아무 일도 하지 않았음을 알려 줍니다
병합한 PDF가 왜 원본 파일들보다 클까요?
병합했거나 프로그램으로 생성한 PDF가 과도하게 커지는 이유는 대개 셋 중 하나입니다. 완전히 임베드된 폰트, 표시 해상도보다 훨씬 높게 샘플링된 이미지, 그리고 여전히 오래된 LZW 필터로 압축된 스트림입니다. ISO 32000-1 §9.9는 생산자가 폰트 프로그램 전체를 임베드하도록 허용하고, 대부분의 생산자는 그것이 안전한 기본값이라는 이유로 정확히 그렇게 합니다. 완전한 Arial FontFile2는 수백 킬로바이트에 이릅니다. 그것을 열두 개의 원본 파일에 임베드하고 병합하면, 아무도 입력하지 않은 문자들의 글리프 윤곽선 사본 열두 벌을 짊어지게 됩니다. 병합 자체가 낭비를 만드는 것은 아니고, 그저 낭비를 한 파일에 모아 합계가 드디어 눈에 보이게 만들 뿐입니다
이미지가 두 번째 범인입니다. 4800픽셀 폭의 스캔본을 4분의 1 페이지 크기 프레임에 넣으면, 300 DPI 인쇄 파이프라인이 쓸 수 있는 양보다 대략 40배 많은 픽셀 데이터를 실어 나릅니다. 세 번째는 더 조용합니다. LZWDecode로 필터링된 스트림입니다. ISO 32000-1 §7.4.4는 LZWDecode와 FlateDecode를 모두 규정하면서 Flate가 보통 적어도 그만큼은 잘 압축한다고 언급합니다. 실제로 같은 데이터에서 Flate 출력은 일관되게 더 작고, LZW는 이력 어딘가에서 1990년대식 도구를 거쳐 온 파일에 주로 살아남아 있습니다. 이 글의 나머지는 각 문제를 해결하는 losLab PDF Library의 세 패스를 차례로 살펴본 다음 하나의 파이프라인으로 묶습니다
SubsetEmbeddedFonts로 폰트 서브셋화하기
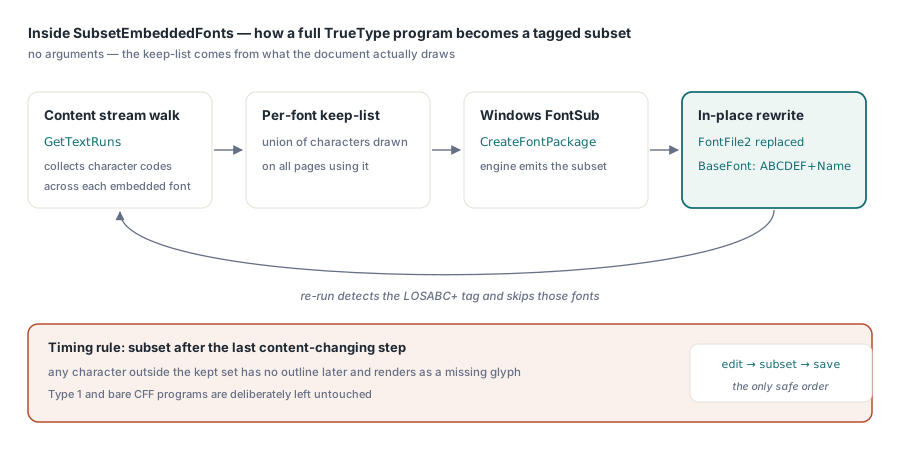
SubsetEmbeddedFonts는 로드된 문서에 임베드된 모든 TrueType 폰트를 문서가 실제로 쓰는 문자만 남도록 줄이며, 유지 목록을 콘텐츠 스트림 자체에서 끌어내기 때문에 인자가 필요 없습니다. 내부적으로 이 패스는 GetTextRuns로 모든 페이지의 콘텐츠 스트림을 훑어 각 폰트 리소스 아래에서 참조된 문자 코드를 모으고, 유지 목록을 만든 뒤 원본 폰트 프로그램을 Windows FontSub 엔진(CreateFontPackage)에 넘겨 서브셋을 생성합니다. 다시 쓰인 프로그램은 제자리에서 FontFile2 스트림을 대체하고, BaseFont 이름에는 LOSABC+ 태그가 붙습니다. 이는 ISO 32000-1 §9.6.4가 서브셋 폰트에 대해 정의한 대문자 여섯 자와 더하기 기호 규약입니다. 이 접두부는 호출을 멱등하게 만들어 주기도 합니다. 패스를 두 번 돌리면 이미 서브셋화된 폰트는 인식되어 건너뛰므로, 같은 파일을 다시 방문할 수 있는 배치 작업에 연결해도 안전합니다
var
  Lib: TPDFlib;
  Fonts: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('merged-report.pdf', '') = 1 then
    begin
      Fonts := Lib.SubsetEmbeddedFonts;
      // Fonts = 다시 쓰인 FontFile2 프로그램 개수;
      // 0이면 임베드된 폰트가 없거나 이미 전부 서브셋화된 상태
      Lib.SaveToFile('merged-report-subset.pdf');
    end;
  finally
    Lib.Free;
  end;
end;
API의 경계를 설명해 주므로 알아 둘 만한 구현 세부가 둘 있습니다. 첫째, 이 패스는 FontFile2를 대상으로 하므로 임베드된 TrueType 프로그램을 다룹니다. Type 1이나 순수 CFF로 임베드된 폰트는 위험을 감수하기보다 그대로 둡니다. 둘째, FontSub에 의존하므로 SubsetEmbeddedFonts는 Windows 전용입니다. 구현에서 나오는 조금 더 미묘한 점도 있습니다. 어떤 폰트가 대상이 되는지는 임베드 플래그 휴리스틱을 믿는 대신 FontDescriptor → FontFile2 참조 사슬을 실제로 해석해 결정합니다. 로드된 문서 안의 폰트는 그런 플래그를 세우는 생성 측 기록 과정을 애초에 거치지 않았기 때문입니다. 해석된 스트림이 존재하면 그 폰트는 후보이고, 없으면 오류 없이 건너뜁니다
솔직한 대가도 있습니다. 서브셋 폰트에는 서브셋화 시점에 존재하던 글리프만 담깁니다. 이후 하류 도구나 여러분 자신의 코드가 같은 폰트로 텍스트를 추가하면, 서브셋 밖의 문자에는 윤곽선이 없어 누락 글리프로 그려집니다. 서브셋화는 콘텐츠를 바꾸는 마지막 단계에서 하고, 편집 단계 앞에서는 절대 하지 마십시오. 나중에 재사용을 위해 폰트를 도로 꺼낼 계획이라면 같은 주의가 적용됩니다. PDF Library for Delphi로 텍스트, 이미지, 폰트를 추출하는 글이 추출된 서브셋 프로그램이 무엇을 줄 수 있고 무엇을 줄 수 없는지 다룹니다
DownsampleImages는 어떤 이미지를 줄일지 어떻게 정할까요?
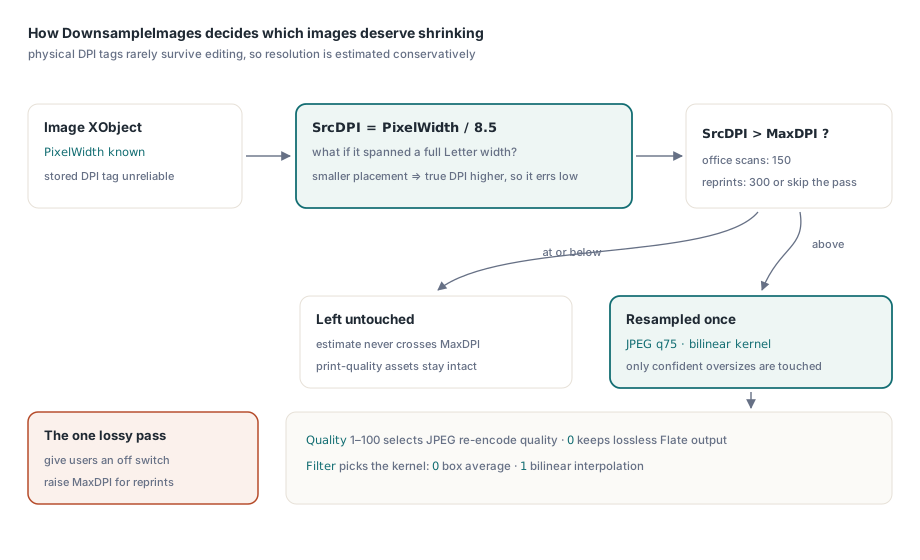
DownsampleImages(MaxDPI, Quality, Filter)는 일부러 보수적으로 잡은 DPI 추정치를 써서, 과샘플링되었다고 자신 있게 말할 수 있는 이미지만 재샘플링합니다. PDF 이미지 XObject는 픽셀 치수는 저장하지만 믿을 만한 물리 해상도는 저장하지 않고, 원본 이미지에 있던 DPI 태그는 로드-편집-저장 주기를 좀처럼 살아남지 못합니다. 그래서 이 패스는 SrcDPI = PixelWidth / 8.5로 추정합니다. 사실상 이렇게 묻는 셈입니다. 이 이미지가 Letter 페이지의 전체 폭을 채운다면 해상도가 얼마가 될까? 추정치가 MaxDPI를 넘는 이미지만 손댑니다. 이 편향은 의도된 것입니다. 페이지에 작게 배치된 이미지는 실제 DPI가 추정치보다 높으므로, 이 패스는 측정할 수 없는 인쇄 품질 자산을 훼손하기보다 덜 발동하는 쪽을 택합니다
1에서 100까지의 Quality는 JPEG 재인코딩 품질을 고르고, 0은 출력을 무손실 PNG 방식의 Flate로 유지합니다. Filter는 재샘플링 커널을 고르는데 0은 박스 평균, 1은 바이리니어입니다. 스캔한 사무 서류라면 DownsampleImages(150, 75, 1)이 합리적인 출발점입니다. 다시 인쇄될 수 있는 것이라면 MaxDPI를 300으로 올리거나 이 패스를 아예 건너뛰십시오. 다운샘플링은 셋 중 유일하게 손실이 있는 단계이므로, 사용자가 끌 수 있는 설정 뒤에 두는 것이 마땅합니다
NormalizeLZWStreams로 오래된 LZW 스트림 변환하기
NormalizeLZWStreams는 공짜로 얻는 이득입니다. 모든 LZWDecode 스트림을 무손실로 풀어 FlateDecode로 제자리에서 다시 압축하고, 변환한 스트림 수를 반환합니다. 단일 /Filter /LZWDecode 항목은 물론 필터 체인 배열 안에 LZW가 등장하는 경우도 처리하는데, 이때는 LZW 고리만 교체하고 체인의 나머지는 보존합니다. 예측기 매개변수(Predictor, Columns, Colors, BitsPerComponent)는 스트림의 DecodeParms에서 읽어 압축 해제기로 그대로 전달하므로, 예측기로 인코딩된 이미지 데이터도 올바르게 왕복합니다. 두 필터 모두 비트 단위로 정확한 코덱이므로 디코딩된 바이트는 전후가 동일하고 컨테이너 압축만 바뀝니다. 이 패스를 모든 파일에 조건 없이 돌려도 안전한 이유가 바로 이것입니다
LZW 스트림이 없는 문서에서는 호출이 그저 0을 반환하고 아무것도 건드리지 않으며, 라이브러리의 회귀 테스트가 이를 명시적으로 확인합니다. 갓 만든 Flate 전용 파일은 변환 0건을 보고해야 합니다. 이 무동작 보장은 2024년 것과 1998년 것이 뒤섞인 수천 개의 이질적인 파일을 처리하는 파이프라인에 이 패스가 놓일 때 중요해집니다
Delphi에서의 완전한 크기 최적화 파이프라인
세 패스는 로드-최적화-저장 함수 하나로 묶이며, 순서는 생각보다 덜 중요합니다. 서로 겹치지 않는 객체 종류, 즉 폰트, 이미지 XObject, 스트림 필터를 다루기 때문입니다. 그래도 서브셋화를 먼저 돌리는 편이 깔끔합니다. 편집 순서 제약이 있는 패스가 그것뿐이기 때문입니다
function OptimizePDF(const Src, Dst: string): Boolean;
var
  Lib: TPDFlib;
  Fonts, Images, Streams: Integer;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Src, '') <> 1 then
      Exit;
    Fonts   := Lib.SubsetEmbeddedFonts;        // TrueType FontFile2 -> 서브셋
    Images  := Lib.DownsampleImages(150, 75, 1); // >150 DPI -> JPEG q75, 바이리니어
    Streams := Lib.NormalizeLZWStreams;        // LZWDecode -> FlateDecode
    Result := Lib.SaveToFile(Dst) = 1;
    // Fonts/Images/Streams 기록: 세 값이 모두 0이면 파일이 이미 가벼웠다는 뜻
  finally
    Lib.Free;
  end;
end;
파이프라인은 라이브러리가 스스로를 검증하는 방식대로 검증하십시오. 바로 왕복입니다. v3.130 회귀 테스트는 문서를 만들고, 저장하고, 다시 읽어 들이고, 최적화를 돌리고, 다시 저장한 다음 세 가지를 단언합니다. 출력이 더 작아졌는지, 반환된 개수가 기대치와 맞는지, 최적화된 파일을 다시 읽었을 때도 여전히 파싱되고 렌더링되는지입니다. 여러분의 실제 운영 파일 표본에 대해 이 생성-최적화-재로드 루프를 재현해 보고 전후의 추출 텍스트를 비교하는 데 드는 한 시간은, 고객이 깨진 인보이스를 열기 훨씬 전에 통합 실수를 잡아내는 투자입니다
// 왕복 검사: 최적화된 파일이 여전히 깨끗하게 로드되어야 합니다
Lib := TPDFlib.Create;
try
  Assert(Lib.LoadFromFile('merged-report-opt.pdf', '') = 1);
  Assert(Lib.GetPageCount > 0);
finally
  Lib.Free;
end;
이 파이프라인은 병합 워크플로 어디에 놓일까요? 병합 도중이 아니라 병합 이후입니다. 먼저 병합하고 그 결과 하나를 최적화하면, 임베드된 각 폰트가 원본 파일별로가 아니라 사용된 모든 문자의 합집합에 대해 한 번만 서브셋화됩니다. 병합 처리량이 병목이라면 PDF Library for Delphi는 객체 전체 파싱을 피하는 바이트 수준 고속 경로를 제공하며 이는 바이트 참조 시프팅을 이용한 빠른 PDF 병합에 관한 글에서 설명합니다. 메모리에 통째로 담기에 너무 큰 입력이라면 대용량 PDF를 위한 직접 접근 병합과 분할이 스트리밍 경로를 다룹니다. 둘 다 병합 결과에 마지막 최적화 패스를 더하는 방식과 자연스럽게 어울립니다
세 패스가 하지 않는 일
losLab PDF Library의 최적화 3종은 문서의 의미를 바꾸는 일은 의도적으로 제외합니다. SubsetEmbeddedFonts는 병합된 원본들에 걸쳐 중복된 폰트를 하나의 프로그램으로 통합하지 않고 각각을 따로 줄입니다. 중복 제거는 별개의, 더 위험한 변환입니다. DownsampleImages는 사람이 보기에 프레임에 비해 과도하다고 판단할 수 있는 이미지라도 보수적인 DPI 추정치가 임계값 아래에 머물면 그냥 지나칩니다. 그리고 어떤 패스도 문서 구조를 건드리지 않으므로, 고아 객체 수천 개로 부풀어 오른 파일에는 이런 스트림 수준 패스가 아니라 재작성 방식의 저장이 필요합니다. 그 한계 안에서 폰트 서브셋화, 이미지 다운샘플링, LZW-Flate 정규화의 조합은 PDF 비대화의 고전적 원인 셋을 각각 예측 가능한 API 호출 하나로 제거합니다. 이 세 함수는 위에서 다룬 병합, 추출, 렌더링 API와 함께 Delphi, C# 및 VB.NET용 losLab PDF Library의 일부로 제공됩니다