PDF 를 이어 붙이는 일은 싸야 할 것처럼 들립니다. page content 는 이미 배치되어 있고, font 는 이미 임베드돼 있으며, image 는 이미 압축돼 있습니다. 원칙적으로 병합은 bookkeeping 입니다. object 번호가 충돌하지 않도록 다시 매기고, page tree 를 잇고, cross-reference table 을 고친 뒤 쓰면 됩니다. 하지만 실제 구현의 대부분은 이 값싼 작업을 스스로 비싸게 만듭니다. 각 입력 파일의 각 object 마다 전체 parse 를 수행해 tokenized object tree 로 올리고, 간접 참조 몇 개를 바꾼 뒤, 다시 byte 로 직렬화합니다. 비싼 부분은 parse 와 reserialize 이고, 대부분의 object 에서 그 결과는 원본과 거의 같은 byte 열일 뿐입니다
PDF Library for Delphi 는 Delphi 와 C++Builder 용 native Object Pascal PDF engine 이며, fast merge path 는 바로 그 왕복을 안전하다고 증명되는 곳에서 건너뛰기 위해 존재합니다. 아이디어는 좁지만 문서 집합 전체에서 효과가 큽니다. 수정되지 않은 non-stream object 라면 원본 source byte 를 그대로 취하고, 그 안에 포함된 indirect reference 에 대해서만 바이트 수준 rewrite 한 번을 수행합니다. 모든 N G R 를 (N+Offset) G R 로 바꾸는 것입니다. tokenizer 도 없고, object tree 도 없고, serializer 도 없습니다. 이 글은 그 지름길이 어디까지 합법적인지, 무엇도 깨뜨리지 않고 그 byte rewrite 를 수행하는 parser state machine, 왜 bookmark 병합은 전혀 다른 메커니즘이 필요했는지, 그리고 일반 merge path 가 같은 시기에 어떻게 quadratic 에서 linear 로 재구성되었는지를 다룹니다
object renumbering 이 병합의 진짜 비용인 이유
이 이동이 body 병합의 핵심 의미 작업 전체입니다. page tree 수정과 AcroForm 병합은 몇 개 object 에 대한 작고 경계가 분명한 변경일 뿐입니다. 큰 비용은 수천 개 object 전체에 걸친 reference rewrite 이고, 순진한 방법은 구조적으로 reference 를 찾기 위해 각 object 를 파싱하는 것입니다. PDF Library for Delphi 의 MergeFileListFast 는 정반대 관점을 취합니다. reference 는 raw byte 안에서도 찾을 수 있으며, 단지 digit-space-digit-space-R 형태가 reference 가 아닌 맥락을 조심하면 됩니다. parse 를 생략하고 제자리에서 shift 하면, object 당 비용은 어차피 복사해야 하는 byte 에 대한 선형 스캔 한 번으로 줄어듭니다
모든 PDF 는 각자 자신의 object numbering space 를 가집니다. 파일 A 에도 object 1, object 2 가 있고, 파일 B 에도 object 1, object 2 가 있습니다. B 의 object 를 그대로 A 의 파일 안에 떨어뜨릴 수는 없습니다. 번호가 충돌하고, B 내부의 모든 indirect reference 가 이제 완전히 엉뚱한 object 를 가리키게 되기 때문입니다. 해결은 offset 입니다. A 의 object count 끝이 Offset 이라면, B 의 object N 은 출력에서는 object N+Offset 이 되고, B 의 object 안 어디에 있든 모든 N G R 참조 역시 (N+Offset) G R 로 이동돼야 합니다
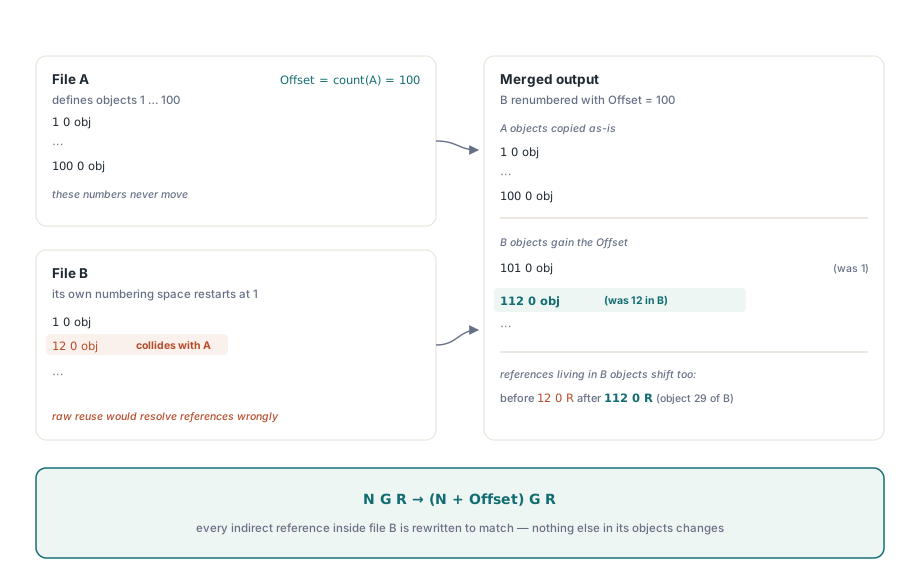
source byte 재사용이 증명 가능하게 안전한 경우
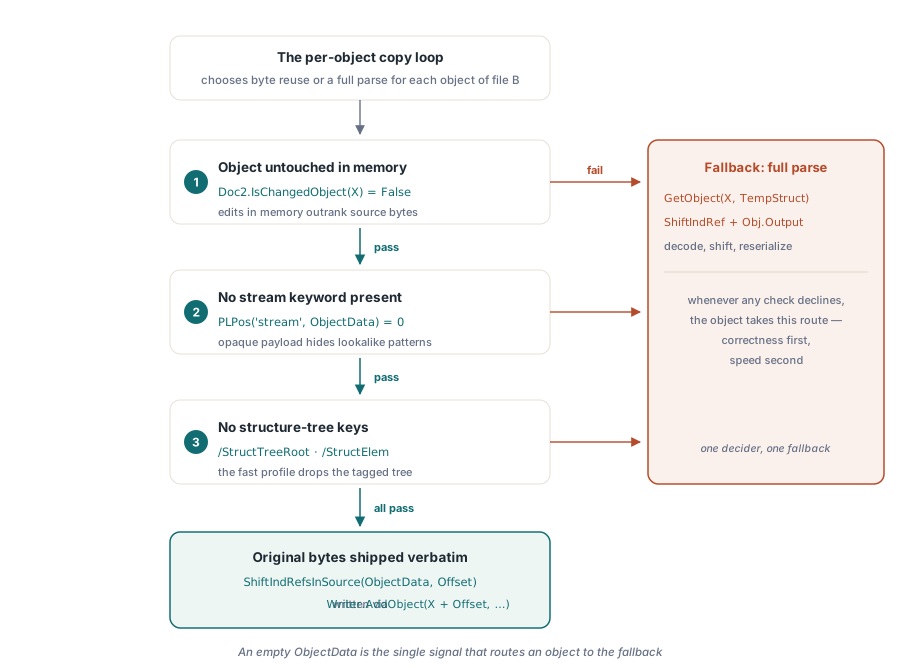
byte path 는 뒤에 오는 문서에서 복사하는 object 에 대해 세 조건이 모두 참일 때만 선택됩니다. 하나라도 실패하면 object 는 full decode-and-reserialize 경로로 되돌아가며, 언제나 정확성이 속도보다 우선합니다
Doc2.IsChangedObject(X)가 False 이어야 합니다. 병합 엔진이 이미 object 를 메모리에서 바꿨다면, 예를 들어/Parent가 다시 연결된 page object 라면, 메모리 안 object tree 가 source of truth 이고 원래 byte 는 stale 합니다. 손대지 않은 object 만 자격이 있습니다- source byte 안에
streamkeyword 가 없어야 합니다. stream object 의 body 는stream/endstream으로 둘러싸인 opaque binary 이고, 압축되거나 암호화된 stream data 를 순진하게 스캔하면 reference 처럼 보이는 byte pattern 을 잘못 찾아 망가뜨릴 수 있습니다. stream object 는 원래의 stream-aware path 로 남깁니다 - source byte 안에
/StructTreeRoot나/StructElem이 없어야 합니다. fast profile 에서는 tagged-PDF structure tree 를 병합하지 않고 떨어뜨리므로, 이 object 들은 decode path 로 가서 엔진이 명시적으로 null 처리할 수 있어야 합니다
이 결정은 object 단위 copy loop 안에 있습니다. 세 검사가 모두 통과하면 object byte 는 곧바로 ShiftIndRefsInSource 로 가서 writer 로 들어가고, 그렇지 않으면 버려진 뒤 GetObject 로 object 를 다시 만들고, ShiftIndRef 로 이동시킨 다음 직렬화됩니다. 분기 구조 자체가 중요합니다. 체크 순서가 바로 이 경로를 안전하게 만들기 때문입니다
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // decode로 폴백
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // 전체 parse 경로
  // … struct-tree 객체, ShiftIndRef, Obj.Output을 null로 설정 …
end;
빈 ObjectData 는 byte path 가 이 object 를 거부했다는 signal 입니다. 이 sentinel 하나가 fast 와 slow route 가 서로 드리프트하지 않게 해 줍니다. 결정 지점은 하나이고, fallback 도 하나뿐입니다
reference-shifting state machine 과 그 edge case
indirect reference 를 byte 수준에서 rewrite 하는 일은 보기보다 쉽게 틀립니다. R 과 숫자 연속은 PDF object 안의 여러 맥락에 등장하지만, 그 모두가 reference 는 아닙니다. ShiftIndRefsInSource 는 바이트를 한 번만 훑는 작은 수기 scanner 이며, number 뒤에 PDF whitespace 를 사이에 두고 또 다른 number 와 R delimiter 가 뒤따를 때만 그 number 를 rewrite 합니다. 값싼 조기 종료가 먼저 옵니다. offset 이 0이거나 source 가 비어 있으면 scanner 안으로 들어가지 않고 byte 를 그대로 돌려줍니다
scanner 의 정확성은 reference 처럼 보이지만 건드리면 안 되는 맥락을 인식하는 데 달려 있습니다. 가장 놓치기 쉬운 경계들은 각각 명시적으로 처리됩니다
- Literal strings 는
(와)사이에 있을 때 그대로 복사되며, escaped parenthesis 가 depth count 를 흐트러뜨리지 않도록 backslash escape 와 nesting depth 를 추적합니다.(see object 3 0 R for details)같은 문자열은 교과서적인 reference pattern 을 담고 있지만 실제로는 prose 이므로 byte-for-byte 로 살아남아야 합니다 - Hexadecimal strings 는
<와>사이에서 해석 없이 통과합니다. hex string 안의52는 ASCII 코드R이고, hex payload 를 텍스트처럼 취급하는 scanner 는 phantom reference 를 만들어 낼 수 있습니다. dictionary 시작인<<는 먼저 감지하여 dictionary 를 hex string 으로 오인하지 않게 합니다 - Name objects 는
/로 시작하면 다음 whitespace 또는 delimiter 까지 통째로 소비됩니다. 이것이 없으면/R같은 이름이, 흔한 resource key 임에도, reference 의R로 읽힐 수 있습니다 - Comments 는
%로 시작하면 줄 끝까지 opaque text 로 건너뜁니다 - number-then-R 판정은 엄격합니다. reference 는 오직
NwhitespaceGwhitespaceR형태이고, 그R뒤도 whitespace, delimiter 또는 입력 끝이어야 합니다. generation number 가 빠졌거나R뒤에 문자가 붙어 있으면 숫자는 그대로 방출됩니다. 그래서/Length 1234의 정수나MediaBox의 네 숫자는 몰래 증가하지 않습니다
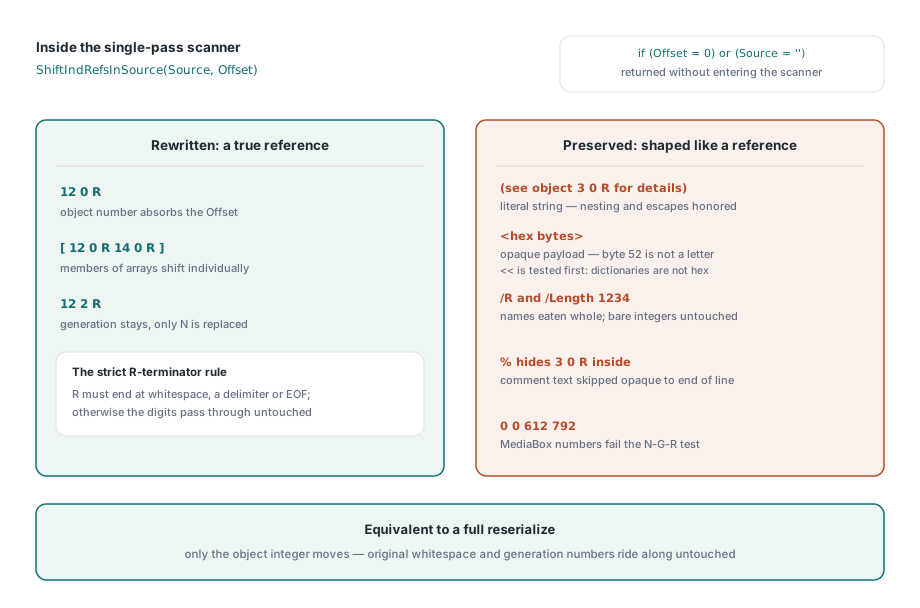
이 엄격한 판정의 핵심은 거의 사양 문장 그대로 읽히는 코드입니다
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // 이동된 object number
  AppendBytes(E1, P - E1);                 // original whitespace + generation
  AppendBytes(P, 1);                       // the 'R'
end;
rewrite 되는 것은 object number 하나뿐입니다. generation number 와 token 사이의 원래 whitespace 는 그대로 복사됩니다. 그래서 출력은 바뀌어야 하는 그 정수 하나를 제외하면 입력과 byte-identical 합니다. 바로 이 정밀함이 핵심입니다. source byte 재사용이 full reserialize 와 대충 비슷한 것이 아니라, 실질적으로 동등해지는 이유입니다. 이 scanner 를 직접 쓰게 된다면 bare reference, array 안의 reference, non-reference number, literal string, hex string, offset 을 적용한 non-zero generation number를 상대로 시험해 보세요
왜 bookmark 는 AppendOutline 을 재사용할 수 없었는가
여러 문서의 bookmark 를 하나의 outline tree 로 병합하는 일은, 기존 AppendOutline helper 를 쓰면 될 것처럼 보입니다. 이 함수는 이미 한 문서의 top-level bookmark 를 다른 문서에 graft 하는 법을 알고 있기 때문입니다. 그러나 여기에는 미묘한 layering mismatch 가 있어 잘못된 도구입니다. AppendOutline 은 reader 가 원본 파일 byte 를 걸으며 현재 마지막 top-level bookmark 를 찾습니다. 반면 fast merge 는 편집 내용을 ChangeObject 를 통해 new-objects buffer 에 staging 합니다. reader 는 이 변경을 전혀 보지 못합니다. 세 문서 이상을 잇는 순간, 각 append 는 첫 번째 문서의 원래 마지막 bookmark 를 최신 문서로 다시 연결하게 되고, 중간 문서 bookmark 들은 chain 에서 빠져 버립니다. 누적된 /Count 만 맞기 때문에, 북마크 패널을 열기 전까지는 버그가 숨어 버리기 쉽습니다
fast path 는 이를 두 단계 metadata 기반 injection 으로 해결하며, reader 를 다시 걷지 않습니다. 첫 번째 pass 는 모든 입력에 대해 outline root object 와 generation number, 첫 번째와 마지막 top-level bookmark 번호, 그리고 root 의 /Count 를 모읍니다. 이 요약에서 각 문서 top-level 의 /Parent 를 공유 root 로, 첫 bookmark 의 /Prev 를 이전 문서의 마지막 bookmark 로, 마지막 bookmark 의 /Next 를 다음 문서의 첫 bookmark 로 연결하는 데 필요한 global object number 를 순수 산술만으로 계산합니다. 여기에는 write-ordering 제약도 있습니다. 첫 번째 문서 object 들은 뒤 문서를 열기 전에 먼저 써 버리므로, 첫 문서의 outline 수정, 즉 root /Count 와 /Last, 그리고 예전 마지막 bookmark 의 /Next 는 뒤 문서가 없어도 표현 가능한 산술이어야 합니다. 뒤따르는 문서의 수정은 문서를 연 뒤, 그러나 write 전에 제자리에서 적용되므로 같은 change-object path 를 따라 나갑니다
모든 것을 묶는 offset 정렬 불변식
reference shift 와 bookmark injection 은 모두 하나의 산술 불변식에 의존하며, 설계 전체에서 가장 깨지기 쉬운 가정이기도 합니다. 뒤 문서에 주입되는 reference 는 target global object number 에서 그 문서의 Offset 을 뺀 값 으로 기록됩니다. 이후 object 가 ShiftIndRef(Offset) 를 거칠 때 비로소 의도한 global number 로 도착하게 만들기 위해서입니다. 첫 번째 문서는 Offset = 0 이므로 global number 를 그대로 씁니다. 이 뺄셈이 맞으려면, injection 시 사용한 running offset sequence 와 실제 object write-out 에 사용한 offset sequence 가 동일해야 합니다
그 동일성이 유지되는 이유는 page 와 form merge 방식에 있습니다. AddPages, AddFields, AddFieldFonts 는 첫 번째 문서의 기존 object 만 수정할 뿐, 새로운 object 를 만들지 않습니다. 따라서 page-merge 단계 전후로 첫 번째 문서의 object count 는 변하지 않고, 각 뒤 문서의 offset, 즉 앞선 모든 문서 object count 의 합도 injection 시점과 write-out 시점 사이에서 안정적으로 유지됩니다. 이 불변식이 깨지는 순간, 예를 들어 merge 중간 단계가 새 object 를 만들기 시작하면, 이후의 모든 page 와 bookmark reference 는 추가된 object 수만큼 어긋나게 됩니다. 조용하지만 완전히 하중을 지는 가정입니다
하나의 엔진 위에 놓인 세 개의 entry point
fast path 는 merge 코드의 별도 포크가 아닙니다. byte-level engine 은 하나의 내부 루틴인 MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode)이고, 공개 API 는 두 개의 flag 를 고르는 얇은 wrapper 입니다:
MergeFileListFast는 structure-tree preservation 을 끈 채 엔진을 호출합니다. tagged-PDF tree 를 버려 더 많은 object 에 byte route 가 적용되도록 하는 가장 가벼운 경로입니다MergeFileList는 preservation 을 켜고 호출합니다. structure tree 가 살아남아 결과가 여전히 usable tagged PDF 가 되며, multi-document bookmark 와 form merge 도 함께 계승합니다MergeFileListStrict는 strict mode 를 켭니다. 첫 metadata pass 에서 clean merge 가 아닌 입력을 만나면 거기서 멈추므로, 잘못된 파일을 건너뛰고 계속하는 대신 그 이전까지 수집된 문서만 결과에 포함됩니다
세 경로가 하나의 engine 을 공유하므로, 일반 merge 역시 각 입력을 한 번만 여는 단일 선형 pass 로 돕니다. 파일 1과 2를 병합하고 그 결과를 3과 다시 병합하는 식으로, 커지는 accumulator 를 매 단계 다시 파싱하는 pairwise O(N²) 루프가 아닙니다. 두 파일 및 두 stream 용 entry point 인 MergeFiles 와 MergeStreams 는 실제로 pairwise merge 가 필요한 호출자를 위해 계속 제공됩니다
structure-tree 동작에 대해서는 한 가지 짚어 둘 가치가 있습니다. 출력을 byte 로 들여다보며 검증한다면 중요하기 때문입니다. fast path 가 tree 를 drop 하는 방식은 첫 번째 문서 catalog 의 /StructTreeRoot 참조를 제거하는 것이고, structure-tree object 자체는 참조 없이 여전히 출력에 기록됩니다. 그래서 fast output 의 byte 안에도 /StructTreeRoot 문자열이 그대로 있고, 문자열 검색만으로 fast 와 ordinary output 을 구분할 수 없습니다. 진짜 차이는 catalog 가 아직 structure tree 에 도달하느냐이며, 파일이 여전히 navigable tagged PDF 인지를 결정하는 것은 바로 그 부분입니다
어떤 경로를 언제 써야 하는가
byte path 는 tagged-PDF structure tree 보존이 필요 없는 많은 문서를 조립할 때를 위한 throughput 최적화입니다. 보고서 묶음, 명세서 작업, batch concatenation 같은 경우입니다. 중대형 입력 집합을 반복 병합해 측정한 결과, byte 재사용은 object mix 에 따라 대략 4퍼센트에서 13퍼센트 정도의 wall-clock 시간을 줄여 주고, scanner 가 안전함을 증명할 수 없는 object 는 전부 full parse 로 되돌아가므로 작은 입력이나 비정상 입력은 full path 와 똑같이 동작합니다. 접근성을 위해 structure tree 를 그대로 보존해야 한다면 tree 를 유지하는 일반 tagged-PDF merge path 를 사용하고, 많은 입력이 아니라 매우 큰 단일 파일을 다루는 경우라면 companion piece 인 직접 파일 접근을 이용한 대용량 PDF merge 및 split 에서 설명한 byte-copy 기법이 같은 "byte 를 복사하고 전체 object tree 는 피한다" 철학을 파일 규모로 적용합니다
이 merge routine 과 fast 및 strict variant 는 PDF Library for Delphi Delphi PDF Library 의 일부이며, 문서에는 여기서 설명한 file-list API 와 merge option 의 전체 reference 가 정리되어 있습니다