両端揃えの本文のページが、空白ベースの表検出器から、複数列のグリッドとして返ってくることがあります。どのセルも途中で切れた半文を抱え、信頼度スコアは設定しそうなどんなしきい値よりもはるかに上です。そのページに表はありません。検出器が見つけたのは、列区切りと見まがうほど広い単語間の空白と、その空白がほぼ同じ X 位置に着地する連続数行であり、整列だけを見れば、それはまさに表の姿です。答えは、列境界を1行ごとに判定するのをやめ、列と列のあいだに、何もない紙の帯がページを下まで走っているかを問うことです
両端揃えのテキストはなぜ空白テーブル検査を通ってしまうのか
両端揃えのテキストが通ってしまうのは、両端揃えの行が、レイアウトエンジンが引き伸ばした空白で区切られた単語の並びであり、引き伸ばされた空白が列のしきい値を越えた瞬間から、その1行だけでは列間と区別するものが何もないからです。PDFium Component の空白戦略は、たいていの空白検出器と同じ働き方をします。TPdf.ExtractTables は単語ボックスを視覚的な行にまとめ、ある単語から次の単語までの水平距離が MinColumnGap(TPdfTableExtractionOptions.Default では12ポイント)以上のところで各行を単語グループに分割し、できた単語グループの左端を AlignmentTolerance(既定3ポイント)以内で列アンカーにクラスタリングします。アンカーが生き残れるのは、少なくとも MinRows 行で繰り返されるときだけ、候補のすべての行は少なくとも MinColumns 個の異なるアンカーに当たらなければなりません。本物の整列した表に対してはこの規則は正しく、表の検出の概要で述べた規則でもあります
散文側の算数は、見た目よりも融通がききません。180ポイントのニュースレター列の10ポイントの行が、次の単語が入らないせいで右マージン手前30ポイントで終わり、単語が長いせいで行内の語間空白が3つしかないとします。両端揃えエンジンはその30ポイントを3つの空白に振り分けるので、それぞれがおよそ2.5ポイントから12.5ポイントへ育ち、既定の MinColumnGap を越えます。2行目に必要なのは、次の単語が1行目のそれの3ポイント以内から始まる、引き伸ばされた空白が1つだけです。それで検出器は2行2列の候補を手にします
引き伸ばしがどうエンコードされるかは問題ではありません。ISO 32000-1 §9.3.3 は、ワードスペーシング(Tw)をシングルバイトの文字コード32にしか適用しないので、マルチバイトフォントを使うプロデューサーはたいてい、TJ 配列(§9.4.3)の数値調整で単語を配置します。どちらでも、単語ボックスは同じ形で出てきます。各段落の最終行は不揃いのままで、普通の空白を運びます。だから誤検出は段落の本体を覆い、終わりの1行手前で止まりがちです
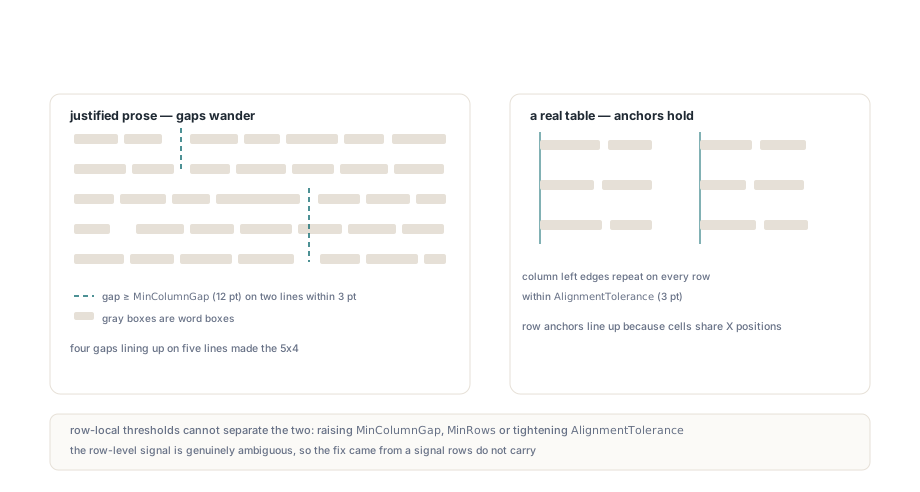
自分のコーパスを手早く調べるには、手紙やプレスリリースのように散文しかないと分かっている文書に検出器を走らせ、報告された whitespace モードの表をすべて印字します。そこでの期待される出力は、何もないことです
uses
  SysUtils, PDFium;

//  ロード済み文書内の whitespace 整列表をすべて列挙し、
//  散文だけだと分かっているページを手早く確認できるようにする
procedure ReportWhitespaceTables(Pdf: TPdf; MinRows: Integer = 2);
var
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Options := TPdfTableExtractionOptions.Default;  //  MinColumnGap 12、AlignmentTolerance 3
  Options.MinRows := MinRows;
  Tables := Pdf.ExtractDocumentTables(Options);   //  アクティブページを復元する
  for I := 0 to High(Tables) do
    if Tables[I].DetectionMode = ptdmWhitespace then
      Writeln(Format('page %d: %dx%d whitespace table, confidence %.2f, ' +
        'first cell "%s"',
        [Tables[I].PageNumber, Tables[I].RowCount, Tables[I].ColumnCount,
         Tables[I].Confidence, Tables[I].Cells[0].Text]));
end;
しきい値それぞれの代償
行レベルのしきい値はどれも、ある文書クラスを別の文書クラスと引き換えにします。だからこの問題では、しきい値には手を付けないのが道理です。MinColumnGap を20ポイントに上げると、高密度の財務諸表の詰まった列が失われます。ラベル列と値のあいだの列間が、既定値とほとんど変わらない幅しかないことが多いところです。MinRows を3に上げると、本物の2行の表が捨てられ、長い段落の確率が下がるだけです。散文の1ページは、3行が揃う機会をいくらでも提供します。AlignmentTolerance を3ポイント未満に締めると、左端が少し揺れる本物の列が分割され始めます。OCR テキストレイヤーの載ったスキャンページでは、それが起こります
MinConfidence は自然なフィルタに見えて、4つの中で最も弱いものです。PDFium Component の whitespace 表は、0.58 に非空セルの割合の0.30倍を足し、0.88 で頭打ちのスコアを持ちます。スコアが測るのは、グリッドの埋まり具合です。段落の断片はすべてのセルを埋めるので、散文の誤検出は範囲のほぼ上限を採点し、空白セルのある本物の表はその下になります
2行の両端揃え散文と、2列の表の2行は、同じアンカーの上に同じ単語グループを作れます。両者を分ける証拠は、行のあいだに座っています
本物の列境界は垂直回廊である
本物の列境界とは、それが隔てるすべての行にわたってテキストのないままの、ページの垂直の帯です。表では、セルが共有の X 位置に対して配置されているため、構造として各列の組のあいだに1本あります。両端揃えの段落は行ごとに違う水平位置で空白を引き伸ばすので、1、2行を超えて生き残る帯はありません。PDFium Component は、候補の単語グループがアンカー列に割り当てられた後で、まさにこれを検査します。隣り合う列の組ごとに、両方のセルに内容があるすべての行が、左セルの単語の最右端から右セルの単語の最左端までの区間を提供し、区間は行をまたいで交差させられ、交差が MinColumnGap の半分より狭ければ — 既定では6ポイント、候補全体が拒否されます
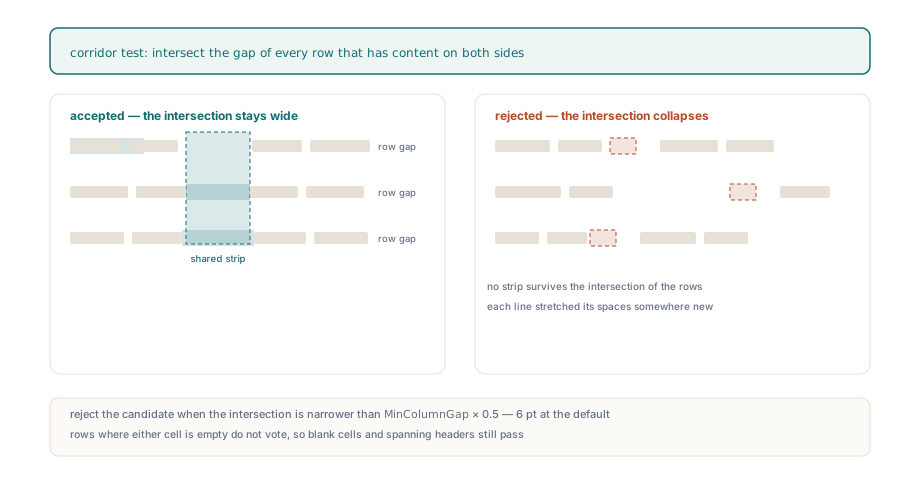
扱いにくい本物の表では、2つの詳細が効きます。どちらかのセルが空の行は投票しないので、空白セルを持つ表や、本文より少ない列にまたがるヘッダー行も通ります。そして回廊の幅は、別のオプションではなく MinColumnGap から導かれます。両者は同じ物理的なもの、設計者が列間に残す空白を記述しているからです。半分にすることで、左列の長い項目が次の列に近づく行のぶんの余地が残ります
検査は、自分のレイアウトコードで再現できるほど小さいものです。下のセルリストは自分の構造で、行優先順のセルごとの単語インデックス配列です
uses
  Math, PDFium;

type
  TIndexList = array of Integer;
  TCellIndexes = array of TIndexList;   //  Row * ColumnCount + Column

//  隣り合う列の組が、それを使う行にわたってMinColumnGap / 2以上の幅の
//  テキストのない垂直回廊を持たない場合にFalseを返す
function HasTextFreeCorridors(const Words: TPdfWordBoxes;
  const Cells: TCellIndexes; RowCount, ColumnCount: Integer;
  MinColumnGap: Double): Boolean;
var
  Col, Row, I, LeftCell, RightCell, Supported: Integer;
  CorridorLeft, CorridorRight, RowLeft, RowRight: Double;
begin
  for Col := 0 to ColumnCount - 2 do
  begin
    CorridorLeft := -MaxDouble;
    CorridorRight := MaxDouble;
    Supported := 0;
    for Row := 0 to RowCount - 1 do
    begin
      LeftCell := Row * ColumnCount + Col;
      RightCell := LeftCell + 1;
      if (Length(Cells[LeftCell]) = 0) or (Length(Cells[RightCell]) = 0) then
        Continue;                             //  空のセルは投票しない
      RowLeft := -MaxDouble;
      RowRight := MaxDouble;
      for I in Cells[LeftCell] do
        RowLeft := Max(RowLeft, Words[I].Rect.Right);
      for I in Cells[RightCell] do
        RowRight := Min(RowRight, Words[I].Rect.Left);
      CorridorLeft := Max(CorridorLeft, RowLeft);
      CorridorRight := Min(CorridorRight, RowRight);
      Inc(Supported);
    end;
    if (Supported > 0) and
       (CorridorRight - CorridorLeft < MinColumnGap * 0.5) then
      Exit(False);
  end;
  Result := True;
end;
罫線表を空白パスから締め出す
空白パスがページ上のすべての単語を見るなら、罫線表は2回見つかることになります。きれいな罫線表は、構造として完全に整列した空白表でもあるからです。半分超えの重なり規則だけでは、罫線表の下段の行と、その下の整列した数行のテキストを合わせた候補が、比率を下回ったまま生き残り、隣にはみ出す2つ目の、より大きな表として出てきます
そこで、DetectRuledTables と DetectWhitespaceTables の両方が入っているとき(これが既定)、ExtractTables はまず罫線パスを走らせ、空白パスが始まる前に、中心点が罫線表の境界の内側にある単語をすべて取り除きます。完全な包含ではなく中心を使うのは、罫線をポイントの何分の一かまたぐ単語が、視覚的に属する表に従うようにするためです。こうして空白戦略が見るのは自由な単語だけで、罫線グリッドのすぐ下に座る小さな罫線なしの表は、自分の行だけで判定されます
なぜ「Purpose of Request:」が「of Purpose Request:」になるのか
「同じ行」を判定するコードが垂直の中心を比べていると、セル内の単語は間違った順序で出てきます。グリフボックスから組み立てられた単語ボックスは、ベースラインを共有していても中心を共有しないからです。FPDFText_GetCharBox が返すのは、ページ空間における各グリフのインクのタイトなボックスであって、フォントのアセントとディセントまで広げたボックスではありません。そして単語ボックスは、その文字ボックスの合併です。「Purpose of Request:」のようなフォームラベルでは、「Purpose」と「Request:」がディセンダーを持ち、「of」は持ちません。だから「of」のボックスは短く、中心は2、3ポイント高く座ります。中心 Y で(同一行の許容値1ポイントで)ソートし、次に左端でソートするルーチンは、「of」を他の2つの上の自分専用の行に置き、最初に出力します
PDF に近道はありません。ISO 32000-1 §9.4.4 はグリフをベースラインに沿った変位で配置し、ファイルが運ぶ垂直メトリクスはフォント単位だけです。フォントディスクリプター(§9.8.1)の Ascent、Descent、FontBBox です。2つのグリフが行を共有するとはどこにも書かれていません。PDFium の char box によるテキスト行選択で述べた、選択ハイライトを正しく見せるタイトなボックスは、中心距離の比較には貧弱な入力です
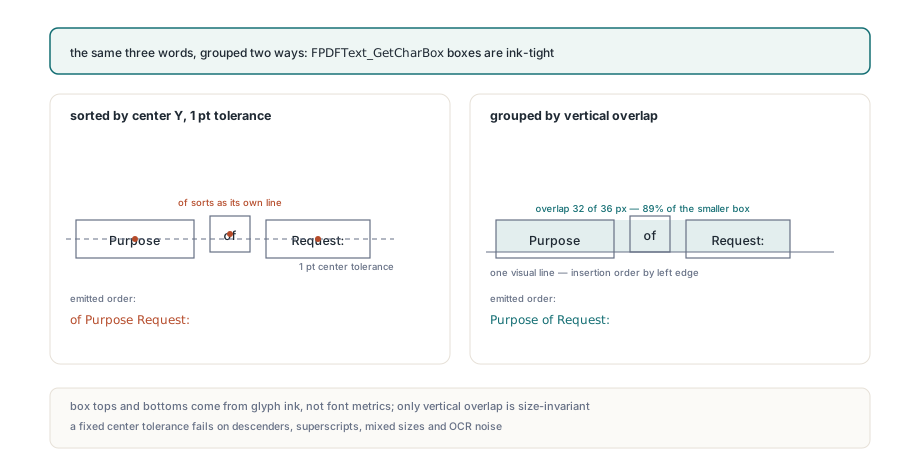
PDFium Component はその代わり、重なりでセルテキストを組み立てます。単語は、行の走行境界との垂直の重なりが2つの高さの小さいほうの25%以上のとき、あるいは2つの中心が互いに1ポイント以内のとき、視覚的な行に加わります。各行はその後、左端でソートされ、行は CR LF のペアで結合されます。「Purpose」と「of」は x ハイト全体で重なります。短いほうのボックスの4分の1をはるかに超えるので、両者は同じ行に落ち、順どおりに読めます
自分のコードでもテキスト行を重なりでグループ化する
同じ罠は、固定の許容値に対して中心を比べて「同じ行」を決める、あらゆる PDF レイアウトコードで待ち構えています。ディセンダーは最も軽い引き金です。小さい値の隣の太字ラベル、上付きの脚注記号、ノイズの多い OCR ボックスはどれも、12ポイントの行送りで10ポイントテキストの隣接行をまだ分離できるどんな許容値よりも大きく、中心を動かします。重なり比率はサイズを気にしません。同じベースライン上の2つのボックスは共有の x ハイトで重なり、隣接行の2つのボックスはまったく重なりません
TPdf.PageWordBoxes は、アクティブページのすべての単語を、ページ空間の矩形を Rect に入れて返します。だからページを視覚的な行にグループ化するのは、1つの述語と短いループで済みます
uses
  Math, PDFium;

function SameVisualLine(const A, B: TPdfRectangle): Boolean;
var
  Overlap, MinHeight: Double;
begin
  Overlap := Min(A.Top, B.Top) - Max(A.Bottom, B.Bottom);
  MinHeight := Min(A.Top - A.Bottom, B.Top - B.Bottom);
  Result := (MinHeight > 0) and (Overlap >= MinHeight * 0.25);
end;

procedure GroupPageIntoLines(Pdf: TPdf; out Lines: TArray<TPdfWordBoxes>);
var
  Words: TPdfWordBoxes;
  Bounds: TArray<TPdfRectangle>;   //  行ごとの中間的な合併
  I, J, Found: Integer;
begin
  Words := Pdf.PageWordBoxes;            // アクティブページ(Pdf.PageNumber)が必要
  Lines := nil;
  Bounds := nil;
  for I := 0 to High(Words) do
  begin
    Found := -1;
    for J := High(Lines) downto 0 do
      if SameVisualLine(Bounds[J], Words[I].Rect) then
      begin
        Found := J;
        Break;
      end;
    if Found < 0 then
    begin
      SetLength(Lines, Length(Lines) + 1);
      SetLength(Bounds, Length(Bounds) + 1);
      Found := High(Lines);
      Bounds[Found] := Words[I].Rect;
    end;
    SetLength(Lines[Found], Length(Lines[Found]) + 1);
    Lines[Found][High(Lines[Found])] := Words[I];
    Bounds[Found].Left := Min(Bounds[Found].Left, Words[I].Rect.Left);
    Bounds[Found].Right := Max(Bounds[Found].Right, Words[I].Rect.Right);
    Bounds[Found].Top := Max(Bounds[Found].Top, Words[I].Rect.Top);
    Bounds[Found].Bottom := Min(Bounds[Found].Bottom, Words[I].Rect.Bottom);
  end;
  //  読み出す前に各行をRect.Leftでソートする。PageWordBoxesは単語を
  //  コンテンツストリーム順で返し、それが視覚順である保証はない
end;写す価値があるのは述語の部分です。手早いダンプを越えたものには、ブロックと行と読み順の情報源を既に備えた構造化テキストモデルから始めてください。読み順つきの構造化 PDF テキスト抽出で述べています
表の呼び出し側がまだ制御できるもの
表の呼び出し側は、オプションに触れずに、回廊テストと罫線優先の単語フィルタと重なりベースのセルテキストを受け取ります。回廊のしきい値は MinColumnGap の半分に固定されているので、列間の幅のために調整する1つの値が両方を支配します。空白戦略は、MinRows が1に設定されても、2行の下限を保ちます。1行のグリッドを受け付けるのは罫線戦略だけで、ExtractDocumentTables はそれを、ページ先頭に続く表の断片に使います。同じオプションレコードは TPdfReflowOptions.TableOptions へも渡るので、DetectTables が入っていれば、リフロー出力は同じ決定を引き継ぎます
回廊テストが判定に使うのは、境界の両側に内容がある行なので、2行の候補は、そのようなわずか2行で判定されます。ほとんど散文で、本物の2行の表をめったに含まないアーカイブ — 契約書、対応記録、エッセイ — では、MinRows を3にして、失われる2行の表を受け入れてください。財務やフォーム中心の文書では、既定の2のままにします。短い本物の表はそこでよく見るからです。右端不揃いのテキストは普通の単一空白を保ち、12ポイント近くの空白を生むことはめったにありません
PDF に汎用の表オブジェクトはありません。ISO 32000-1 §14.8.4.3.4 は Table 構造要素を定義しますが、それを運ぶのはタグ付き PDF だけです。それ以外では、グリッドは幾何からの推測であり、whitespace 表の Confidence が 0.88 を越えることはありません
検出オプション、TPdfTable.ToCsv と ToJson シリアライズ、そして Delphi、C++Builder、Lazarus 向けの TableExtractionLab デモは、PDFium Component for Delphi 製品ページで説明しています