WordやGoogle Docsからエクスポートされた表は、1ページに何百もの罫線片を運びながら、ストロークされた線を1本も持たないことがあります。qpdf --qdfでページを展開すると、コンテンツストリームはre fペアの列のように読め、それぞれが半ポイントの高さのボックスを記述しています。ストロークされたセグメントだけを探す表検出器は何も見つけず、単語を空白の間隔で並べるフォールバックに切り替え、作者がきれいなグリッドを1枚描いた場所に、2、3行の断片の散らばりを返します。罫線は全部そこにあります。塗りで描かれているだけです。だから検出器は塗りつぶし矩形を罫線として読み、ほぼ接している端を共有グリッド線へ引き寄せなければなりません
Wordの表にストロークされた線がない理由
ワープロはセル罫線を幅を持つボックスとして扱い、そのボックスを塗りオペレーターで描きます。ISO 32000-1 §8.5.2.1はreを閉じた矩形サブパスの追加と定義し、§8.5.3は描画オペレーターを分けます。Sは現在の線幅でパスをストロークし、fは内側を塗ります。0.5ポイントの罫線はx y w 0.5 re fとして現れ、ストロークの機構(線幅、接合、破線パターン)は決して走りません。セルの網掛けは、より大きなボックスでの同じ構造です。線指向の検出器が期待するストローク形式、m、l、Sは、オフィスのエクスポートがめったに使わない形式です:
% ワープロ出力のセル罫線1本。高さ0.5 ptの塗りつぶしボックス
72 700 468 0.5 re f
% セルの網掛け。セルと同じ大きさの塗りつぶしボックス
72 676 117 24 re f
% ストローク専用検出器が探すストロークされたグリッド線
72 700 m 540 700 l S
生のPDFium APIの上で自分の検出器を書くなら、最初の草稿はたいていFPDFPath_GetDrawModeを呼び、ストロークフラグが立っているときだけパスを保持し、先へ進みます。上の2つの塗りつぶしボックスはどちらもその検査に落ちます。セル内の単語は空白検出へ届き、コンパクトなエクスポートでは列は6ポイントほどの間隔に座っています。PDFium ComponentのデフォルトのMinColumnGapは12ポイントなので、その列は登録されません。列が登録されるまでMinColumnGapを下げると、両端揃えの段落の引き伸ばされた単語間隔も登録されるようになり、作者が描いたグリッドは決して戻りません。それを定義する情報が塗りつぶしボックスの中に住んでいるからです
PDFium Componentが塗りつぶしボックスを罫線として読む方法
PDFium Componentはページ上のすべてのパスオブジェクトから表の幾何を読みます。1回に1サブパスずつです。TPdfTableExtractionOptions.DetectFilledRulingsはデフォルトでTrueなので、塗りモードがnone以外のパスは、ストロークされたパスと並んで罫線について調べられます。続くフィルターは意図的に厳しいです。塗りつぶされたサブパスが資格を持つのは、4から8の点を持ち、曲線セグメントを含まず、すべての点がサブパス外接ボックスの角に0.05ポイント以内で座るときだけです。reで描かれた矩形は通り、繰り返される角を持つ5つの明示的な点として描かれたものも通ります。三角形、シェブロン、L字型の輪郭、角丸のタブは検査に落ちて何も寄与しません
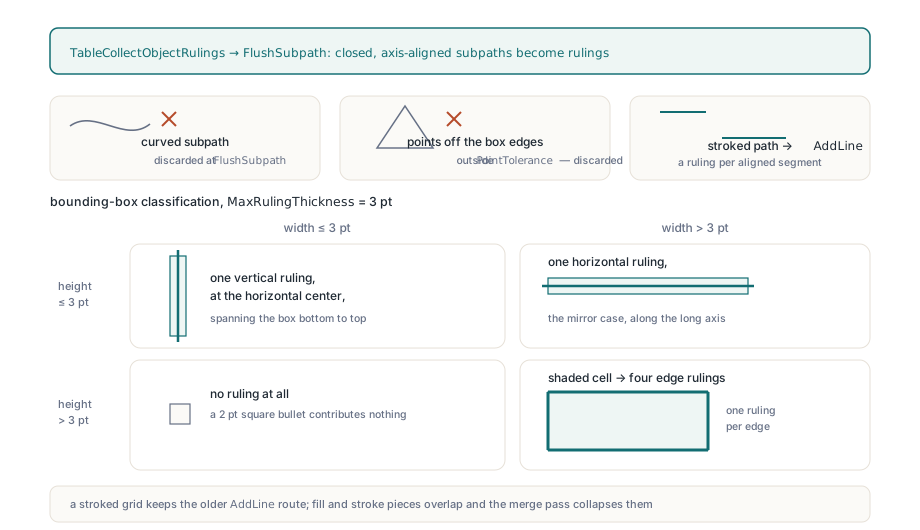
生き残った矩形は外接ボックスで分類され、基準がMaxRulingThickness、デフォルト3ポイントです。幅がしきい値以下で高さが上回る場合、ボックスの全高を走る1本の垂直罫線が水平中心に得られ、鏡像の場合は1本の水平罫線です。両寸法がしきい値を超えると、ボックスは網掛けセルとして扱われ、1辺につき1本、合計4本の罫線を寄与します。両寸法がしきい値以下なら、ボックスは何も寄与しません。リストの中の2ポイントの正方形の弾丸が、テーブルグリッドの断片に化けることは決してないわけです。塗りの色はどれにも関与しません。白いページの上の白いボックスは黒いものと同じ罫線を生みます。だからテーブルサイズの背景パネルが外枠として現れることがあり得るのです
ストロークされたパスは自分の経路を保ちます。端点が1軸上でRulingTolerance(デフォルト1ポイント)以下しか違わないすべての直線セグメントは、もう一方の軸に沿った罫線になり、曲線セグメントはスキップされ、閉じたサブパスの閉じセグメントも数えられます。塗りとストロークの両方で描かれたパスは両方の経路で寄与し、重なる部分は後のマージステップで潰されます。ストロークされた角丸矩形は、まっすぐな辺の罫線を今も与えます。角の弧だけが落ちます。抽出呼び出し自体は特別なセットアップを要しません:
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  Mode: string;
  I, J, WithText: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;
    Pdf.PageNumber := 1;                     // 1始まり

    Options := TPdfTableExtractionOptions.Default;
    // 塗り罫線のフィールド。デフォルト値のまま明示
    Options.DetectFilledRulings := True;
    Options.MaxRulingThickness := 3.0;       // ポイント。0より大きくなければならない
    Options.RulingSnapTolerance := 4.0;      // ポイント。0でスナップを切る
    Options.IncludeFormXObjects := True;

    Tables := Pdf.ExtractTables(Options);
    for I := 0 to High(Tables) do
    begin
      if Tables[I].DetectionMode = ptdmRuled then
        Mode := 'ruled'
      else
        Mode := 'whitespace';
      WithText := 0;
      for J := 0 to High(Tables[I].Cells) do
        if Tables[I].Cells[J].Text <> '' then
          Inc(WithText);
      Writeln(Format('%dx%d %s, confidence %.2f, %d of %d cells hold text',
        [Tables[I].RowCount, Tables[I].ColumnCount, Mode,
         Tables[I].Confidence, WithText, Length(Tables[I].Cells)]));
    end;
  finally
    Pdf.Free;
  end;
end;MaxRulingThicknessを0にしても機能は切り替わりません。ExtractTablesは幾何オプションを事前に検証し、ゼロ以下のしきい値には「Table extraction geometry options are invalid」というメッセージつきのEPdfErrorを上げます。ストロークのみの振る舞いを得るには、DetectFilledRulingsをFalseにします。オフィススイートやブラウザの印刷ダイアログから出てきたものにはオンのままにしてください。厳格な矩形フィルターがコストを低く保つもので、装飾的な塗りはほとんどそれを通らないからです
RulingSnapToleranceは網掛けセルの表に何をするのか
RulingSnapToleranceこそ、網掛けだけから組み立てられた表を1つのグリッドへ連結させるものです。罫線をまったく描かないエクスポートもあります。各セルは、隣と1から3ポイントの白い溝で隔てられた塗りつぶしボックスです。各ボックスは4本の端罫線を生みますが、あるセルの右端と次のセルの左端は、たとえば2ポイント離れて座り、2本の罫線が同じグリッドに属するか決める検査はRulingTolerance、つまり1ポイントしか許しません。スナップなしでは、すべてのセルは1x1グリッドを記述する4本の罫線の島になり、MinColumnsもMinRowsも(どちらもデフォルト2)に届かず、罫線パスは明らかに表のあるページで表を報告しません
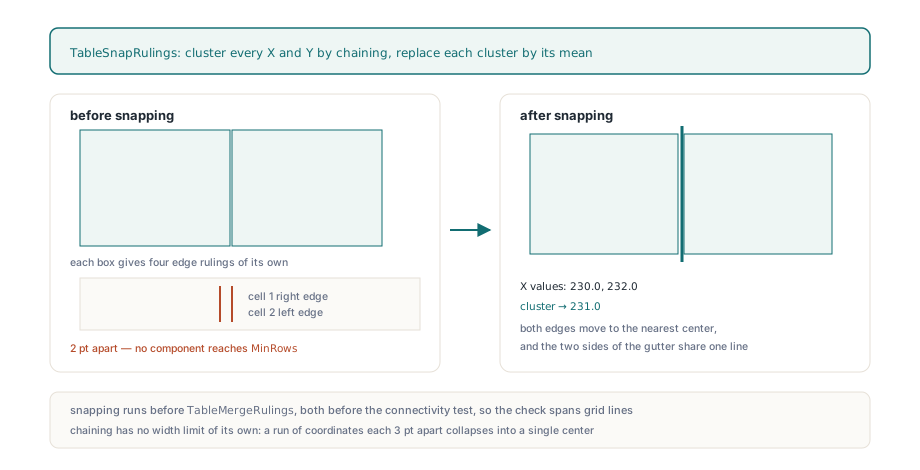
スナップのステップは、登場するすべてのX座標、つまり各垂直罫線の位置と各水平罫線の始点と終点を集め、Y座標も同じように集めます。各リストはソートされ、隣同士が許容値より大きく違うところでクラスタに分割されます。各クラスタはその平均で置き換えられ、すべての位置、始点、終点はその後、最も近い中心へ動きます。230.0と232.0の端はどちらも231.0になり、2つのセルは1本の線を共有し、水平罫線はそれに合わせて伸びて角が出会います
RulingTolerance以内で接するか重なる共線の断片は1本の線へマージされます。その後になって初めてグリッド検出器が走り、罫線をペアごとに比較します。720の罫線片として届いた30行の表は、その比較には数十本の線として到達します
ストロークされたグリッドでは、このステップは何も変えません。もともと一致している座標は自分自身にスナップするからです。問題は、連鎖に独自の幅制限がないことです。100、103、106、109と、それぞれ3ポイント離れた値の連なりは、外側の値が9ポイント離れていても、104.5の1つの中心へ潰れます。4ポイントのデフォルトでは、これは文字より狭い列でしか効かないので、オフィス出力は4ポイントのデフォルトを保てます。意図的に狭い列を持つフォーム(チェックボックス、1桁ずつの口座番号フィールド)では1か2へ下げ、スナップを切るときは0にします。罫線戦略を単独で3つの設定の下で走らせると、ページがどの機構に依存しているか分かります:
// 罫線戦略のみ。空白検出が結果を覆い隠せないように
function CountRuledTables(Pdf: TPdf; FilledRulings: Boolean;
  SnapTolerance: Double): Integer;
var
  Options: TPdfTableExtractionOptions;
begin
  Options := TPdfTableExtractionOptions.Default;
  Options.DetectWhitespaceTables := False;
  Options.DetectFilledRulings := FilledRulings;
  Options.RulingSnapTolerance := SnapTolerance;
  Result := Length(Pdf.ExtractTables(Options));
end;

// 2 ptの溝を持つ網掛けセルだけの表での期待値:
//   ストロークのみ            -> 0  (ストロークされた幾何はまったくない)
//   塗りボックス、スナップ4   -> 1  (溝の端が1本の線を共有)
//   塗りボックス、スナップ0   -> 0  (すべてのセルが1x1の島のまま)
Writeln('stroke only:          ', CountRuledTables(Pdf, False, 4.0));
Writeln('filled boxes, snap 4: ', CountRuledTables(Pdf, True, 4.0));
Writeln('filled boxes, snap 0: ', CountRuledTables(Pdf, True, 0.0));
3つ目のカウントが2つ目より下がったら、そのページはスナップに依存しています。許容値を下げる前に目で確認すべきはそのページです
フォームXObjectの中の罫線
ページレイアウトツールは、表やページ本文全体をフォームXObjectに包み、Doで描くことがよくあります。ISO 32000-1 §8.10.1は、フォームが描かれるときフォーム行列が現在の変換行列と連結されると言います。つまりフォームの中の矩形はフォーム空間で書かれ、2つ以上の変換を経て初めてページ空間に届きます。デフォルトでオンのIncludeFormXObjectsを設定すると、PDFium Componentは各フォームオブジェクトの中へ歩き入り、オブジェクト行列を親の行列と組み合わせ、その組み合わせた行列をすべての子へ渡します。平行移動されたフォームの中の72 700 468 0.5 re fとして描かれた罫線は、ビューアが見せる場所に着地します。この歩行は8レベルのネストしたフォームで止まります
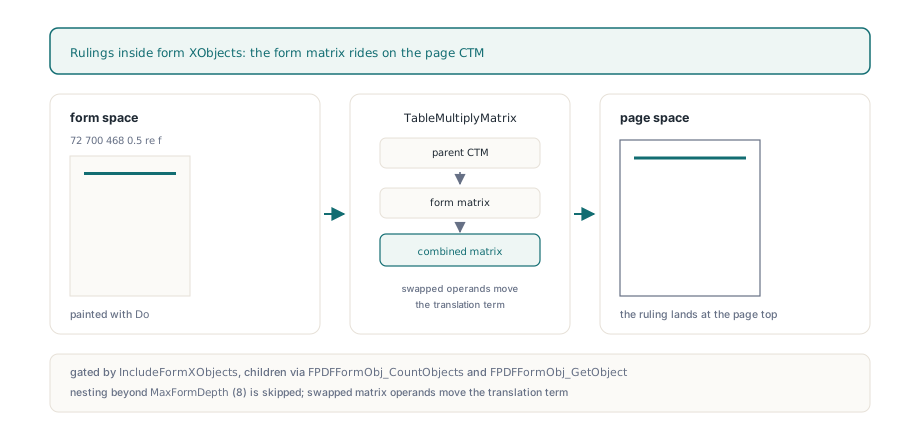
その組み合わせの順序が効いてきます。フォームの中の点はまずオブジェクト行列を通り、次に親の行列を通ります。オペランドを入れ替えると、平行移動の項が間違った空間で適用され、ページの上部に属するはずの罫線が原点の近くやページの外に着地します。同じ罠は自分で行列を組み立てるときはいつでも現れます。行列のprependとappendの記事が、回転のピボットでこの罠を歩いています
罫線の予算のデフォルトが16384なのはなぜか
MaxRulingSegmentsのデフォルト16384は、セルごとの罫線のエクスポートが生む断片の数を反映しています。ストロークされた30行6列の表には38本の線分が要ります。水平31本、垂直7本です。同じ表を塗りつぶしボックスとしてエクスポートすると、セルごとに4つの罫線片、マージ前で720を運べます。さらに全セルの網掛けはセルごとに4本の端罫線を足し、合計1440です。そのような表が1ページに2つあれば、すでに3000近くが要ります
予算の超過はエラーであり、エラーとして現れます。ExtractTablesは「Table ruling-segment budget exceeded」というメッセージつきのEPdfErrorを上げ、部分的なグリッドを返さず、そのページの空白パスも走りません。厳しい予算は信頼できない入力には妥当です。細工されたページは何百万もの小さなボックスを運べるからです。しかしその場合、呼び出し側は「この予算には複雑すぎる」と「このページに表はない」を区別しなければなりません:
function TryExtractTables(Pdf: TPdf; Budget: Integer;
  out Tables: TPdfTables): Boolean;
var
  Options: TPdfTableExtractionOptions;
begin
  Options := TPdfTableExtractionOptions.Default;
  Options.MaxRulingSegments := Budget;     // デフォルトは16384
  try
    Tables := Pdf.ExtractTables(Options);
    Result := True;
  except
    on E: EPdfError do
    begin
      // LogWarningは自前のロギングルーチンで、ライブラリの一部ではない
      LogWarning(Format('Page %d: %s', [Pdf.PageNumber, E.Message]));
      Tables := nil;
      Result := False;                     // 予算超過または無効なオプション
    end;
  end;
end;

// Falseの結果は「未決」を意味する。空配列とは違う
if not TryExtractTables(Pdf, 4096, Tables) then
  QueueForReview(Pdf.FileName, Pdf.PageNumber);  // これも自前のルーチン
同じ例外型が単語の予算と無効なオプションもカバーするので、レビューキューでそれらを区別するのはログされたメッセージです
罫線経路が引き渡す場所
罫線検出が先に走り、空白検出が2番目に走り、2つの規則が互いに踏み合わないようにします。罫線パスがすでに報告したグリッドの内側に中心が落ちる単語は、空白検出が始まる前に取り除かれます。表が2回報告されることはありません。空白の列境界はまた、それが分けるすべての行をまたぐテキストなしの垂直回廊でなければなりません。両端揃えの段落が表として採点されるのを防ぐ規則で、空白表の誤検出の記事がその規則を扱っています。塗りつぶし矩形を読むことで、オフィスエクスポートの表は空白経路から罫線経路へ移されます
罫線はパスオブジェクトから来てテキストはテキストページから来るので、テキストレイヤーのないページでも、すべてのセルが空のグリッドの骨組みを生みます。罫線グリッドの信頼度は0.88プラス0.12掛けるテキストを持つセルの割合なので、空の骨組みはちょうど0.88を報告し、最初のリストのセル数は0と表示されます。この組み合わせが、OCRで検索可能なテキストレイヤーを足すで説明したとおり、まずOCRを走らせるサインです。曲線や矩形以外の輪郭を持つ塗りつぶし図形は何も寄与しないので、セルが塗られた角丸矩形である表は空白検出に落ちます。罫線も網掛けもない表は、表の検出と抽出の記事で述べた空白戦略に属し、それでも足りないときは、構造化テキストと読み順の単語ボックスとブロックが、1つの文書ファミリー向けに書かれたリーダーの原料になります
コンポーネントに同梱されるTableExtractionLabデモにはDetectFilledRulingsのチェックボックスがあり、コードを1行も書かずにエクスポートをロードしてグリッドが現れたり消えたりするのを見られます。オプション、レコード型、抽出APIの残りは、Delphi向けPDFium Componentの製品ページに一覧があります