インプロセスの Tesseract 呼び出しに 5,000 ms の認識タイムアウトを設定しても、5 秒後に呼び出しが返ってくる意味にはなりません。大きな多言語モデルセットでは、呼び出しスレッドはその刻限をはるかに過ぎてもネイティブライブラリーの中にとどまれます。デッドラインを強制するプログレスモニターは単語認識の最中にポーリングされるのであり、モデルのロードもページレイアウト解析も最初のポーリングの前に起きるからです。この隙間と、C の戻り値型が 1 バイトのキャンセルコールバックと、絶対に解放してはいけないメモリーを渡してくるイテレーターが、Tesseract C API を Delphi に結合する本当の仕事です。あとは配管です
Tesseract DLL を HotPDF のテキストレイヤーに繋ぐ
HotPDF はインプロセス経路を、HPDFTesseractRecognition ユニットの HPDFCreateTesseractDLLOCREngine として公開します。ファクトリーは C API をエクスポートする Tesseract DLL をロードし、TessBaseAPIInit2、TessBaseAPIRecognize、結果イテレーターを駆動して、IHPDFOCREngine を返します。THotPDF.ApplyLoadedOCRTextLayer がそのエンジンを受け取り、スキャンページに不可視で検索可能な Unicode テキストレイヤーを追加します。HotPDF の全 OCR エンジンが通るのと同じ呼び出しです
ファクトリーは前向きに検証します。DLL ファイルと tessdata ディレクトリーが存在すること。言語識別子には ASCII の英字、数字、_、+ しか入れられず、chi_sim+eng のような組み合わせの各モデルには対応する .traineddata ファイルが必要です。21 個の必須エクスポートすべてが解決して、ようやくエンジンが返ってきます。設定エラーは EArgumentException を上げ、欠けたエクスポートやモデルは名前で報告されます。ロードできない DLL は、Windows エラーコードと、アーキテクチャーと依存物を確認せよというヒントを運ぶ EOSError を上げます
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // Win64 アプリケーションには 64 ビット DLL が必要。ファイル名はビルドにより異なり、
  // 依存 DLL は同じフォルダーに置く
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default を使用
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI、MinimumConfidence 0.5
    // 空のページリストは全ページの意味。テキストを既に持つページはスキップされる
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default は PageSegMode を tpsAuto、EngineMode を temDefault、TimeoutMilliseconds を 60,000、MaxPixels を 16,777,216 に設定します。このピクセル予算は人が思うより早く効いてきます。デフォルトの 300 DPI での US Letter ページは 2,550 × 3,300 ピクセル、およそ 840 万にレンダリングされ、収まります。同じページを 600 DPI に上げると 5,100 × 6,600、約 3,370 万ピクセルになり、エンジンは Tesseract が画像を見る前に Invalid Tesseract DLL OCR request or pixel budget で拒否します。MaxPixels を上げるか(上限は 67,108,864)、300 DPI にとどまるかです。本文テキストには 300 DPI で十分で、各辺も 32,767 ピクセルで打ち切られます
DLL は LoadLibraryEx と、DLL 自身のフォルダーとデフォルトの安全なディレクトリーをカバーする検索フラグでロードされます。したがって Tesseract が依存するイメージライブラリーは隣に置けてよく、PATH に触れることもカレントディレクトリーに頼ることもありません。HotPDF は OCR ランタイムも言語モデルも同梱せず、ダウンロードもしません。両方ともあなたが調達します
tesseract.exe と比べて DLL 経路が変えるもの
同じ認識器には、BMP を書いて TSV を解析する外部 tesseract.exe アダプターからも辿り着けます。両アダプターは 1 つのテキストレイヤーパイプラインに供給するので、座標マッピング、信頼度フィルタリング、全か無かのコミットは同じに振る舞います。違うのはピクセルの入り方、単語の出てき方、認識器が変な振る舞いをしたときに何が起きるかです
| 観点 | tesseract.exe アダプター | Tesseract DLL アダプター |
|---|---|---|
| ファクトリー | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| ピクセルの入力 | プライベートな一時ディレクトリーの BMP ファイル | メモリー上の 8 ビットグレースケールバッファー |
| 単語の出力 | 単語レベルの TSV、64 MiB で打ち切り | 結果イテレーター、単語ごとの UTF-8 |
| ベースライン | TSV にはない。パイプラインが推定する | TessPageIteratorBaseline から素通り |
| ページセグメンテーションとエンジンモード | THPDFTesseractOptions オーバーロード、--psm と --oem として送信 | THPDFTesseractOptions、TessBaseAPISetPageSegMode と TessBaseAPIInit2 へ送信 |
| ピクセル予算 | オプションを渡したときの MaxPixels | 常に MaxPixels、加えて 1 辺 32,767 ピクセル |
| タイムアウト | ハード:子プロセスを終了させる | 協調的:Tesseract が気付く必要がある |
| クラッシュとメモリーの隔離 | 独立したプロセス | なし。あなたのアドレス空間を共有する |
1 つの代償は DLL の側に残ります。各 Recognize 呼び出しは自分の API インスタンスを作り TessBaseAPIInit2 を走らせるので、言語モデルはページごとに初期化されます。ファイルキャッシュが再ロードの痛みを和らげるものの、大きな多言語モデルセットではページあたりの最大の固定コストであり続け、しかも認識デッドラインに請求されます。インプロセス RapidOCR DLL エンジンは正反対の選択をして、ONNX モデルをエンジンの生涯中メモリーに常駐させます。境界の問題(C ABI、借り物バッファー、中断できないネイティブ処理)は同じ一族ですが
ではどちらを本番に置くべきか。数百枚のスキャンを処理するデスクトップツールやバッチジョブには DLL が似合います。ページごとのプロセス起動がなく、ディスク上の一時ビットマップがなく、傾いた行への本当のベースラインが得られます。見知らぬ人から PDF を受け取る長時間稼働のサーバーは tesseract.exe にとどまるべきです。ネイティブのクラッシュや暴走した確保がそこでは 1 つの子プロセスを落とすだけで済み、あなたのサービスを落としません
なぜ Delphi は Tesseract のモニター構造体をコピーできないのか
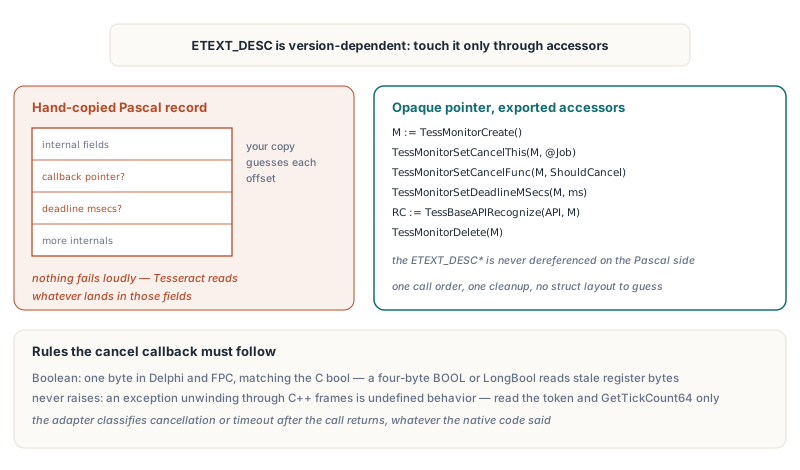
Delphi が Tesseract のプログレスモニターを安全に写せないのは、ETEXT_DESC が Tesseract のビルド間で変わる内部フィールドを抱えているからです。1 つのヘッダーから手で翻訳したレコードは、キャンセルコールバックとデッドラインをそのヘッダーが使っていたオフセットに置きます。別のビルドに対して走らせると、Tesseract は今は別の意味を持つフィールドからあなたのコールバックポインターを読み出すか、デッドラインをまったく見つけられず、認識はただ最後まで走ります
そこで HotPDF アダプターはモニターをオペークなポインターとして扱い、エクスポートされた関数を通してだけ触ります。TessMonitorCreate、TessMonitorSetCancelThis、TessMonitorSetCancelFunc、TessMonitorSetDeadlineMSecs、TessMonitorDelete です。下のスケッチは HotPDF API ではなくあなた自身のバインディングコードであり、宣言はアダプターが GetProcAddress で解決するものと一致します
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*、決してデリファレンスしない
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  // 自分のジョブ状態であり HotPDF の型ではない
  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // Tesseract のスタック上で走る:フラグと時計を読むだけで、raise しない
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// 使い方。関数ポインターは GetProcAddress で解決済み:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
スケッチはコールバックを Boolean と型付けます。Delphi と Free Pascal の両方で 1 バイトであり、TessCancelFunc の C の bool と一致します。4 バイトの Windows BOOL と Delphi の LongBool は互換的に見えて別の型です。片側が 1 バイトを書きもう一方が 4 バイトを読むと、上位 3 バイトはレジスターが以前に保持していた何者かになり、false が true として届きます。TessPageIteratorBoundingBox は int を返し、Pascal 側では Integer と宣言します。API 全体に 1 つの規則を仮定するのでなく、戻り値ごとに C の型を読んでください
コールバックは決して raise もしません。Tesseract の C++ フレームを Delphi の例外がアンワインドするのは未定義動作です。HotPDF のコールバックはキャンセルトークンと単調な GetTickCount64 値だけを読み、アダプターは TessBaseAPIRecognize が返った後でその結果をキャンセルかタイムアウトの診断に変換します。この検査はネイティブの戻りコードが 0 か否かに関係なく走ります
Delphi 側が所有するネイティブポインターはどれか
HotPDF Tesseract DLL アダプターはリクエストごとに 3 つのネイティブオブジェクト(API インスタンス、モニター、結果イテレーター)を所有し、それ以外はすべて借り物です。各 Recognize 呼び出しは自分のセットを作り、finally ブロックの中で固定の順序——TessResultIteratorDelete、次に TessMonitorDelete、次に TessBaseAPIDelete——で解放します。エンジンインターフェースの解放は DLL に FreeLibrary を呼びます
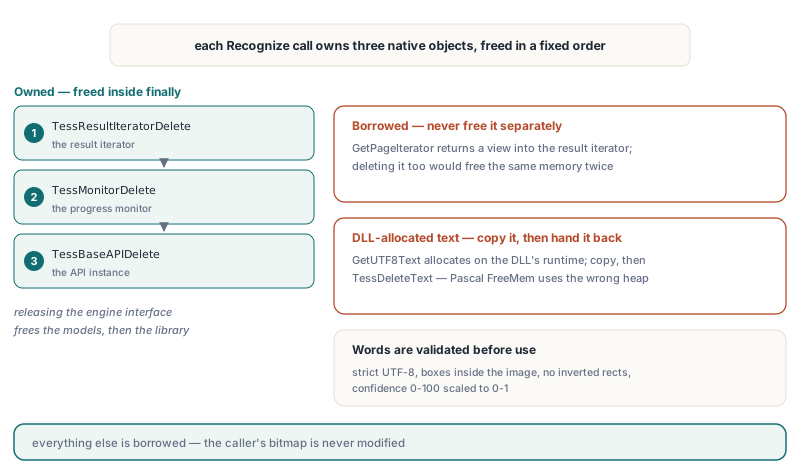
TessResultIteratorGetPageIteratorは新しいオブジェクトではなく結果イテレーターへのビューを返します。アダプターはTessPageIteratorBoundingBoxとTessPageIteratorBaselineに使うだけで決して解放せず、これも解放すると同じメモリーを 2 回解放することになりますTessResultIteratorGetUTF8Textは DLL 自身のランタイムが確保した文字列を返します。アダプターはそれをデコードし、finallyブロックの中でTessDeleteTextを通して返します。Pascal のFreeMemでは間違ったヒープから解放することになるからです- 単語テキストはまず長さ検査付きの厳格な UTF-8 デコードを通ります。制御文字を含む単語、不正な UTF-8、画像の外のボックス、反転した矩形、0〜100 の外の信頼度はリクエストを失敗させます。アダプターは後付けで直したりしません
- リクエストあたりのテキストは 1,048,576 UTF-16 コード単位で打ち切られ、単語数は
ApplyLoadedOCRTextLayerがページごとに引き渡す予算に収まらなければなりません
信頼度は 0〜100 で届き、0〜1 へスケールされるので、THPDFOCRTextLayerOptions.MinimumConfidence はどのエンジンでも同じ意味を持ちます。Tesseract がベースラインを報告するときは両端が素通りし、縦書き寄りの単語ではボックス幅がテキスト高さとして使われます。ベースラインがないとき、テキストレイヤーパイプラインは幾何学的推定へフォールバックします。TSV 入力のときとまったく同じです
DLL に届く前に enum オプションを範囲検査する
ファクトリーは範囲検査の前に PageSegMode と EngineMode の生バイトを Integer へコピーします。コンパイラーは enum 変数が常に宣言済みの値を保持すると仮定する権利を持つため、enum に直接書いた Ord(X) > Ord(High(T)) のようなテストは定数 false へ折りたたまれかねません。これらの序数は素の整数として DLL へ届きます。THPDFTesseractPageSegMode は Tesseract のページセグメンテーション番号 0 から 13 に従い、THPDFTesseractEngineMode はエンジンモード番号 0 から 3 に従います。FillChar でクリアされたオプションレコード、ストリームから読まれたもの、C++Builder から整数キャストで詰められたものは、200 のようなバイトを運べます。コピーを検証すれば、それはファクトリー時点の EArgumentException に変わります。ファクトリーはさらに、単語を 1 つも返さない tpsOSDOnly と tpsAutoOnly を拒否し、tpsAutoOSD と tpsSparseTextOSD には osd.traineddata を要求します
認識タイムアウトが実際に保証するものとは
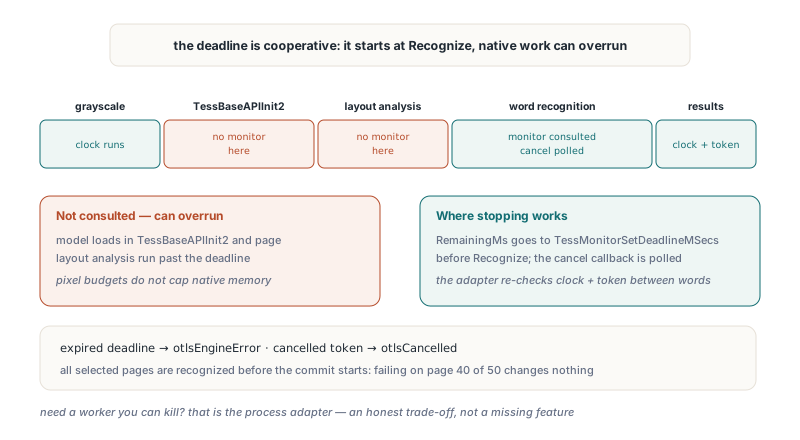
Tesseract DLL のタイムアウトは協調的です。HotPDF は自分の仕事を止めて Tesseract にも止まるよう頼めますが、ネイティブコードに強制的に返らせることはできません。時計は Recognize が始まったときに動き始めるので、グレースケール変換とモデル初期化は認識そのものと同じ予算から引かれます。アダプターは経過時間とキャンセルトークンを、グレースケール変換中は 64 行ごとに、初期化の後で、結果をたどる間は単語ごとの前に確認します。TessBaseAPIRecognize の直前には残りミリ秒を TessMonitorSetDeadlineMSecs へ渡します
隙間はネイティブ呼び出しの内側にあります。Tesseract がモニターに相談するのは単語認識の最中だけなので、TessBaseAPIInit2 やページレイアウト解析の内側では、遅いモデルロードや病理的なレイアウトがタイムアウトの報告より先にデッドラインを走り抜けられます。ピクセルと出力の予算はネイティブライブラリー自身のメモリー使用量も上限化しません。丸ごと殺せるワーカーが必要なら、そのための道具はプロセスアダプターです
ページセグメンテーションは、扱いにくい入力で DLL アダプターが効果を発揮する場所です。散らばったフィールドを持つフォーム、ラベル、スキャンされた表は、存在しない段組みや段落を組み立てようとする自動セグメンテーションより tpsSparseText のほうがよく認識されがちです。下のタイムアウトはフォームページには短めで、それでもモデル初期化をカバーしなければなりません
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // 散らばったフィールド、段組みの組立てなし
  TessOptions.EngineMode := temLSTMOnly;     // tessdata に LSTM モデルが必要
  TessOptions.TimeoutMilliseconds := 20000;  // モデル初期化を含む
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        if Pos('timed out', string(Info.Diagnostic)) > 0 then
          Writeln('Tesseract timed out, document unchanged')
        else
          Writeln('Tesseract failed: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
タイムアウトは診断に Tesseract DLL OCR timed out を載せた otlsEngineError として表面化します。THPDFOCRTextLayerOptions.CancellationToken で渡されたトークンは otlsCancelled として表面化します。どちらの場合も ApplyLoadedOCRTextLayer はコミットを始める前に選択された全ページを認識し終えるため、50 ページ中 40 ページでの失敗はロードされたドキュメントを寸分違わず元のままにします。tpsSingleLine、tpsSingleBlock、tpsSparseText はセグメンテーションだけを変えます。傾いたスキャンをまっすぐにはどれもしてくれません
Free Pascal と Lazarus:古いピクセルと消えた中国語
両方の Tesseract ファクトリーは、ターゲットアーキテクチャー向けに Lazarus パッケージを再ビルドすれば、Windows の Free Pascal と Lazarus の Win32 と Win64 ビルドで動きます。移植の全般はHotPDF on Free Pascal and Lazarus Win64 で扱っています。FPC の振る舞いが違うのは入力処理です
スキャンライン経由で書かれた LCL の TBitmap は、Windows ビットマップハンドルを更新しないまま生画像を更新でき、そのハンドルへの GetDIBits は古いピクセルを返します。症状は不可解です。ビットマップに直接描いたテキストは認識され、スキャンライン経由でレンダリングされたページは単語を 1 つも返しません。FPC では DLL アダプターは CreateIntfImage 経由でフォーマットを考慮したスナップショットを読み、生画像のピクセルフォーマットと行順を尊重します。Delphi ビルドはプライベートな 24 ビットコピー上の GetDIBits 経路を保ち、どちらのビルドも呼び出し元のビットマップを変更しません
tesseract.exe アダプターは別の問題に遭います。FPC の TStringList は ANSI 文字列を保存するため、デコード済みの UTF-8 TSV テキストを Lines.Text へ代入すると、システム ANSI コードページが表せない中国語や補助平面の文字が全部落ちます。FPC 経路は TSV を UTF-8 バイトのまま保持し、BOM をバイトレベルで剥ぎ、各単語を自分で UnicodeString へデコードします。DLL アダプターはこの問題に遭いません。各単語をイテレーターから直接デコードするからです
Tesseract DLL アダプターは、プロセスアダプターと組み込み OCR エンジンと並んで、Delphi、C++Builder、Free Pascal 向けの HotPDF に同梱されています。エディションとダウンロードは HotPDF Delphi PDF コンポーネントのページに一覧があります