コンテンツストリームの断片[(Reference)-333(Manual)] TJは、2つの単語を明確な隙間つきで描きますが、スペース文字をまったく含みません。隙間の正体はペンの移動です。ISO 32000-1 §9.4.3は、Manualを描く前に次のグリフをフォントサイズの333/1000だけ右へずらすようリーダーに命じています。文字をコピーしてジオメトリを無視する抽出器はReferenceManualを返し、そこから作った検索インデックスは“Reference Manual”という語句に決してマッチしません。TeXの出力、多くのDistillerファイル、ほとんどのジャスティファイ組版は、この方法で単語を分けています
改行は反対側から壊れます。持ち上げられた上付き文字は行を2つに割り、斜めのDRAFT透かしは1行1文字で届き、断ち落とし済みのゲラは、どのビューアも表示しないprinter’s slug line(プリンターのスラッグ行)から始まります。壊れているファイルは1つもありません。どれも、文字をコピーする抽出器が誤読する合法的なテキスト配置を使っているだけです
グリフのジオメトリから再構築される単語スペース
HotPDF Delphi ComponentのTHotPDF.ExtractLoadedPageTextは、単語の切れ目をグリフ位置から判定します。ストリーム中のスペース文字は、それが読むシグナルの1つにすぎません。previous glyph’s writing direction(先行グリフの書字方向)に沿って、そのグリフの glyph’s own width(グリフ自身の幅)の終わりから現在のグリフの原点までの距離を測り、その距離が current glyph’s box height(ユーザー空間でアセントからディセントまで測った現在グリフのボックス高さ)の0.15を超えるときにスペースを1つ入れます。上のTJ断片では、3分の1emは、どの普通のテキストフェイスでもその線を余裕で越えるため、ページテキストはReference Manualと読めます
スペースを抑える条件が2つあります。ここまでのテキストがすでに空白で終わっているとき、または次のグリフが空白であるとき(スペース、タブ、ノーブレークスペース、全角スペース)には何も足されないため、スペースを表示する生成者のファイルにスペースが2重になることはありません。2つのCJK文字の間にも何も足されません。漢字、かな、ハングル、全角形はすべて数えられます。ジャスティファイは中国語や日本語の行を伸ばしますが、その伸びは単語境界を意味しないからです。この2つとは別に、高さゼロのグリフボックスは高さとしてTfサイズへフォールバックします。規則が使う数値はすべてグリフレコードに保存されているため、スペーシングの変なファイルはグリフごとに再生できます
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// ExtractLoadedPageTextがスペースに変えるギャップを出力する。
// 横書きテキスト専用。ExtractLoadedPageGlyphsはページ
// コンテンツストリームをForm XObjectテキストとクロップフィルタなしで返す
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // グリフボックスのアセントからディセントまでの高さ、ユーザー空間で
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // 先行グリフ自身の幅の終わりからのギャップ
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
なぜペン位置ではなく glyph’s own width から測るのか
グリフの後のペン位置には、単語の切れ目とは無関係のスペーシングがすでに含まれているからです。ISO 32000-1 §9.4.4は水平変位を、グリフ幅×フォントサイズ、プラス文字間隔Tc、プラスワードスペースTw、すべてに水平スケーリングTzを掛けたものとして定義します。各グリフレコードは両端を運びます。BaselineEndX / BaselineEndYがその完全な変位を保持し、GlyphEndX / GlyphEndYは current size における the font’s advance(フォントの送り幅)とTzだけを保持します。2つが乖離するのは、負のTcでトラッキングを詰め、グリフごとにTJの調整でスペースを返すファイルです。ペンから測ると、すべての返しがギャップに見え、“95后”のような中国語の語が“9 5 后”になってしまいます。glyph’s own width から測れば、調整はTcが奪った分を返すだけで、語は無傷のままです
しきい値がTfサイズでなくグリフボックス高さに結びついているのも、関連する理由からです。Wordのエクスポートはしばしば1 Tfと書き、実際のサイズをスケールされたTmに持たせるため、フォントサイズのオペランドは1なのにテキストは10ポイントの高さです。そのオペランドに鍵をかけた規則では、しきい値はそのようなページで0.15ポイントになり、普通のカーニングペアまで単語の切れ目に読め始めます。ボックス高さはすべての行列を適用した後に測られるため、スケール行列つきの1 Tfと素の10 Tfは同じテキストを作ります
ジオメトリから2つのエッジケースがまっすぐ出てきます。非常に緩い文字間隔で組まれた見出し、つまりTcだけで文字間にテキスト高さの0.15を超える隙間が開くものは、S P A C E Dとして抽出されます。ページがそう見えるのであって、どの広いギャップがトラッキングでどれが単語かを推測するヒューリスティックを足すよりは、そのまま返す方がまだましです。その種の推測は、強くジャスティファイされた段組みで本物の単語の切れ目を飲み込み始め、検索にとってそちらの方が悪い失敗です。1つのベースライン上に順不同で描かれた断片は負のギャップを作り、スペースなしで結合します。地の文ではまれなケースです
抽出テキストで新しい行はいつ始まるのか
ExtractLoadedPageTextは、previous glyph’s origin(先行グリフの原点)から現在の原点への移動を、先行書字方向の法線へ射影したものが、2つのグリフの大きい方のボックス高さの半分を超えたときに、新しい行を始めます。ベースラインに沿った移動は、ペンがどれだけ飛んでも、改行には数えられません
生のY移動をTfサイズの半分と比べる規則は、2方向で失敗します。1 TfとスケールされたTmではしきい値が半単位に縮むため、テキストライズ0.4で持ち上げられた上付き文字が行を割ります。一部のレイアウトエンジンがランの間に残す小さなベースラインのジッターもそうです。同じ規則はXを完全に無視します。あの斜めの透かしのような、回転したTmの下のテキストはグリフごとにページを下り、1行1文字になってしまいます。射影なら、45度のランを水平のランとちょうど同じように扱います
2つの高さの大きい方を取ることには、1行にサイズが混ざるときに意味があります。36ポイントの見出し語の後に数ポイント下がって8ポイントのキャプションが続く場合、判定は the large glyph’s height(大きいグリフの高さ)の半分に対して行われるため、ペアは一緒に保たれます。小さいグリフだけに対して判定すると、キャプションは自分の行に落ちます。テキストライズはグリフ原点の一部です。上付き文字の持ち上げられたベースライン(a superscript’s raised baseline)が同じ半分の高さに対して測られるのはこのためです
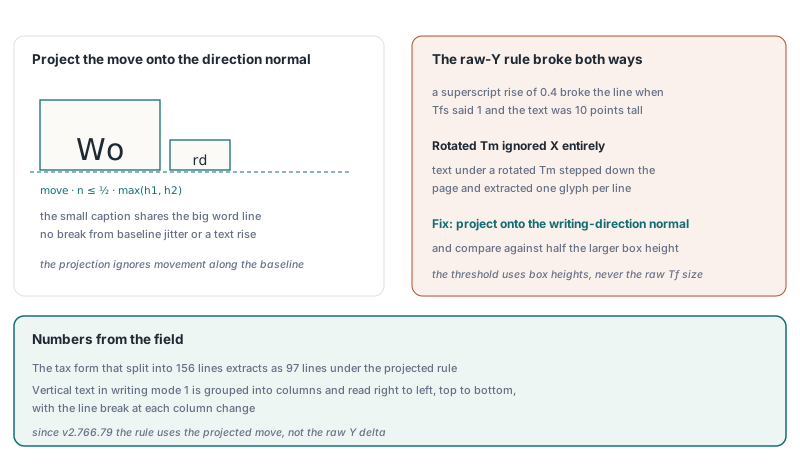
書字モード1(§9.7.4.3)の縦書きテキストは別の経路を通ります。これらのグリフは原点Xで列にグループ化され(列の許容はフォントサイズの半分)、右から左へ、上から下へ読まれ、列が変わるごとに改行が入ります。縦書きの日本語本文と横書きのランニングヘッダーが混ざるページも、2つの方向の切り替えごとに改行を得ます
どのグリフがページテキストに入るのか
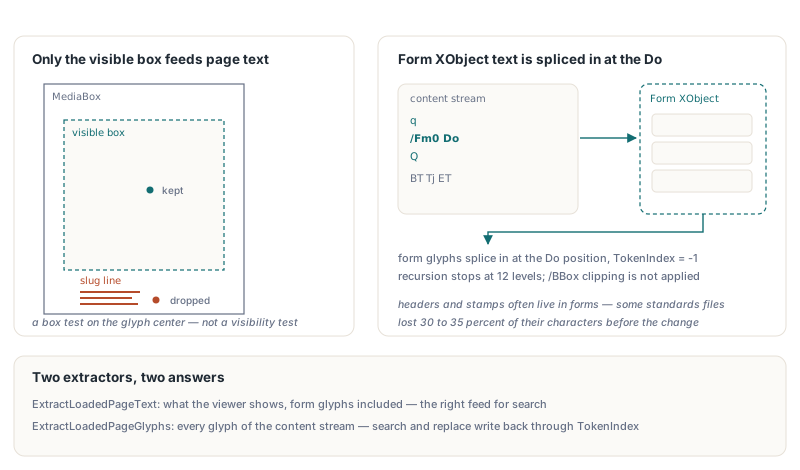
ExtractLoadedPageTextは、ビューアが見せるテキストを返します。保持するのは、ボックス中心がGetLoadedPageVisibleBox、つまりMediaBoxへクリップされたCropBox(§14.11.2)の内側に落ちるグリフだけです。スラッグ行や、断ち落とし領域の外にテキストとして置かれたその他の printer’s marks(プリンターのマーク)は落ちます。ExtractLoadedPageGlyphsは、それを必要とするジョブのために、ページコンテンツストリームの全グリフを、スラッグ行込みで返し続けます。フィルタはグリフあたり1点の幾何テストです。クリッピングパスに隠されたテキスト、白で描かれたテキスト、画像に覆われたテキストは今も出てきます。本物の可視性を判定するのはページの描画を意味するからです
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // ページコンテンツストリームの全グリフ。スラッグ行も含む
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // ページストリーム+Form XObjectテキスト。描画順、クロップ前
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // ページが見せているもの:フォームを織り込み、クロップ外を落とす
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // 同じスペーシング規則をフィルタ前のストリームに適用した比較用
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Form XObjectを通って描かれたテキストは、ページテキストの一部です。ヘッダー、スタンプ、透かしは非常にしばしばフォームに住んでおり、ページコンテンツストリームだけを読む抽出器はそれらを決して見ません。HotPDFは各Doを、有効なCTMとともに記録し、フォームをその/Matrix×そのCTM(§8.10.1)で解釈し、the form’s glyphs(フォームのグリフ)をDoの位置へ織り込みます。入れ子のフォームへは再帰します。自分の/Resourcesを持たないフォームは、それを描くストリームのものを借り入れます。§7.8.3が記述する、より旧い arrangement です。中心が the form’s /BBox(フォームのBBox)の外に落ちるグリフは外されます。そのボックスが描画時にフォームをクリップするからです。自分自身を描くフォームは、直接でも別のフォーム経由でも、2度目には入らず、ネストは12階層で止まります
フォームのグリフはTokenIndex = -1とItemIndex = -1を運びます。ExtractLoadedPageGlyphsがページストリームのグリフに限られるのも同じ理由です。検索、置換、redactionは変更をTokenIndexを通して書き戻すため、その配列の中のフォームのグリフは、別のストリームのバイトを指すことになります。グリフレベルでマージされたリストが必要なときは、ExtractLoadedPageGlyphsWithFormsが、可視ボックスのフィルタが走る前の、描画順のリストを返します
スペーシング規則の前にもう1つのパスが走ります。同じテキストを小さなオフセットで2度描くことで作られた、刷り重なったロゴや偽ボールドは、そうでなければすべての文字が2重になって抽出されます。あるグリフが、先行するグリフと同じ文字を同じサイズで、ベースラインに沿ってそのサイズの10分の1以内、横方向には5分の1以内で描くとき、コピーは1つだけが保持されます。スペースがこの方法で取り除かれることはありません。そのケースはテキスト抽出における偽ボールドと重複グリフの記事で詳しく扱っています
qとQをまたぐテキスト状態
qのときにCTMだけを保存する抽出器では、Qの後のテキストが誤ってデコードされます。テキスト状態のパラメータ、つまりフォント、サイズ、Tc、Tw、Tz、TL、レンダリングモード、ライズは、グラフィックス状態(§9.3.1)に属するため、Qはスタック上の他のすべてとともにそれらを復元しなければなりません(§8.4.2)。間違いをすぐ暴くパターンがあります。2バイトのIdentity-Hフォントが、1つの表のセルのためにq … Qの中で選択され、Qの後のテキストが、自分のTfなしで1バイトのWinAnsi文字列を表示するのです。内側のフォントを保持し続けるインタプリタはそれらのバイトをペアで読み、目次のドットリーダーが無関係なCJK文字の連なりに変わります。HotPDFのインタプリタは、すべてのqで8つのテキスト状態の値をCTMとともにプッシュし、すべてのQでポップします
ここまでの話はどのページにも当てはまるため、ドキュメント全体を1回の呼び出しでUTF-8ファイルへ出せます。ExtractLoadedPagesTextToStreamは、1始まりのページ範囲(空の文字列は全ページ)、ページ間に書かれる区切り、バイト順マーク用のフラグを取り、抽出したページ数を返します。出力は the stream’s current position(ストリームの現在位置)へ追記されるため、メモリに保持されるのは最大で1ページ分のテキスト(one page’s text)までです
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // 空の範囲 = 全ページ。ページ間はフォームフィード。UTF-8 BOM付き
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
仕事に合うテキストAPIの選び方
検索とインデックスには、ExtractLoadedPageTextが正しいフィードです。コンテンツストリーム順に従い、ページが見せているものを反映します。その下のデコードチェーン、/ToUnicodeマップからCIDフォントまでの話は、HotPDFでロード済みPDFからテキストを抽出するで扱っています。コンテンツストリーム順が最も弱いのは、生成者がランニングヘッダーを最後に書いたり2つの段を交互に描いたりしたタグ付きドキュメントです。それには、ジオメトリから推測する代わりに構造ツリーをオーサリング順に歩く構造順テキスト抽出があります。テーブルに閉じ込められたデータには、セルを値とともに返すページまたぎの型付きテーブル抽出が向いています。ページを編集するコードは、トークンインデックスが書き換えるバイトを指しているExtractLoadedPageGlyphsに乗せてください
これらの例で使ったグリフレコードのフィールドと、テキスト抽出APIの残り、そして評価版ビルドは、HotPDF Delphi PDF Component product pageに文書化されています