レポートを生成し、TrueType フォントを埋め込み、出力は試したすべてのビュアーで正しく開きます。グリフは正しく、テキストは選択可能、ファイルは妥当です。ただ 1 つ、おかしいのはサイズです。ラテン文字を数十個使っただけの文書が、350 KB 丸ごとのフォントを抱えています。中国語の段落を 1 段印刷した文書が、本来必要なはずの半メガバイトのスライスではなく、14 MB の CJK フォントを抱えています。例外は上がらず、警告はログに残らず、ファイルは検証を通ります。順序を誤った終了処理ステップが外から見るとどう見えるか、これがその姿です。何も失敗せず、証拠は大きすぎる 1 つの数字だけです
これを教訓として書き残す価値があります。間違いの形が一般的だからです。どんな文書エンジンにも、書き出す直前にオブジェクトを変更する終了処理ステージがあり、そのステージの正しさは、シリアライズとの相対的なステップ順序だけに挂かっています。1 つのステップでも書き出しの逆側に置けば、何もせず、静かに過ぎていきます
フォントサブセット化が果たすべき役割
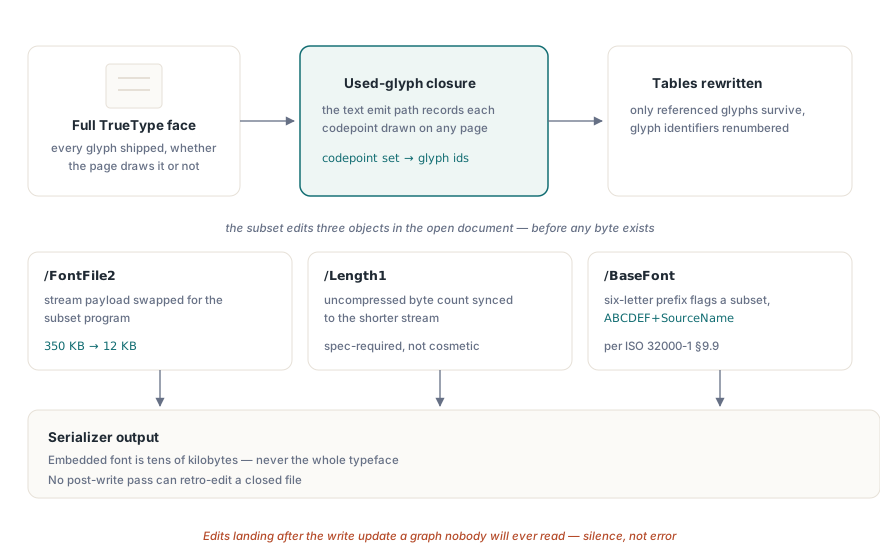
サブセットフォントとは、文書が実際に使う TrueType ファイルの部分だけを切り出したものです。ISO 32000-1 の §9.9 は、埋め込まれたフォントプログラムがフォントディスクリプタから参照されるストリームに乗ることを述べており、TrueType プログラムでは、そのストリームが非圧縮バイト数を示す /Length1 付きの /FontFile2 です。サブセット化は glyf と loca テーブルを書き換えて文書が参照するグリフだけを含め、グリフ識別子を付け直し、仕様が求めるとおり、ABCDEF+ のような 6 文字のタグを /BaseFont 名の先頭に付けてサブセットである印を付けます。10 から 15 KB に収まるラテン書体は、引き締まった PDF と、1 つの見出しのために書体一式を同梱する PDF との違いになります
これが起こる時点が重要です。サブセット化は、ディスク上のバイトに後から適用する変換ではありません。インメモリのオブジェクトグラフを編集します。/FontFile2 ストリームの内容を縮め、/Length1 を修正し、/BaseFont 文字列を書き換えます。これらはすべて、シリアライザーがグラフを歩いてバイトを吐くときに揃っていなければなりません。編集がバイト書き出しの後に着地すれば、誰にも読まれないオブジェクトを更新するだけです
症状と、何も文句を言わない理由
サブセット化が書き出しの逆側に着地すると、症状は、診断なしのフルフォントです。Unicode TrueType フォントを登録し、普通の文書を生成すると、埋め込みフォントオブジェクトがソースの .ttf ファイルと同じ長さで出てきます。/BaseFont 名に 6 文字のサブセット接頭辞はありません。グリフを 10 個使う実行と 1 万個使う実行の間で、出力サイズはちっとも縮みません
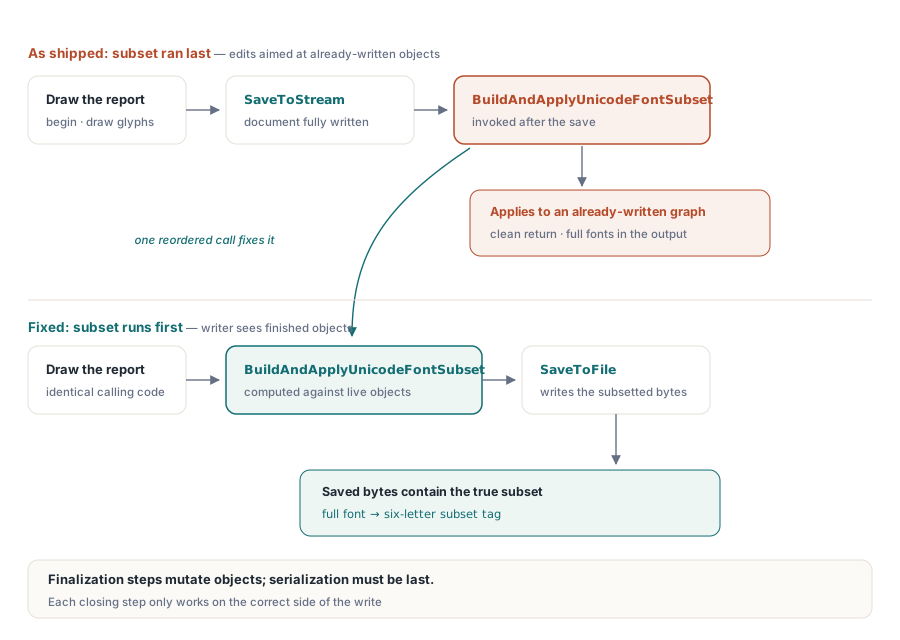
エラーが何もないことこそ、この種の間違いを高くつける部分です。誤った時点で走るサブセット化ルーチンは、それでも走ります。蓄積されたコードポイントの使用状況を歩き、完全に正しいサブセットを組み立て、メモリ上のオブジェクトグラフへ適用します。内部的には仕事は完了し、呼び出しはきれいに戻ります。間違っているのはただ 1 点、編集したオブジェクトグラフが、もう書き出される対象ではないことです。ライターはすでに終わっています。呼び出し側から見れば、文書は何事もなく生成され、保存されたのです。それこそ、静かな失敗が与える印象です
終了処理の順序でサブセット化はどこに位置するか
HotPDF では、締め処理は EndDoc の内側で行われます。サブセット化ステップは BuildAndApplyUnicodeFontSubset という名前の内部ルーチンです。文書ごとの使用コードポイントの集合を読み(これは、テキスト出力経路がグリフを描くたびに埋めていくビットマップに保持されています)、使用された各コードポイントをキャッシュ済みのコードポイントからグリフへの対応表で実際のグリフ識別子へ写像し、その閉包を中心にフォントプログラムを書き直します。Unicode TrueType フォントが登録されていると、出力経路は描く文字ごとに使用コードポイント集合へビットを立てるため、文書を閉じる時点で、エンジンはサブセットがどのグリフを保持すべきかを正確に知っています
trap は、その呼び出しの位置です。BuildAndApplyUnicodeFontSubset が、SaveToStream や SaveToFile がすでに文書をシリアライズし終えた後に呼ばれると、サブセット化による /FontFile2 への編集、修正された /Length1、6 文字の /BaseFont 接頭辞は、すべてすでにバイト化されたオブジェクトグラフに対して計算されます。正しい順序は、サブセット化を先に走らせ、シリアライズを後に行うことです。ライターはサブセット化済みフォントを吐きます。これを正すのは、1 つの呼び出しの位置の問題であり、それだけです
var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansSC-Regular.ttf');
    Pdf.BeginDoc;
    Pdf.CurrentPage.SetFont('Noto Sans SC', [], 12);
    Pdf.CurrentPage.TextOut(72, 760, 0, '报表标题 Report Heading');
    Pdf.EndDoc;                 // サブセット化はここで走る。書き出しの前に
    Pdf.SaveToFile('Report.pdf');
  finally
    Pdf.Free;
  end;
end;
どれも呼び出し側のコードには現れません。Unicode TrueType フォントを登録すれば、サブセット化は既定で有効です。フォントを登録し、文書を始め、描画し、締めれば、サブセットは使われたグリフから組み立てられます。バイトがメモリを離れる前に
1 つの配置ミスが 1 つのカテゴリーである理由
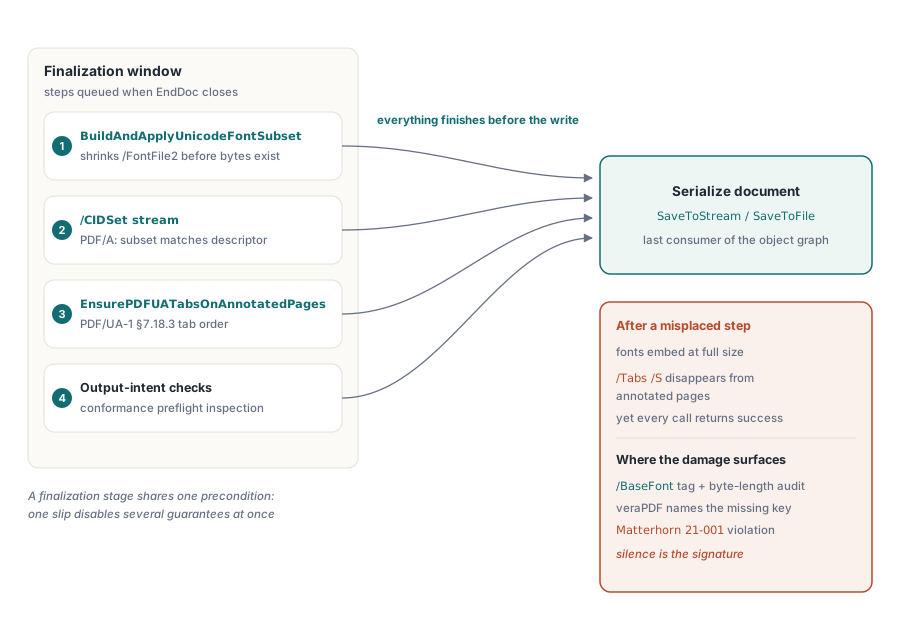
脚注ではなく教訓として書く価値があるのは、EndDoc が締めステップのリストを吐き、その 1 つ 1 つが書き出しとの相対位置に敏感だからです。フォントのサブセット化はその 1 つです。PDF/A 出力には、サブセットに存在するグリフ識別子を正確に列挙する /CIDSet ストリームが必要です。ISO 19005 が課す制約で、バリデーターが埋め込みプログラムとフォントディスクリプタの主張の一致を確認できるようにするためのものです。このストリームも同じ終了処理ウィンドウで吐かれ、サブセットが先に組み立てられていることに依存します。PDF/UA-1 は、ISO 14289-1 の §7.18.3 により、注釈を持つすべてのページが値 /S の /Tabs を宣言することを求めており、EnsurePDFUATabsOnAnnotatedPages という名前の内部ルーチンが同じステージでこのキーを押し込みます。出力インテントのチェックもここで走ります
サブセット化を無効化するのと同じ順序の過ちは、注釈付きページの PDF/UA タブ順序キーも落とします。そのステップも同じウィンドウに座っているからです。veraPDF と PAC は、欠けた /Tabs /S を Matterhorn プロトコルのチェックポイント 21-001 違反として報告します。つまり 1 つの配置ミスは、ファイルサイズを膨らませるだけではなく、同時にアクセシビリティ適合要件を静かに壊します。エラーは同じように何もありません。これが終了処理ステージの危険です。ステップたちは前提条件を共有しており、順序の 1 つの間違いが、すべての呼び出しが成功を報告したまま、そのうちのいくつかを一気に止められます
静かな出力失敗を実際にどう捕まえるか
例外を上げない失敗は、プログラムを実行しても捕まりません。出力を検査し、入力が生むはずだったものと比較して、初めて捕まります。フォントのサブセット化なら、チェックは具体的です。出力ファイルサイズを大まかな期待値と比べる。ほんの数グリフに触れた文書が、書体一式のサイズを持っているはずがありません。埋め込みフォントオブジェクトを開いてバイト長を読む。ラテン書体のサブセット化された /FontFile2 は、ソースファイルの小さな断片です。/BaseFont 名を読み、6 文字の接頭辞があることを確認します。接頭辞がなければ、サブセットが適用されなかったことの直接的なサインです
var
  Pdf: THotPDF;
  Output: TMemoryStream;
begin
  Output := TMemoryStream.Create;
  try
    Pdf := THotPDF.Create(nil);
    try
      Pdf.RegisterUnicodeTTF('C:\Fonts\DejaVuSans.ttf');
      Pdf.BeginDoc;
      Pdf.CurrentPage.SetFont('DejaVu Sans', [], 11);
      Pdf.CurrentPage.TextOut(72, 760, 0, 'Subset me');
      Pdf.EndDoc;
      Pdf.SaveToStream(Output);
    finally
      Pdf.Free;
    end;
    // 約 700 KB の書体から数グリフ取っただけで、数百 KB のストリームになってはならない
    if Output.Size > 100 * 1024 then
      raise Exception.Create('Font subset did not shrink the output');
  finally
    Output.Free;
  end;
end;
PDF/A 出力なら、チェックはさらに鋭くなります。バリデーターが仕事をしてくれるからです。適合レベルを設定し、結果を veraPDF に通します。欠けた /CIDSet や、ディスクリプタと合わないサブセットは、自分の目で気づくための課題として残されるのではなく、失敗した条項として報告されます。この終了処理を駆動する適合スイッチは、文書のプロパティです。PDFACompliance は PDF/A-2 レベル B なら '2B' のような文字列を受け取り、PDFUACompliance はタグ付き PDF とタブ順序の要件を入れる boolean です
Pdf := THotPDF.Create(nil);
try
  Pdf.PDFACompliance := '2B';     // PDF/A-2 レベル B。/CIDSet の出力を駆動する
  Pdf.PDFUACompliance := True;    // 注釈付きページへ /Tabs /S を押し込む
  Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansSC-Regular.ttf');
  Pdf.BeginDoc;
  Pdf.CurrentPage.SetFont('Noto Sans SC', [], 12);
  Pdf.CurrentPage.TextOut(72, 760, 0, '合规报告');
  Pdf.EndDoc;
  Pdf.SaveToFile('Report_PDFA.pdf');
finally
  Pdf.Free;
end;
工学の教訓
ここからは 2 つの規則が落ちてきます。第 1 に、オブジェクトを変更する終了処理ステップは、それらのオブジェクトがシリアライズされるより前に走らなければなりません。文書エンジンの締めステージは、シリアライズが最後の動作である順序付きパイプラインとして読むべきであり、いくつかの動作のうちの 1 つではありません。第 2 は、最も忘れやすいものです。出力ステップにとって、エラーの不在は成功の証拠ではありません。正しいサブセットを組み立て、間違った、すでに書かれたグラフへ適用するルーチンは、何も問題を報告しません。それ自身の視点では、問題は無かったからです。検証は、戻り値ではなく、成果物を見なければなりません。出力サイズを確認し、埋め込みフォントのバイト長と /BaseFont 接頭辞を読み、PDF/A 出力は veraPDF に判定させます。欠けた /CIDSet が、静かな不足を名前のある失敗へ変えてくれるのです
フォント処理の生産側、つまりレポート出力のために書体を登録し埋め込む方法は、レポート出力におけるフォントと画像の記事で扱っています。検証側、つまりこれらの終了処理ステップを規格に対してチェックする側面は、PDF/A と PDF/UA 検証の解説で扱っています。どちらも、ここで述べたサブセット化と適合作業と対になり、このブログの別の記事で扱うロード、編集、暗号化、署名の API と並んで、Delphi と C++Builder 向けの HotPDF Delphi Component の一部として出荷されます