PDF から出てきた CMYK JPEG の色が濁ったり、ずれたり、ネガのようになったりするとき、たいていはデコーダが 2 つの事実のどちらかを取り違えています。サンプルが YCCK で保存されていて変換が要るのか、それとも Adobe 流儀で反転保存されているのか。HotPDF のデコーダは 3 チャネルと 4 チャネルの画像に対して DCTDecode の /ColorTransform パラメータを尊重し、仕様が定義しない値を拒否し、JPEG データ内の Adobe APP14 マーカーをその辞書エントリより優先させます。ISO 32000-1 の表 13 が要求する挙動です。同じ罠の一族として、マルチフィルタストリームには段階整合の /DecodeParms 配列が要ること、JPEG 2000 画像は明示的な /Decode マッピングを保つことも扱います
3 つに共通するテーマがあります。PDF はすでに自分の意味を語っており、罠の正体は、ほんの少しだけ別の問いに答えてしまうレンダラです
なぜ PDF 内の CMYK JPEG は反転したり色あせしたりするのか
PDF 内の CMYK JPEG が壊れる理由は 2 つのどちらかで、画面上の見え方はそれぞれ異なります。白紙が黒くなり淡色が暗くなるネガのような画像は、反転保存を指します。肌が緑になり黒が灰色になる一方で K のディテールはくっきり保たれる、色あせや色相ずれの画像は、要らない場面で色変換が掛かったか、要る場面でスキップされたことを指します
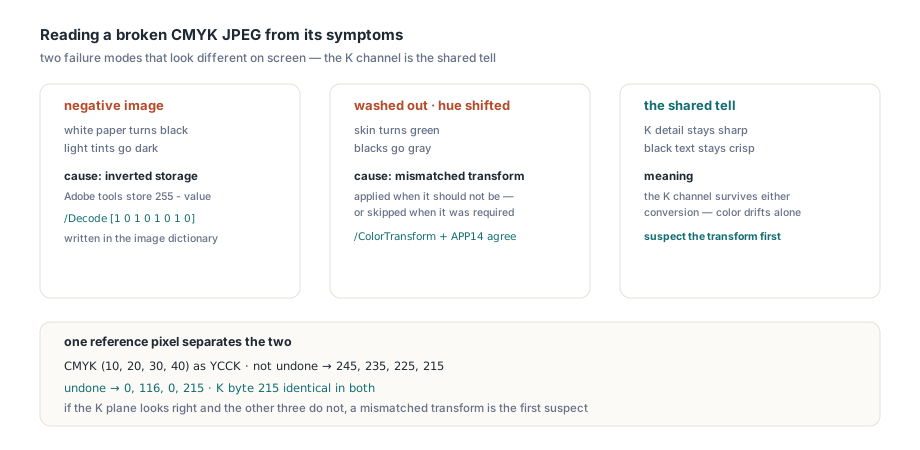
変換の問題は JPEG の色圧縮の仕組みから来ます。ベースライン JPEG は輝度と色差が分かれているときに最もよく圧縮できるため、エンコーダはたいてい圧縮前に RGB を YCbCr へ変換し、4 チャネルのエンコーダは CMY を YCC へ変換して K をそのまま通します。これが YCCK と呼ばれる形式です。デコーダはエンコーダが掛けた変換を正確に打ち消さなければなりません。起きていない変換を打ち消しても、起きた変換をスキップしても、すべてのピクセルがずれます。黒チャネルはどちらでも生き残るため、壊れた CMYK 画像は他がずれるなかで、くっきりした黒テキストを保ちがちです
反転の問題は歴史的なものです。Photoshop をはじめとする Adobe 系ツールは、CMYK JPEG の全サンプルを 255 - value で保存し、Adobe APP14 マーカーでそれを印付けます。JPEG 規格のどこにもそう書いてはいません。流儀であり、すべての利用者がそれを知っていなければなりません。PDF では、反転は当て推量に任せず、画像辞書で表現することがプロデューサに期待されます
/ColorTransform はデコーダに何を伝えるのか
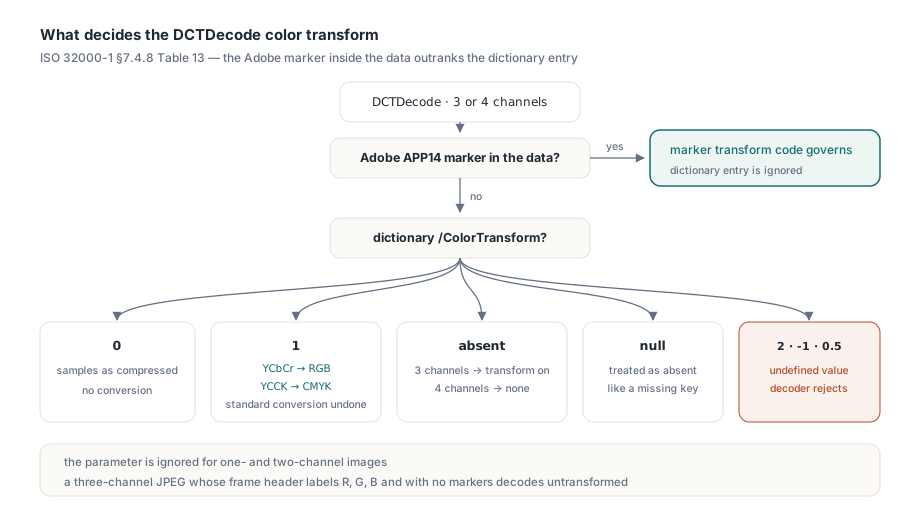
/ColorTransform は、デコーダが打ち消すべき変換を PDF レベルで宣言するものです。ISO 32000-1 §7.4.8 の表 13 は 2 つの値を定義します。0 は変換なしで、デコーダは圧縮されたままのサンプルを返します。1 はエンコーダが標準変換を掛けたことを意味し、3 チャネル画像は YCbCr から RGB へ、4 チャネル画像は YCCK から CMYK へ戻ります。1・2 チャネル画像では無視されます。表 13 は見落としやすい優先規則も定めています。符号化データが独自の変換コードを持つ Adobe マーカーを運んでいるときは、そのコードが支配し、辞書エントリは無視されます。マーカーのない JPEG だけが辞書へフォールバックし、さらにエントリもない場合、3 チャネル画像は変換あり、4 チャネル画像は変換なしを既定とします
ありがちな間違いは、パラメータ辞書を受け取っておきながら JPEG デコーダへ渡さない画像経路です。色 (128, 63, 31) を持つ 1 ピクセルの RGB JPEG が即座に暴露します。そのようなデコーダは /ColorTransform 0 でも /ColorTransform 1 でも [128, 63, 31] を返しますが、0 の正しい答えは生の YCbCr 三つ組 [79, 101, 163] です
HotPDF はこのパラメータをバイトレベルで適用します。HPDFDecodeHeadlessTerminalImage はまずスキャン開始マーカーまで JPEG のセグメント構造をたどり、Adobe APP14 セグメントを探します。コメントセグメント内のそれらしいバイトは数えません。データがマーカーを運んでいれば、その変換コードが決定し、辞書値は無視されます。運んでいなければ、デコーダは JPEG の私的複製を作り、スキャン開始マーカーの直前に APP14 セグメントを挿入します。載せるのは変換コード 0、1、そして値 1 の 4 チャネル画像なら YCCK のコード 2 です。3 チャネル画像の実効変換が 0 になるときは常に、複製は JFIF ヘッダも無効化します。JFIF ヘッダが単独で存在するだけで libjpeg-turbo は YCbCr を仮定するからです。呼び出し側のバッファは一切触られず、セグメントを挿入したときはその 16 バイトの増分が、デコーダが何かを割り当てる前に作業バイト予算へ計上されます
マーカーが存在しないときだけ挿入するのは、libjpeg の細部のためです。libjpeg は最後に見た APP14 セグメントを使います。既存マーカーの後へ挿入すると、明示的な辞書値がデータ内の矛盾するマーカーを黙って上書きします。これは表 13 と正反対の順序です。HotPDF はこの表 13 の順序を、画像 XObject 全体の経路とインライン画像の経路の両方で適用します
1 枚の画像だけがおかしいとき、ページをレンダリングせずにサンプルを確かめたいときは、同じターミナルデコーダを直接呼べます。関数は HPDFHeadlessImageCodecs ユニットにあり、フィルタ名、符号化バイト、省略可能なパラメータ辞書、そして画像辞書由来の幾何(JPEG のフレームヘッダと一致している必要があります)を受け取ります
uses
  SysUtils, HPDFObjs, HPDFHeadlessImageCodecs;

// ColorTransform < 0 は「エントリなし」の意味:JPEG のマーカーに任せる
function DecodeDCT(const Encoded: TBytes; Width, Height, Channels,
  ColorTransform: Integer): TBytes;
var
  Parms: THPDFDictionaryObject;
begin
  Parms := nil;
  if ColorTransform >= 0 then
  begin
    Parms := THPDFDictionaryObject.Create(nil);
    Parms.AddNumericValue('ColorTransform', ColorTransform);
  end;
  try
    Result := HPDFDecodeHeadlessTerminalImage('DCTDecode', Encoded, nil, Parms,
      Width, Height, Channels, 8, 64 * 1024 * 1024, nil);
  finally
    Parms.Free;
  end;
end;
デコーダは、何が合法な値かについて厳密です。明示的な -1、2、0.5 のような非整数は、既定へのフォールバックではなく EHPDFHeadlessImageError を引き起こします。仕様が定義しない値では、デコーダが信頼して行動すべき根拠が何もないからです。この検査は、データ内の Adobe マーカーがエントリを無関係にしてしまう状況でも保たれます。未定義の値は文書そのものの構造エラーだからです。変換後の複製に対して小さすぎる予算も同じように失敗し、メッセージは作業バイト予算の名前を挙げます
明示的な null は別のケースです。値そのものではないからです。ISO 32000-1 §7.3.9 は、値が null の辞書エントリは欠落したエントリと等価だとしており、/ColorTransform null はキーが存在しなかったのと同じように、マーカーかコンポーネント数の既定へ落ちます。HotPDF はすべての経路、ヘッドレスも VCL も、ストリームもインラインも、同じ扱いをします
もう 1 つの既定にも触れておきます。HotPDF が表 13 の文字を意図的に超える場所です。JFIF ヘッダも Adobe マーカーも持たず、フレームヘッダがコンポーネントを R、G、B と名付ける 3 コンポーネント JPEG は、自分のバイトで RGB を抱えていると語っています。表 13 はそれでも変換ありを既定としますが、libjpeg とそれを基にしたリーダーは変換なしでデコードし、HotPDF もそうします。ヘッドレスと VCL の両デコーダが同じ扱いをするため、赤と青はデータの置いた場所に留まります。明示的な辞書の 0 か 1 は、この推論を依然として上書きします
uses
  System.IOUtils;

var
  Jpeg, Stored, Converted, ByMarkers: TBytes;
begin
  // 640 x 480 CMYK 画像の生 DCTDecode バイト。PDF ストリームから保存したもの
  Jpeg := TFile.ReadAllBytes('suspect-image.jpg');
  try
    // データに Adobe APP14 マーカーがあれば 3 つの呼び出しは一致する:
    // マーカーが決定し、辞書値は無視される
    Stored    := DecodeDCT(Jpeg, 640, 480, 4, 0);   // マーカーなし:圧縮されたままのサンプル
    Converted := DecodeDCT(Jpeg, 640, 480, 4, 1);   // マーカーなし:YCCK を CMYK へ戻す
    ByMarkers := DecodeDCT(Jpeg, 640, 480, 4, -1);  // マーカーなし:4 チャネルの既定、変換なし
    Writeln(Format('pixel 0: stored %d,%d,%d,%d  converted %d,%d,%d,%d',
      [Stored[0], Stored[1], Stored[2], Stored[3],
       Converted[0], Converted[1], Converted[2], Converted[3]]));
  except
    on E: EHPDFHeadlessImageError do
      Writeln('Decoder refused the image: ', E.Message);
  end;
end;
4 チャネルの参照ピクセルが見るべきものを示します。YCCK として保存された (10, 20, 30, 40) の CMYK ピクセルは、YCCK 変換を打ち消さないと [245, 235, 225, 215] で戻り、打ち消すと [0, 116, 0, 215] で戻ります。K バイトの 215 は両者で同一です。K プレーンだけが正しく他の 3 つがおかしいなら、ミスマッチな変換が第一容疑者です
反転 CMYK の流儀の行き先は /Decode
HotPDF のターミナルデコーダは CMYK サンプルを libjpeg-turbo が生んだままの形で返し、Adobe マーカーを根拠にひっくり返したりしません。上の数値はこの流儀を可視化します。245、235、225、215 は単純に 10、20、30、40 を 255 から引いた値で、Adobe 系エンコーダが保存する反転形です。これをインク量へ戻すのは画像辞書の仕事で、そのような JPEG を埋め込むプロデューサは /Decode [1 0 1 0 1 0 1 0] を書くべきです。レンダラは /Decode 配列を全コンポーネントへ適用するため、正しく書かれたファイルは正しく印刷されます
裏面も率直に言っておきます。Adobe 流に反転された CMYK JPEG を対応する /Decode 配列なしで埋め込んだ PDF は、HotPDF ではネガとして描かれます。ファイル自身がそのように画像を説明しているからです。APP14 マーカーを検出して黙って補正するビューアもあります。HotPDF はそのヒューリスティックを加えません。そのようなファイルの直しは、それを書いたソフトウェア側にあります
なぜ 2 フィルタに 1 つの DecodeParms 辞書ではエラーなのか
/Filter が複数段階の配列であるストリームは、/DecodeParms も同じ長さの配列として供給しなければなりません。段階ごとにパラメータ辞書か null を 1 つです。ISO 32000-1 §7.3.8.2 の表 5 がこの規則を述べており、HotPDF はこれを強制します。1 つの共有辞書を供給したマルチフィルタストリームは、デコードされる代わりに無効な文書として報告されます
寛容な代替策は見た目以上に悪いです。/DecodeParms がすでに配列のときだけ長さを検査するデコーダは、1 つの辞書と 2 つのフィルタを渡されると、その辞書を全段階で黙って再利用します。辞書が空なら無害で、空でなければ破壊的です。内側の Flate 段階を意図した /Predictor 12 が外側にも適用され、出力はきれいなエラーではなくそれらしく見えるゴミになります。そのようなファイルの意図は復元できないため、HotPDF は空のケースでも拒みます。たとえば /Filter [/FlateDecode /FlateDecode] と /DecodeParms << >> を持つページコンテンツストリームです
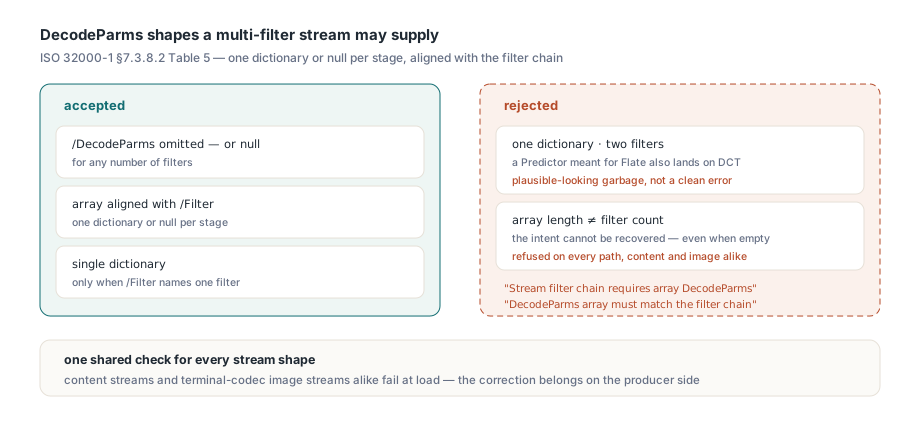
受け付ける形状と拒否する形状は列挙できます
- 受け付ける:
/DecodeParmsが省略、またはnull。フィルタ数は問わない - 受け付ける:長さがフィルタ数と等しい配列。各エントリは辞書か
null - 受け付ける:
/Filterがちょうど 1 つのフィルタを名指すときの単一辞書 - 拒否する:2 つ以上のフィルタで共有される単一辞書。診断メッセージは "Stream filter chain requires array DecodeParms"
- 拒否する:長さがフィルタ数と異なる配列。メッセージは "DecodeParms array must match the filter chain"
同じ検査は通常のコンテンツストリームと、最終フィルタが DCTDecode のようなターミナルコーデックである画像ストリームにも走るため、奇形のチェーンはストリームの中身に関係なく同じ場所で失敗します。解凍上限との相互作用はフィルタチェーン予算と PDF デコード爆弾の記事で扱っています。アプリケーションコードからは、ページがレンダリングされるときにエラーが顔を出します
uses
  SysUtils, HPDFHeadlessDocument, HPDFHeadlessCairoDevice;

var
  Document: THPDFHeadlessDocument;
  Options: THPDFHeadlessRenderOptions;
  Info: THPDFHeadlessRenderResult;
begin
  Document := THPDFHeadlessDocument.Create;
  try
    try
      Document.LoadFromFile('catalog-cmyk.pdf');
      Options := THPDFHeadlessRenderOptions.Default;
      Info := HPDFRenderHeadlessPagePNGFile(Document.GetRenderAccess(0),
        'page1.png', Options);
      Writeln('images=', Info.Images, ' decoded bytes=', Info.DecodedBytes);
    except
      on E: Exception do
        Writeln('Rejected: ', E.ClassName, ': ', E.Message);
    end;
  finally
    Document.Free;
  end;
end;
JPEG 2000 画像は明示的な /Decode を保つ
JPEG 2000 画像が /Decode を無視してよいのは、辞書に /ColorSpace がなく画像マスクでもないときだけです。ISO 32000-1 §8.9.5 はこれを条件付きにしており、HotPDF はそれに従います。ステンシル以外のすべての JPX 画像から /Decode を捨てるのは手軽な近道ですが、明示的な反転をただ消し去ります。/Decode [1 0] の下の DeviceGray JPX サンプル 64 は、191 として描かれるべきであり、64 のままではいけないのです
この条件 1 つを正しくしても十分ではありません。画像が JPX であるときに常に既定のコンポーネント範囲を設定する Lab や ICCBased のようなカラースペース分岐は、正当に適用された配列をもう一度上書きしてしまいます。そこでレンダラは、有効な /Decode 配列が実際に適用されたかを記録し、どれも適用されていないときにだけ既定範囲を埋めます。明示的な Lab と ICCBased の範囲は生き残り、辞書が沈黙しているときはコードストリームの色宣言が依然として支配します。形式のデコーダ側はJPEG 2000 と JPXDecode の記事で説明しています
どのデコード経路がこれらの規則に従うのか
両パイプラインが従います。ヘッドレス側では THPDFHeadlessDocument のロード、共有ストリームデコーダ、HPDFRenderHeadlessPagePNGFile の背後にある Cairo ベースのページレンダラです。VCL 側では TBitmap へのロード済み画像抽出と VCL ページレンダリングで、画像全体も縮小領域も同じ表 13 の順序を適用します。JFIF ヘッダが Adobe の変換 0 の上に YCbCr を押し付けたり、違法な値がその場で画像をデコード不能にしたりすることはありません。インライン DCT 画像は画像 XObject と同じマーカー、null、既定、拒否の規則に従い、省略名と完全名の両方を扱います。/DP << … >> 辞書や /F [/AHx /DCT] のような省略フィルタ配列を含みます。違法なパラメータを持つインライン画像はスキップされ、ページの残りは描かれます。ロード済み PDF からの画像抽出ガイドがその API のフィルタ処理の残りをカバーします
この挙動を信用する前に、実務上のメモをいくつか
- JPEG デコードは実行時に互換の TurboJPEG ライブラリを必要とします。
HOTPDF_TURBOJPEG_LIBRARYで既定のturbojpeg.dllやlibturbojpeg.so.0を上書きできます - 厳密な構造検査は寛容なリーダーが開けるファイルを拒否します。共有された空の
/DecodeParms辞書が代表例で、これらのファイルの直しはプロデューサ側にあります
カラーマネジメントされた印刷ワークフローのための実務的な要点は短いです。CMYK JPEG は、データ内の Adobe マーカーと一致する明示的な /ColorTransform と、保存形態に合う /Decode 配列付きで書き、すべてのマルチフィルタストリームには段階整合の /DecodeParms 配列を与え、HotPDF はファイルが実際に語ることをそのまま要求すると期待してください
ここで示したヘッドレスローダー、ストリームデコーダ、Cairo ページレンダラは、クラシックな VCL 文書エンジンとともに、Delphi、C++Builder、Lazarus 向けの HotPDF Delphi PDF component に同梱されています