ページのテキストを抽出するだけなら簡単です。ですが、ユーザーが検索ボックスに単語を打ち込み、ビューアがその位置へジャンプして黄色い矩形で囲ってくれることを期待した瞬間、単なる平坦な文字列では得られない情報が必要になります。各一致が存在するページと、その一致が PDF 座標系で占める矩形です。ページ全体で連結された文字列は、そのジオメトリを失っています。部分文字列は見つけられても、指し示すことはできません
PDF Library for Delphi は Delphi と C++Builder 向けのネイティブな Object Pascal PDF ライブラリであり、v3.78.0 からはまさにその問いに答えます。既存のテキストブロック抽出器の上には 3 つの問い合わせ API が載っています。SearchText はページ範囲を歩き、各ヒットについてページ番号と軸平行の矩形を返します。EnumPageElements は 1 ページ上のすべて(テキストブロックも埋め込み画像も同様です)を一覧化します。GetTextInAreaEx は領域内のすべてのブロックについて、文字列リストへ平坦化する代わりに矩形を報告します。どれも書き込み経路には触れません。ライブラリがすでに持っていた機構の上に載った、純粋な読み取り側の追加機能です
ジオメトリがファネルではなくテキストブロックリストに宿る理由
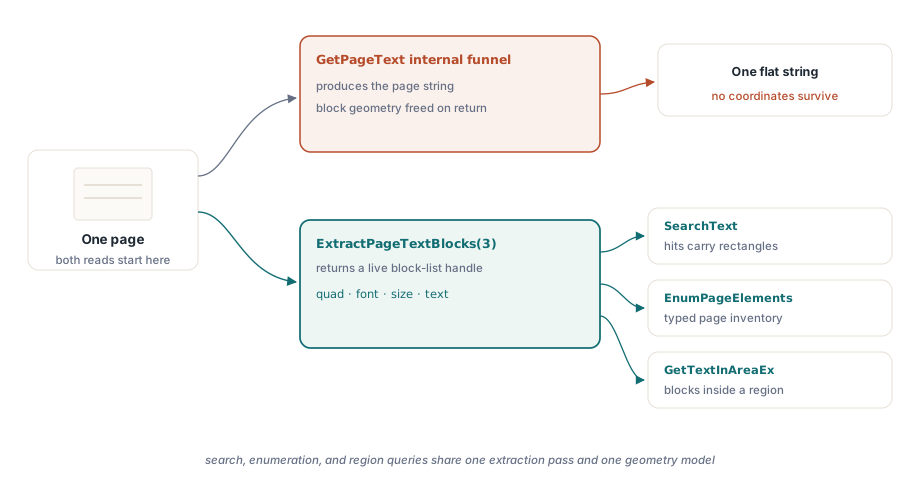
自然な発想は、GetPageText が内部で走らせているものをそのまま再利用することです。しかし、その経路はページ文字列を生成したあと、呼び出しが返る前に自らを解放する一時的な抽出「ファネル」を通ります。結果を手にした時点では、ブロックごとの座標はもう失われています。そもそも保持して良いものではなかったからです
座標が生き残っているのは、別の構造の中です。ExtractPageTextBlocks(3) はテキストブロックリストのハンドルを返します。その項目はそれぞれ、8 個の double からなるバウンディングクアッド、フォント名、フォントサイズ、そしてブロックのテキストを運びます。抽出のあとにジオメトリが保持されるのはこのハンドルだけで、新しい問い合わせ API のどれもがファネルではなくこのハンドルの上に構築されているのはそのためです。ブロックリストを再利用することで、検索、列挙、領域クエリが 1 回の抽出パスと、ブロックの位置に関する 1 つの定義を共有します
SearchText の形はこの制約から自然に決まります。範囲内の各ページについてブロックリストを抽出し、GetTextBlockText で各ブロックのテキストを読み、クエリと照合し、一致したブロックについてはクアッドを矩形へ縮約します。返されるヒットは次の小さなレコードです:
type
  TPDFlibSearchHit = record
    Page: Integer;                       // matchの1-based page
    Left, Top, Right, Bottom: Double;    // 軸に平行なhit rectangle
    MatchText: WideString;               // queryを含んでいたblock text
  end;
Bound 配列は 4 つの頂点ではなく、X/Y が交互に並ぶ
最初に引っかかるのはこの細部です。GetTextBlockBound(ListID, Index, BoundIndex) は 1 から 8 の BoundIndex を取ります。しかし、その 8 つの値は推測しがちな「頂点 1、頂点 2、頂点 3、頂点 4」が各 2 フィールドずつまとまった並びではありません。実際は X, Y, X, Y, X, Y, X, Y という並びで、奇数インデックスが X 座標、偶数インデックスが Y 座標、合計 4 点です。間違ったペアで読むと、矩形は無意味なものになります
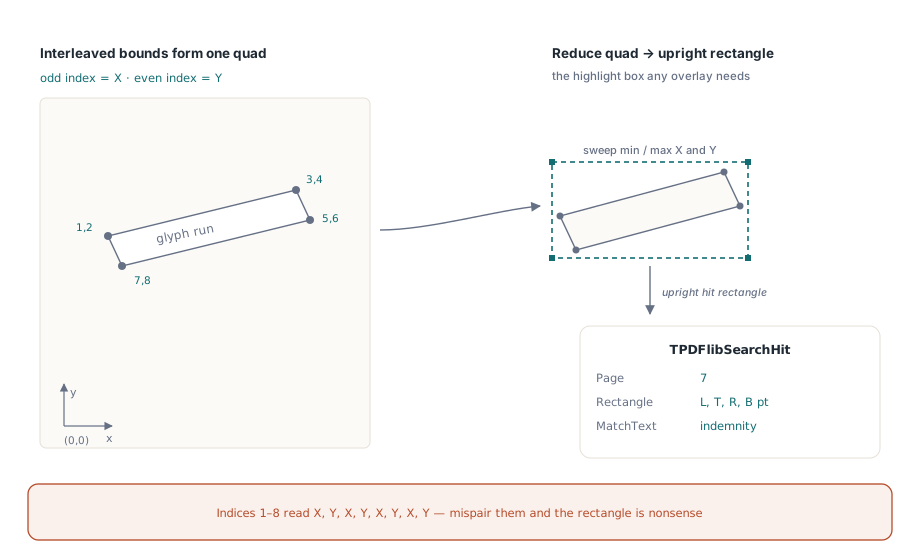
回転があるからです。単純な矩形ではなく quad を持つ理由はそこにあります。角度付きで配置されたテキストブロックは真の 4 点ポリゴン境界を持ち、この 8 個の double はそれを正確に表します。ですが、ハイライトとジャンプの用途では、たいてい直立した矩形のほうが必要です。そのためライブラリは 4 点を走査して X と Y の最小値・最大値を取り、quad を軸平行矩形へ縮約します。回転したテキストは、それを内包する直立ボックスへ折りたたまれ、ハイライト表示にはそれが適しています
var
  Pdf: TPDFlib;
  Hits: array[0..255] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('contract.pdf', '');
    // Search pages 1 to 10, case-insensitive, substring match.
    Found := Pdf.SearchText('indemnity', [], '1-10', Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Format('p%d: [%.1f %.1f %.1f %.1f] %s',
          [Hits[I].Page, Hits[I].Left, Hits[I].Top,
           Hits[I].Right, Hits[I].Bottom, Hits[I].MatchText]));
  finally
    Pdf.Free;
  end;
end;
この矩形は、ページ左下を原点とする PDF ユーザ空間ポイントで表されます。描画や注釈 API に渡すのと同じ座標系です。これは意図的です。検索ヒットから返ってくる矩形は、変換なしでそのままハイライト注釈や「ここへスクロール」コマンドへ渡せる矩形です
大文字小文字、単語全体一致、そして CJK が異なる点
第 2 引数は TPDFlibSearchOptions 型のセットで、soCaseSensitive と soWholeWord から構成されます。空のセット [] が一般的なケースで、大文字小文字を区別しない部分文字列検索になります。soCaseSensitive を加えれば Indemnity と indemnity が区別されるようになり、soWholeWord を加えれば sign が signature の内部で一致しなくなります。両方を組み合わせることもできます
whole-word 一致には、単語境界とは何かという定義が必要です。そしてこのルールは設計上 ASCII 中心であるため、率直に述べておく価値があります。ASCII の英字、ASCII の数字、アンダースコアは単語の一部と見なされます。識別子のルールでおなじみの [A-Za-z0-9_] クラスです。一致の直前と直後の文字が 単語文字ではない 場合(または一致がブロックの端にある場合)にだけ、その一致は whole-word と見なされます
非ラテン文字に対する帰結は、多言語検索ボックスを出荷する前に知っておくべき点です。漢字やかな、その他の非 ASCII 文字はこのクラスの外にあるため、それらに隣接する境界はすべて非単語エッジとして読まれます。実際には、CJK テキストに対する whole-word 検索はすべての位置が有効な単語境界であるかのように振る舞い、このフラグはそこでは部分文字列一致として働きます。語の分割が必要な CJK 主体のコーパスでは、抽出したテキストに専用のトークナイザを実行し、その出力に対して一致判定を行ってください
ほかの場所で起こる一種の微妙な失敗を説明してくれる実装上の脚注が 1 つあります。大文字小文字を無視する比較は、AnsiUpperCase ではなく WideString に対する UpperCase を使っています。Ansi 系のバリアントは AnsiString を返すため、経路の残りが使う WideString と噛み合いません。両者を混ぜると型の不一致が起き、さらに悪いことに、アクティブなコードページの外にある文字では情報を落とす折りたたみが発生します。Unicode で入り、Unicode で出る。それを最後まで貫いています
ライブラリ全体で 1 つのページ範囲パーサーを使う
第 3 引数は "1,3,5-9" のようなページ範囲文字列です。解析の仕組みに独自のものは何もありません。PrintPages やページコピールーチンの背後にあるのと同じ PLParsePageRangeList がここでも処理するため、正しく印刷できる範囲は正しく検索できます。空の範囲文字列は「すべてのページ」を意味するセンチネルで、その場合は SearchText が自力で完全なリストを作ります
コストに影響するのは範囲です。1000 ページ文書のうち 10 ページだけを検索するなら、抽出するブロックも 10 ページ分だけで済みます。ループが選択して抽出するのは、範囲が指したページだけだからです。目的の条項が付録にあると分かっているなら、範囲で示して残りのファイルを飛ばしてください
内部では、検索も列挙も反復の途中で選択ページを変更します。そのため、どちらも入場時に呼び出し元の選択ページを保存し、finally ブロックで復元します。ページを構築している途中で SearchText を呼んでも、呼び出しから戻るときには選択はちょうど残した場所にあります。この保存と復元の契約は、欠けているときにしか気付かない類のものです。だからこそ、ここに存在しています
ページ全体を列挙する: テキストと画像を 1 つの一覧に
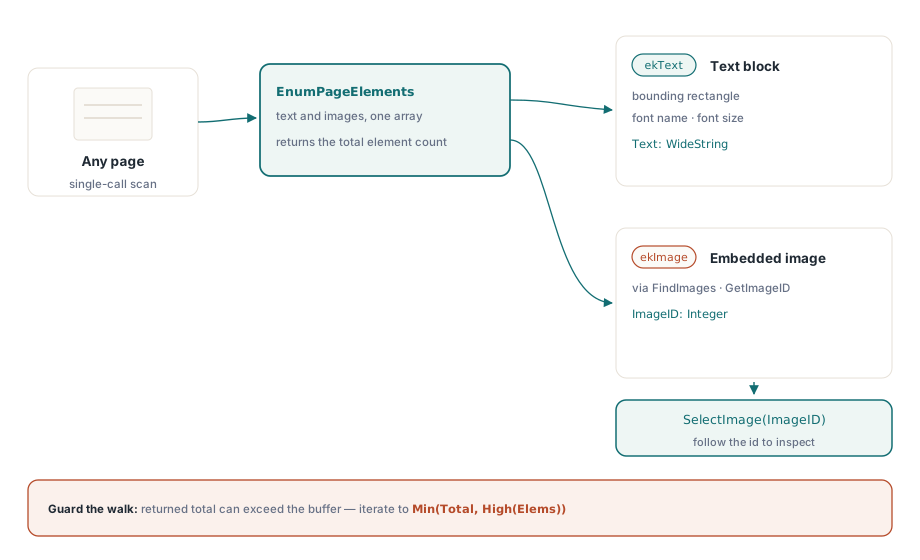
検索は「この単語はどこにあるか」に答えます。イントロスペクションのもう半分は「このページにはそもそも何があるか」であり、それを担うのが EnumPageElements です。各要素がテキストブロックまたは埋め込み画像のいずれかである、1 つの統一リストを返します。Kind フィールドで区別されます:
type
  TPDFlibPageElementKind = (ekText, ekImage);

  TPDFlibPageElement = record
    Kind: TPDFlibPageElementKind;
    Page: Integer;
    Left, Top, Right, Bottom: Double;
    Text: WideString;        // ekText
    FontName: WideString;    // ekText
    FontSize: Double;        // ekText
    ImageID: Integer;        // ekImage;SelectImage / GetImageIDで使用可能
  end;
テキスト要素は同じ ExtractPageTextBlocks パスから来るため、矩形、フォント名、サイズがすでに埋められた状態で届きます。画像要素は FindImages と GetImageID を経由してページの埋め込み画像リストから来ます。それらが運ぶ ImageID は、画像をさらに調べるために SelectImage に与えるハンドルです。2 種類は 1 つの配列に収まるため、ページを 1 度たどるだけで、そのページ上のすべてが見えます
var
  Pdf: TPDFlib;
  Elems: array[0..511] of TPDFlibPageElement;
  Total, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('report.pdf', '');
    Total := Pdf.EnumPageElements(1, Elems);
    for I := 0 to Total - 1 do
      if I <= High(Elems) then
        if Elems[I].Kind = ekText then
          WriteLn(Format('text  %s/%.1f  "%s"',
            [Elems[I].FontName, Elems[I].FontSize, Elems[I].Text]))
        else
          WriteLn(Format('image id=%d', [Elems[I].ImageID]));
  finally
    Pdf.Free;
  end;
end;
ここにはライブラリの他の部分と共通の規約として、必ず守らなければならない数え方があります。守らないと、初期化されていないメモリを読むことになります。戻り値は要素数の 合計 であり、渡した配列よりも大きくなり得ます。関数は入るだけスロットを埋め、残りも数え続けます。署名列挙とまったく同じ流儀です。したがってガードは常に同じです。ループは戻り値と High(array) の小さいほうに制限し、件数をそのまま盲信して回してはいけません。上の例に I <= High(...) のチェックがあるのはこのためです。戻り値がバッファを超える場合は、より大きな配列を用意して呼び直します
このライブラリの低レベルなテキストブロック API を使ったことがあるなら、これはその上に載る型付きでジオメトリ対応の層です。基礎となる抽出は PDF Library for Delphi を使った Delphi PDF のテキスト・画像・フォント抽出 で説明したものと同じです。そして、関心が「このテキストはどこにあるか」ではなく「この文書は支援技術向けにどう構造化されているか」にあるなら、並行する読み取り面は タグ付き PDF の構造ツリー です。こちらは物理的なブロック配置ではなく、論理的な読み順を公開します
見る場所が分かっているときの領域クエリ
検索語がまったく手元にないこともあります。手元にあるのは矩形です。フォームテンプレートなら請求書番号は常に右上に置かれる、スキャンされたレイアウトなら表のために固定の帯が確保されている、といった具合です。そのケースに応えるのが GetTextInAreaEx で、GetTextInArea の境界情報を運ぶ対になる呼び出しです。古い呼び出しが領域に対して平坦な文字列リストを返すのに対し、新しい呼び出しは保持された各ブロックの矩形をテキストとともに返します。ボックスの中に何があるかだけでなく、その中のどの位置に各行が座っているかまで分かります
var
  Pdf: TPDFlib;
  Hits: array[0..63] of TPDFlibSearchHit;
  Found, I: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('invoice.pdf', '');
    Pdf.SelectPage(1);
    // 選択page上のPDF pointでのLeft、Top、Width、Height
    Found := Pdf.GetTextInAreaEx(360, 720, 180, 60, Hits);
    for I := 0 to Found - 1 do
      if I <= High(Hits) then
        WriteLn(Hits[I].MatchText);
  finally
    Pdf.Free;
  end;
end;
押さえるべき点は 2 つです。GetTextInAreaEx は現在選択されているページに対して働くため、先に SelectPage を呼びます。SearchText と違って範囲は取りません。そしてブロックは、クエリ矩形に完全に内包されるときだけでなく交差するときにも保持されるため、境界にまたがる行も返ってきます。手描きの選択ボックスには通常こちらのほうが望ましい挙動ですが、厳密な内包が必要な場合は、返ってきた矩形がもう手元にあるので、自分で後段のフィルタにかけられます
実務でどう使えるか
3 つの呼び出しすべてに貫通する主題は、ジオメトリがもはや事後的に再構築するものではなくなったという点です。検索ヒットは自分のページとボックスを知っています。ページ要素は自分の矩形を知り、テキストならフォントも知っています。領域クエリは各行がどこに落ちるかを報告します。これだけあれば、公開 API より下に潜ることもテキスト抽出パイプラインを手作業で組み直すこともせずに、本物の検索ハイライト機能、クリックで位置へ飛ぶ索引、レイアウトを理解する抽出器を組み立てられます
これらの問い合わせ API は PDF Library for Delphi Delphi PDF Library の一部として提供されており、それらが基盤とする完全なテキストブロック抽出層と、Delphi および C++Builder 向けのその他の読み取り側イントロスペクションと並んで利用できます