ハーフポイントが決め手になります。10ポイントの本文を持つレポートで、11ポイント太字のセクションタイトルはMarkdownでは普通の段落として変換される一方、表紙の12ポイントのキャプションは通常のウェイトのまま### Quarterly figuresとして戻ってきます。逆に見えるでしょうが、PDFページが実際に保存しているものを思い出せば納得できます。座標に置かれたグリフ、フォント名、サイズです。ページには「見出し」と書いてあるものは何もありません。コンバーターが出力するすべての見出しは、その3つの事実から組み立てられた推測であり、推測にはしきい値があります
PDFページにエクスポートすべき段落がない理由
PDFページが含むのはテキスト表示演算子であって段落ではありません。各演算子はグリフのランを位置に置き、生成アプリケーションがたまたま出力した順序のままです。そしてISO 32000-1は、生成側が2つのランが同じ文に属すると述べる義務を負っていません。まして同じリスト項目や表セルです。この形式は印刷ページを正確に記述しますが、それはページを作った構造を捨てることでそれに到達しています
だからこそ、どのコンバーターも生成側が捨てたものを再構築します。行は共有されたベースラインと垂直間隔から来ます。段落の切れ目は間隔とインデントの変化から来ます。リストは、箇条書き文字か番号パターンで始まるブロックの連なりです。表は、縁が行と列にわたって揃うテキストブロックの格子です。普通の組版習慣に従うドキュメントではこれはよく働きます。視覚効果のために組まれたパンフレットでは、頼るものがほとんどありません
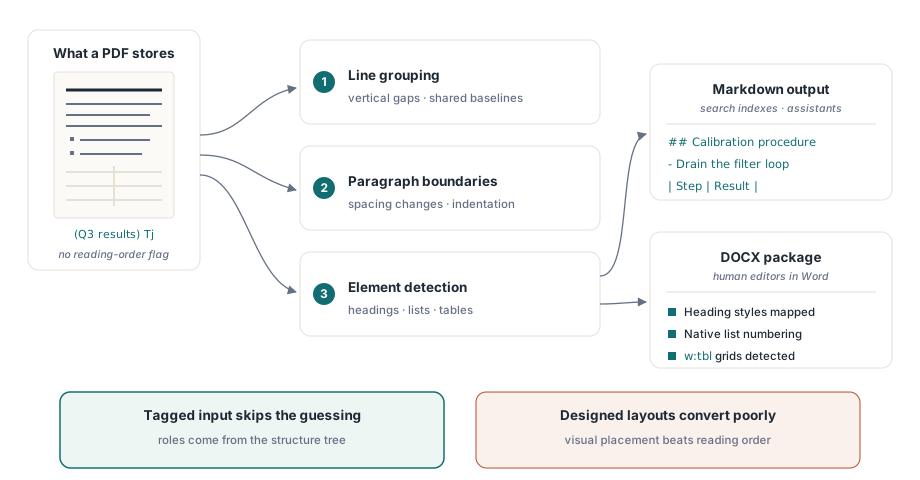
タグ付きPDFが大きな例外です。ドキュメントが構造ツリーを運んでいるとき、段落、見出し、リスト、表の役割は生成側が記録するものであり、後から推測されるものではないため、タグ付きPDFアクセシビリティ構造で述べた仕事は変換品質にも報います。生成側を自分で制御できるなら、出力にタグを付けることは、後にそれを変換する人への最安の投資です
見出しレベルはどこから来るのか
PDF Library for Delphiは入力に応じて、見出しレベルを2つの方法で決めます。タグ付きページでは、構造役割がH1からH6のブロックはそのレベルを保持し、HやTitleはレベル1になります。タグなしページでは、エクスポートはページの本文に対するフォントサイズへフォールバックし、200文字以下の単一行段落だけを考慮します
サイズ規則には、主要な本文サイズに対して測った、比率と絶対ギャップの両方が要ります:
| Markdown出力 | 行の最大テキスト | 10 pt本文の場合 |
|---|---|---|
# | 本文サイズの少なくとも1.6倍、かつ少なくとも4 pt大きい | 16 pt以上 |
## | 少なくとも1.35倍、かつ少なくとも2.5 pt大きい | 13.5 pt以上 |
### | 少なくとも1.15倍、かつ少なくとも1.25 pt大きい | 11.5 pt以上 |
これが冒頭の例を説明します。10ポイントのテキストの上に置かれた11ポイント太字のタイトルは、3つ目の段をハーフポイント差で逃し、ウェイトはレベルに関与しません。12ポイントの表紙キャプションはクリアします。絶対ギャップは小さい本文サイズのためのものです。6ポイントの脚注サイズのテキストでは、比率だけなら7ポイントの行が見出しに昇格し、追加の1.25 pt要件がそれを止めます
これが正しい引き換えだと考えています。太字は本文内であまりに一般的です(導入句、定義語、サマリー行の合計)ため、それ単体では信頼できる見出し信号にならず、すべての太字行を昇格させるコンバーターは、数十の偽セクションを持つMarkdownを生みます。太字だけの見出しをいくつか見逃すコストのほうが低いのです。太字かつ本文サイズのタイトルにドキュメントが頼っているなら、信頼できる修正は上流にあります。タグを付けるか、タイトルサイズを1.5ポイント上げることです
出力の太字と斜体はフォント名から読まれます。フォント名にBold、Black、Demiを含むランは**bold**になり、ItalicかObliqueは*italic*になります。F3のような不透明な名前でフォントをサブセット化する生成側や、素のグリフをストロークして太字を偽装する生成側は、エクスポートに読めるものを何も与えず、そのテキストはスタイルなしで届きます
検索パイプラインのためのMarkdownエクスポート
Markdown経路は、行き先がテキストパイプライン、ドキュメントサイト、検索インデックス、アシスタント用のチャンク化コーパスであるときに選ぶものです。ExportPageMarkdownは1ページをWideStringで返し、ExportDocumentMarkdownはページ範囲を返し、SaveMarkdownToFileとSaveMarkdownToStreamは同じテキストをバイト順マークなしのUTF-8で書きます。BOMがないのは意図的です。多くの静的サイトジェネレーターとdiffツールはそれを内容として扱います
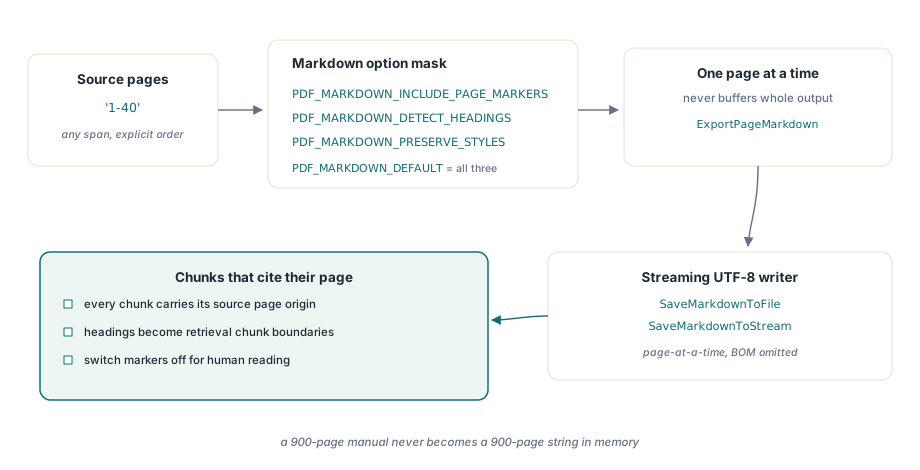
オプションはビットマスクです。PDF_MARKDOWN_INCLUDE_PAGE_MARKERS(1)、PDF_MARKDOWN_DETECT_HEADINGS(2)、PDF_MARKDOWN_PRESERVE_STYLES(4)で、PDF_MARKDOWN_DEFAULTは3つすべてを組み合わせます。2つ目の、ドキュメント全体の設定が解析そのものを制御します。SetStructuredTextOptionsはPDF_STRUCTURED_*フラグを取り、そのデフォルトは段を検出し、繰り返しのヘッダーとフッターを検出し、ページ分割をまたいで続く表を結合します
uses
  SysUtils, PDFlibrary;

var
  Pdf: TPDFlib;
  Exported: Integer;
begin
  Pdf := TPDFlib.Create;
  try
    if Pdf.LoadFromFile('handbook.pdf', '') = 0 then
      raise Exception.Create('Cannot open handbook.pdf');

    // 繰り返しのヘッダーとフッターの検出はデフォルトで有効。
    // EXCLUDE_FURNITUREを加えると出力からも落とす
    Pdf.SetStructuredTextOptions(PDF_STRUCTURED_ADVANCED_DEFAULT or
      PDF_STRUCTURED_EXCLUDE_FURNITURE);

    // ページマーカーと見出し、ただし**と*の強調はなし
    Exported := Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_INCLUDE_PAGE_MARKERS or PDF_MARKDOWN_DETECT_HEADINGS,
      'handbook.md');
    if Exported = 0 then
      raise Exception.CreateFmt('Markdown export failed, error %d',
        [Pdf.LastErrorCode]);

    // ページごとに1エントリのJSON:readingSourceはtagged、mixed、
    // geometric、geometric-columns
    Writeln(Pdf.GetLastStructuredTextDiagnostics);
  finally
    Pdf.Free;
  end;
end;検索コーパスではPDF_MARKDOWN_PRESERVE_STYLESを落とします。強調はランごとに適用されるため、複数のランに分かれた太字句は**Net** **revenue**として出てきます。画面では読みよく、あらゆるembeddingにノイズを加えます。ページマーカーは逆のケースで、保持してください。各マーカーはHTMLコメント、<!-- page: 12 -->で、Markdownの描画では見えず、チャンク分割時のパースは自明です。そのため取り出された一節は出典ページを引用できます。表が前ページから続くとき、新しいページのマーカーは省かれ、パイプ表が1つに保たれます
ループでページごとにエクスポートする人が引っかかる挙動が2つあります。1つ目、繰り返しのヘッダーは反復で認識されます。ページの上端か下端12パーセントにある段落は、同じエクスポートの別のページの同じ帯に一致するテキストが座っているとき家具として数えられ、数字は正規化されるため「Page 3 of 40」は「Page 4 of 40」に一致します。単一ページの呼び出しには比較相手がいないため、タグなしの繰り返しヘッダーはテキストに残ります。2つ目、Markdownの画像はdata: URIとしてインラインで埋め込まれ、ファイルは自己完結しますが、大きな写真を持つページは数百キロバイトのbase64をファイルに加え得ます。チャンカーにサイズ上限があるなら、分割の前に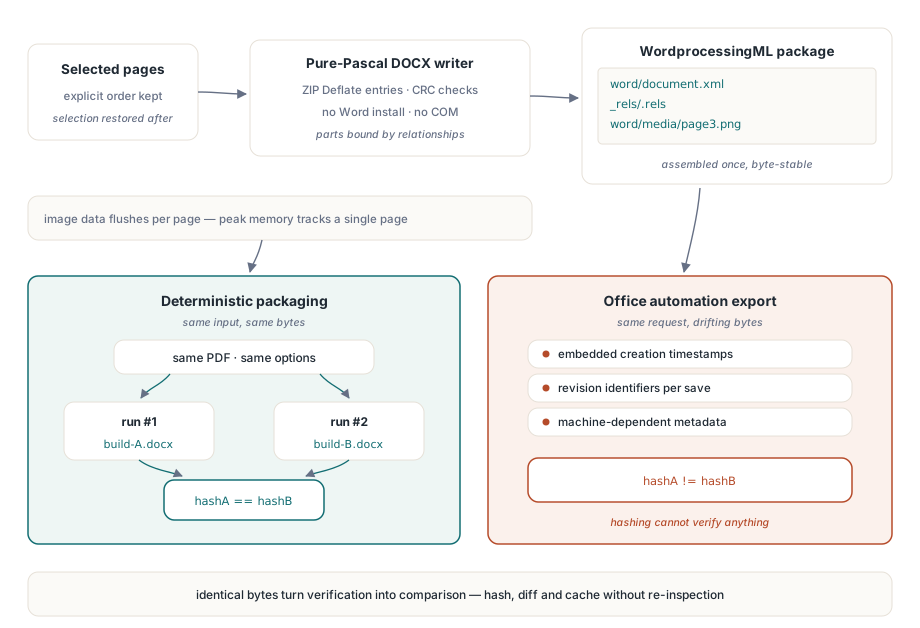
それを支える選択が2つあります。すべてのZIPエントリは実行の時刻ではなく、同じ固定のDOS日付、1980年1月1日を運び、コアプロパティパーツには作成日や変更日がありません。各エントリは、それが実際に小さくなるときだけ生のDeflateで圧縮されるため、既に圧縮されているPNGメディアはそのまま保存されます。最初の点はunzip -v handbook.docxで確認できます。どの行も同じ日付を示します
Office自動化はそれを与えてくれません。Wordを通した保存は現在時刻をパッケージメタデータとZIPヘッダに捺印するため、同じドキュメントの2回の変換は、ハッシュを無効にする形で違います。同じ理由が再現可能ビルドのための決定論的PDF IDの安定したファイル識別子の背後にあります。出力が再現可能になると、検証は比較になります
どの入力がうまく変換され、どれが決して変換されないのか
変換品質はコンバーターより入力で変わります。そのことを前もってユーザーに語る価値があります。タグ付きPDFときれいに生成されたビジネス文書(請求書、レポート、契約書)はよく変換されます。見出しは見出しに着地し、表は生き残り、リストはWordで振り直されます。2段組の学術レイアウトは、段のジオメトリが整っているとき正しい読み順で通過し、診断はそれらのページにgeometric-columnsを報告します。ページをまたぐ表は推論で再結合されるため、目視確認してください。テキストが読み順ではなく効果のために置かれる、強くデザインされたマーケティング資材は、どのコンバーターにも復元の材料をほとんど与えません。結果の手直しは手で行うと見込んでください
スキャン文書は別のケースです。1枚の大きな画像であるページはテキストオブジェクトを持たないため、テキストレイヤーが存在するまでエクスポートすべきものは何もなく、OCRの実行が両形式の前提条件です。大きなバッチにコミットする前に、代表的なファイルを1ダースサンプリングし、ページが何を含むか列挙してください。テキスト検索とページ要素の列挙で述べている方法です。画像はあるがテキストランのないページは、変換後の出力を読むより1秒で多くを語ります
形式は、その後何が起こるかで選んでください。Markdownはマシンとパイプラインに適します。見出しはチャンク境界になり、表はパイプ表として読みやすさを保ち、ページマーカーがすべてのチャンクに引用を与えます。DOCXはドキュメントを変更する必要がある人に適します。彼らが返してほしいのは、本物のリストと本物の表を持つWordでの編集可能なファイルであり、テキストだけではそれを与えられません
PDF Library for DelphiはDelphi、C++Builder、Lazarus向けに出荷され、同じMarkdownとDOCXエクスポート呼び出しをC#、C++、スクリプトホストへ公開するDLLとActiveXエディションを備えています。すべてのオプションフラグのリファレンスとトライアルダウンロードは、PDF Library for Delphi製品ページにあります