PDF の連結は、安く済みそうに聞こえます。ページコンテンツはすでにレイアウト済み、フォントはすでに埋め込み済み、画像はすでに圧縮済みです。原理の上では、マージは事務作業に過ぎません。2 つのファイルの番号空間が衝突しないようオブジェクトをリナンバーし、ページツリーを縫い合わせ、クロスリファレンステーブルを修復して、書き出す。しかし実際には、ほとんどのマージコードがこの安さを捨てています。入力ファイル内のすべてのオブジェクトに対してトークン化されたオブジェクトツリーへのフルパースを実行し、いくつかの間接参照を書き換え、ツリーをバイトへ再シリアライズするのです。パースと再シリアライズがコストの高い半分であり、圧倒的大多数のオブジェクトでは、その結果は入力とほぼ同一のバイト列になります
PDF Library for Delphi は Delphi と C++Builder 向けのネイティブな Object Pascal PDF エンジンであり、その高速マージ経路は、安全だと証明できるところではこの往復を省くために存在します。発想は狭いのですが、文書セット全体に対して効果を発揮します。未変更の非ストリームオブジェクトには、元のソースバイトをそのまま受け取り、そこに含まれる間接参照へ 1 回のバイトレベル書き換えを行い、すべての N G R を (N+Offset) G R へ変えるのです。トークナイザーもオブジェクトツリーもシリアライザーもありません。この記事では、この近道がどこで合法なのか、何も壊さずにバイト書き換えを行うパーサーの状態マシン、ブックマークマージがなぜまったく別の機構を必要とするのか、そして通常マージ経路がどのように同じ単一の線形パスを共有するのかをたどります
オブジェクトのリナンバーがマージの本当のコストである理由
すべての PDF は、自分専用のオブジェクト番号空間を抱えています。ファイル A にはオブジェクト 1、オブジェクト 2 があり、ファイル B にもファイル B 自分のオブジェクト 1、オブジェクト 2 があります。B のオブジェクトをそのまま A のファイルへ放り込むことはできません。番号が衝突し、B の内側の間接参照がすべて誤ったオブジェクトへ解決されてしまうからです。解決策はオフセットです。A がオブジェクト数 Offset で終わっているなら、B のオブジェクト N は出力ではオブジェクト N+Offset になり、B のオブジェクト内のあらゆる場所に現れる参照 N G R は、揃えるために (N+Offset) G R へシフトされなければなりません
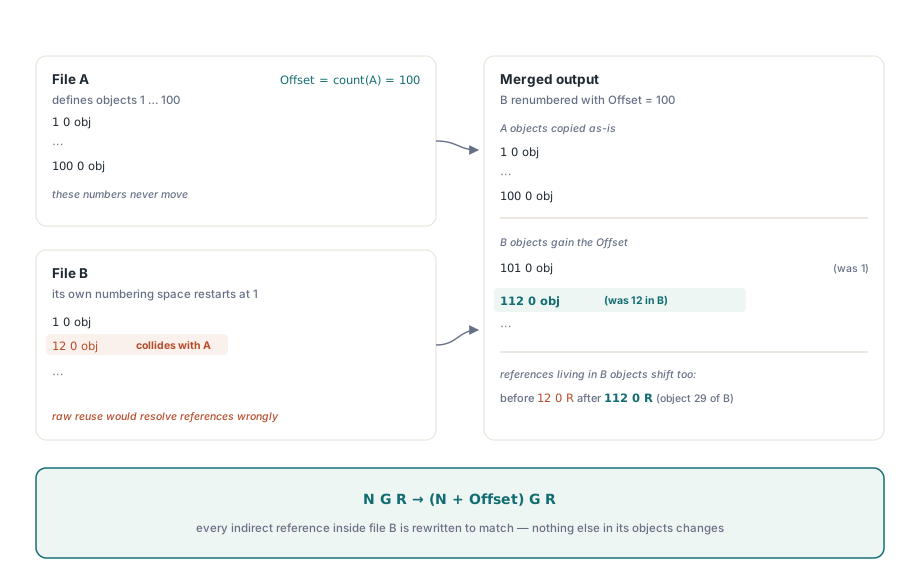
このシフトこそ、ボディのマージにおける意味論的な仕事のすべてです。ページツリーの修復と AcroForm のマージは、少数のオブジェクトへの小さく有限な編集です。大仕事は何千ものオブジェクトにわたる参照の書き換えであり、その素朴なやり方は、参照を構造的に見つけるために各オブジェクトをパースすることです。PDF Library for Delphi の MergeFileListFast は逆の立場を取ります。数字・空白・数字・R の並びが参照ではない文脈に注意するかぎり、参照は生バイトの中でも見つけられる、という立場です。パースを省き、その場でシフトすれば、オブジェクトあたりのコストは、どうせコピーするつもりだったバイトへの 1 回の線形スキャンまで落ちます
ソースバイトの再利用が安全だと証明できるのはいつか
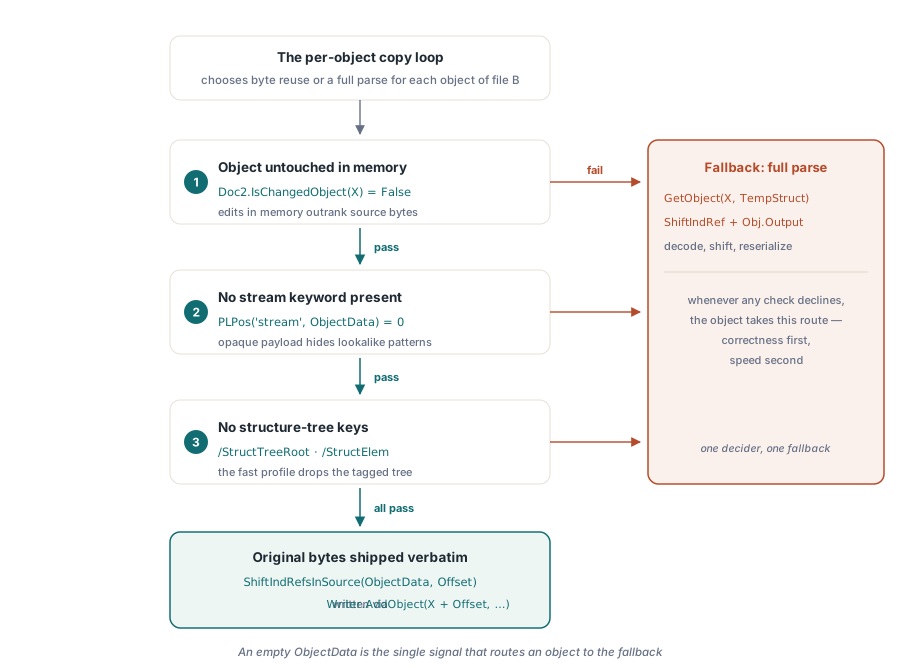
バイト経路が取られるのは、後続の文書からコピー対象となるオブジェクトについて 3 つの条件がすべて満たされるときだけです。どれか 1 つでも満たさなければ、そのオブジェクトは完全なデコードと再シリアライズの経路へ戻されます。正しさが常に速度に勝つのです
Doc2.IsChangedObject(X)が False であること。マージエンジンがすでにメモリ上でそのオブジェクトを変更している場合(/Parentが付け替えられたページオブジェクトなど)、メモリ上のツリーこそが正であり、元のバイトは古いものです。触られていないオブジェクトだけが対象になります- ソースバイトに
streamキーワードが含まれていないこと。ストリームオブジェクトの本体はstream/endstreamで挟まれた不透明なバイナリであり、圧縮や暗号化されたストリームデータへの素朴な参照スキャンは、参照に見えるバイトパターンを平気で「発見」して壊します。ストリームオブジェクトは元のストリーム対応の経路を保ちます - ソースバイトに
/StructTreeRootも/StructElemも含まれていないこと。fast プロファイルでは、タグ付き PDF の構造ツリーはマージではなく廃棄されるため、こうしたオブジェクトは、エンジンが意図的に null 化できるデコード経路を通らなければなりません
この判定は、オブジェクトごとのコピー ループの中に住んでいます。3 つのチェックがすべて通れば、オブジェクトのバイトはそのまま ShiftIndRefsInSource へ行き、それからライターへ行きます。そうでなければバイトは捨てられ、オブジェクトは GetObject で再構築され、ShiftIndRef でシフトされ、シリアライズされます。この分岐の構造は見る価値があります。安全性を保っているのはチェックの順序だからです
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // デコードへフォールバック
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // フルパース経路
  // ... 構造ツリーオブジェクトを null 化、ShiftIndRef、Obj.Output ...
end;
空の ObjectData は、バイト経路がそのオブジェクトを辞退した合図です。この 1 つのセンチネルが、fast と slow の 2 つの経路を乖離させません。判定する場所は 1 つ、フォールバックも 1 つです
参照シフトの状態マシンとそのエッジケース
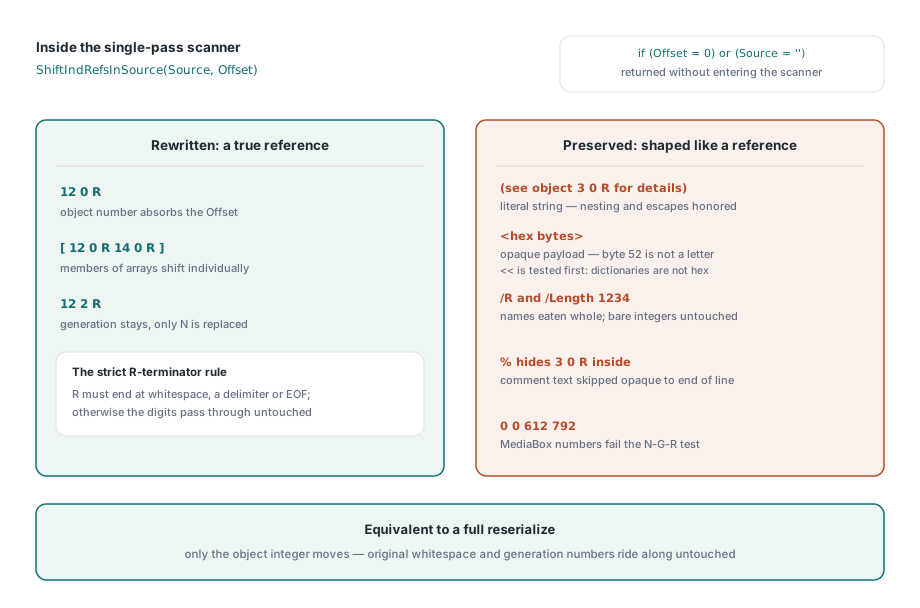
間接参照のバイト書き換えは、間違えるつもりのないところで間違えます。R と数字の並びは、参照ではない文脈の PDF オブジェクトの至るところに現れるからです。ShiftIndRefsInSource は、手書きの小さなスキャナーで、バイトを 1 度だけ歩き、ある数字が、PDF の空白を挟んで別の数字と R デリミタに続くときにだけ、その数字を書き換えます。安易な脱出が先にあります。オフセットがゼロ、またはソースが空なら、バイトはスキャナーに入らずそのまま返されます
スキャナーの正しさは、参照の形をした並びをそのままにしておかなければならない文脈を認識することに挂かっています。以下は見逃しやすい境界であり、それぞれが明示的に処理されます
(と)で区切られるリテラル文字列は、入れ子の深さを追跡し、バックスラッシュのエスケープを尊重しながら、そのままコピーされます。エスケープされた括弧が深さの数えを崩しません。(see object 3 0 R for details)のような文字列は、教科書どおりの参照パターンを含んでいますが、実態はただの散文であり、バイト単位で生き残らなければなりません<と>で区切られる16 進文字列は、解釈なしでそのまま通されます。16 進文字列の内側のバイト52はRの ASCII コードであり、hex のペイロードをテキストとして扱うスキャナーは幻の参照を作り出しかねません。辞書を 16 進文字列と誤認しないよう、辞書の先頭の<<は先に検出されます/で始まる名前オブジェクトは、スラッシュから次の空白またはデリミタまで、丸ごと消費されます。これがないと、/R(よくあるリソースキー)のような名前が、参照のRとして読まれ得ます%で始まるコメントは行末まで続き、不透明なテキストとして読み飛ばされます- 数字の次に R という検査は厳密です。参照として認識されるのは、
N空白G空白Rで、Rが空白・デリミタ・入力の終端のいずれかで終わる場合だけです。世代番号が欠けていたり、Rの次に文字が来たりすれば、数字はそのまま出力されます。これが/Length 1234の整数やMediaBoxの 4 つの数字を、黙ってインクリメントから守ります
この厳密な検査の心臓部は、規格の文の描写そっくりそのままに読めます
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // シフト後のオブジェクト番号
  AppendBytes(E1, P - E1);                 // 元の空白と世代番号
  AppendBytes(P, 1);                       // 'R' そのもの
end;
書き換えられるのはオブジェクト番号だけです。世代番号とトークン間の元の空白はそのままコピーされるため、出力は、変えなければならなかった 1 つの整数を除いて入力とバイト単位で同一です。この精度こそがすべてです。ソースバイトの再利用を、完全な再シリアライズに「近い」ものではなく等価なものにしているのはこのためです。自分でこの種のスキャナーを書くなら、裸の参照、配列の内側の参照、参照ではない数字、リテラル文字列、16 進文字列、そしてオフセット適用後の非ゼロの世代番号に対してテストしてください
ブックマークが AppendOutline を再利用できなかった理由
複数の文書のブックマークを 1 つのアウトラインツリーへマージするのは、既存の AppendOutline ヘルパーの仕事のように見えます。このヘルパーは、ある文書のトップレベルのブックマークを別の文書に移植する方法をすでに知っています。しかしここでは誤った道具であり、理由は微妙なレイヤーの不一致です。AppendOutline は、現在の最後のトップレベルブックマークを、リーダーを元のファイルバイトの上で歩かせることで見つけます。ところが fast マージは、編集を ChangeObject 経由で新規オブジェクトバッファにステージングします。リーダーはそれらの編集を見ません。3 つ以上の文書をこれに通すと、append のたびに、最初の文書の元の最終ブックマークが最新の文書へ付け替えられ、中間の文書たちのブックマークが連鎖から外れてしまいます。累積の /Count だけは正しく保たれるため、誰かがブックマークパネルを開くまで問題に気づきにくいのです
fast 経路はこれを、リーダーを二度と歩き直さない、メタデータ駆動の 2 フェーズ注入で解決します。すべての入力への最初のパスが、文書ごとに、アウトラインルートのオブジェクト番号と世代番号、最初と最後のトップレベルブックマークの番号、そしてルートの /Count を収集します。この要約から、コードは偽造する必要のあるすべてのリンクのグローバルオブジェクト番号を計算します。各文書のトップレベルの /Parent から共有ルートへ、最初のブックマークの /Prev から前の文書の最後へ、最後のブックマークの /Next から次の文書の最初へ。ここには書き出し順序の制約が隠れています。最初の文書のオブジェクトは、後続の文書がまだ開かれる前に書き出されるため、最初の文書のアウトライン編集(ルートの /Count と /Last、そして旧最終ブックマークの /Next)は、後の文書を手にせず済む算術として表現できなければなりません。各後続文書の編集は、開かれた後、書き出される前に、その場で適用されるため、同じ change-object 経路を通って出て行きます
すべてを繋ぐオフセット整合の不変条件
参照シフトもブックマーク注入も、1 つの算術不変条件に依存しています。そしてそれは設計全体の中で最も壊れやすい前提です。後続の文書へ注入される参照は、「ターゲットのグローバルオブジェクト番号から、その文書の Offset を引いた値」として書かれます。こうしておけば、オブジェクトが後で ShiftIndRef(Offset) によってシフトされるとき、値は意図したグローバル番号に着地します。最初の文書は Offset = 0 を受け取り、グローバル番号を直接使います。この減算が正しいためには、注入の間に使われる走行中のオフセット列が、オブジェクトの最終書き出しのときに使われるオフセット列と一致していなければなりません
一致します。ページとフォームのマージの仕組みの性質のためです。AddPages、AddFields、AddFieldFonts は、最初の文書の既存のオブジェクトだけを変更し、新しいオブジェクトは 1 つも追加しません。したがって最初の文書のオブジェクト数はページマージ段階を通して変化せず、各後続文書のオフセット(先行するすべての文書のオブジェクト数の和)は、注入から書き出しまで安定しています。これを壊す、つまりマージの途中に新しいオブジェクトを作る段階を挟むと、下流のすべてのページ参照とブックマーク参照が、追加したオブジェクト数ぶんだけずれます。この不変条件は静かですが、荷重を支えています
1 つのエンジンの上にある 3 つのエントリーポイント
fast 経路はマージコードのフォークではありません。バイトレベルのエンジンは 1 つの内部ルーチン MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode) であり、公開 API は 2 つのフラグを選ぶ薄いラッパーです
MergeFileListFastは、構造ツリーの保存を切ってエンジンを呼びます。最も軽い経路であり、タグ付き PDF のツリーを落とすことで、バイト経路が最大数のオブジェクトに適用されますMergeFileListは、保存を入れて呼びます。構造ツリーが生き残り、結果は使い物になるタグ付き PDF のままです。この通常経路は、複数文書のブックマークとフォームのマージも引き継ぎますMergeFileListStrictは strict モードを入れます。最初のメタデータパスが、きれいなマージを報告しない最初の入力で停止するため、壊れたファイルを読み飛ばして続行するのではなく、そのファイルより前に収集された文書だけが結果に含まれます
3 つすべてが 1 つのエンジンを共有しているため、通常マージも、各入力を 1 回だけ開く単一の線形パスとして走ります。ファイル 1 と 2 をマージし、その結果と 3 をマージし、と進んでいく、成長するアキュムレータを毎回再パースするペアワイズの O(N²) ループではありません。2 ファイルと 2 ストリームのエントリーポイント、MergeFiles と MergeStreams は、真にペアワイズのマージを求める呼び出し元のために、今も利用可能です
構造ツリーの振る舞いについて 1 つだけ注記します。バイトを調べて出力を検証する人には重要です。fast 経路は、最初の文書のカタログ参照から /StructTreeRoot を外すことでツリーを落としますが、構造ツリーのオブジェクト自体は、参照されないまま書き出されます。したがって fast 出力のバイトには /StructTreeRoot という文字列が残っており、この文字列を検索しても fast と通常の出力は区別できません。本当の違いは、カタログがまだ構造ツリーに届くかどうかであり、ファイルがナビゲート可能なタグ付き PDF のままであるかを決めるのはこちらです
どの経路をいつ選ぶか
バイト経路は、タグ付き PDF の構造ツリーを保存する必要のない、多数の文書の組み立て(レポートのバンドル、明細の一括処理、バッチ連結)のためのスループット最適化です。中規模から大規模の入力セットの反復マージで測ると、バイト再利用は、オブジェクト構成に応じて、ウォールクロック時間をおよそ 4% から 13% 短縮します。小さな入力や壊れた入力は、フルパス上とまったく同じように振る舞います。スキャナーが安全だと証明できないオブジェクトは、フルパースへフォールバックするからです。アクセシビリティのために構造ツリーを無傷で保つ必要があるなら、それを保存する通常の タグ付き PDF マージ経路を使ってください。多数の入力ではなく巨大な単一ファイルを扱うなら、ダイレクトファイルアクセスによる大規模 PDF マージと分割の姉妹編で述べるバイトコピーの技法が、同じ「バイトをコピーし、完全なオブジェクトツリーを避ける」思想をファイルスケールで適用します
マージルーチンとその fast および strict の変種は、PDF Library for Delphi Delphi PDF Library の一部です。そのドキュメントに、ファイルリスト API とここで述べたマージオプションの完全なリファレンスがあります