Un contratto esportato da un elaboratore di testi con la casella «tagged PDF» lasciata deselezionata appare comunque strutturato sullo schermo: un titolo in grassetto da 24 punti, clausole numerate, un listino tariffe con filetti. Convertitelo in HTML reflowable e il listino tariffe torna come una vera <table>, mentre il titolo è un <p> con esattamente lo stesso rango di una nota a piè di pagina. Quell'output è corretto. ISO 32000-1 §14.8 dà a un PDF esattamente un posto dove dire «questa sequenza di testo è un titolo», l'albero di struttura, e un file senza tag non ce l'ha. Dimensione e grassetto del font sono scelte tipografiche, e un convertitore che trasforma ogni riga grande e in grassetto in una <h1> promuoverà anche le citazioni evidenziate, i totali delle tabelle e il nome della società nella testata
La domanda che vale la pena porre a qualsiasi pipeline da PDF a HTML, allora, è da dove vengono nella sua uscita ogni titolo, voce di elenco e tabella, e fino a che punto ciascuno può essere fidato da un layout per telefono, uno screen reader o un indicizzatore di ricerca. Titoli e tabelle danno risposte diverse. Il passo di esportazione aggiunge le proprie scelte su interruzioni di riga, codifica dei caratteri e memoria
Da dove vengono titoli ed elenchi
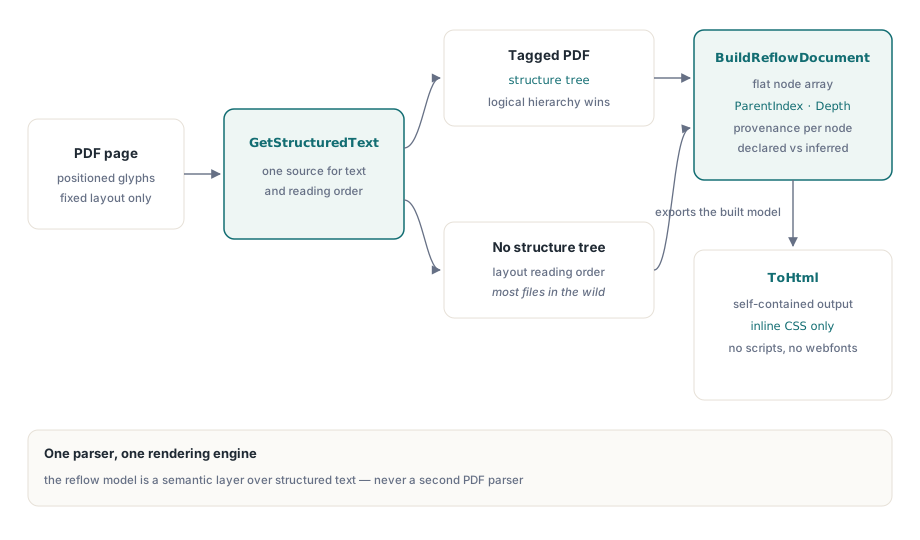
PDFium Component costruisce il modello di reflow con TPdf.BuildReflowDocument, e quel metodo prende ogni parola, blocco e suggerimento semantico da GetStructuredText, lo stesso layer di testo strutturato descritto in blocchi di testo strutturato e ordine di lettura. Non c'è un secondo parser e nemmeno un secondo estrattore di testo dietro. Per ogni pagina nell'intervallo richiesto raccoglie i blocchi in ordine di layout fisico. GetStructuredText ha già abbinato ogni blocco al contenuto con tag della pagina per area di sovrapposizione, e BuildReflowDocument copia sul blocco il ruolo che ha trovato: H fino a H6 diventano titoli con il proprio livello, LI, Lbl e LBody diventano voci di elenco, Figure diventa una figura il cui testo è la descrizione alternativa, e Caption diventa una didascalia
Due conseguenze seguono, ed entrambe facili da osservare. L'ordine dei blocchi segue sempre il layout della pagina, anche in un file con tag, quindi i tag decidono che cosa è un blocco e la geometria decide dove va. E su una pagina senza tag ogni blocco è un paragrafo. Titoli ed elenchi non vengono mai indovinati dalla dimensione del font
Ogni nodo porta un campo Source di tipo TPdfReadingOrderSource: rosStructure quando il ruolo veniva dall'albero di struttura, rosHeuristic quando veniva dal solo layout. L'HTML esportato lo ripete come data-source="structure" o data-source="inferred" su ogni elemento, e il TPdfReflowDocument.Source a livello documento è rosStructure solo quando ogni pagina dell'intervallo era taggata. Le tabelle sono sempre rosHeuristic, perché vengono dal rilevamento geometrico e non da tag Table. Se un passo a valle tratta i titoli come landmark di navigazione, controllate prima quel campo; un documento taggato vi dà landmark scelti dall'autore
Un array piatto di nodi invece di un albero di oggetti
TPdfReflowDocument.Nodes è un albero appiattito in pre-order: un solo dynamic array di record TPdfReflowNode, ognuno con un ParentIndex e una Depth. I nodi pagina stanno a profondità 0 con indice di padre -1. Paragrafi, titoli, figure, didascalie, elenchi e tabelle pendono dalla pagina a profondità 1, le voci di elenco stanno a profondità 2 sotto il proprio elenco, e le celle delle tabelle raggiungono la profondità 3 sotto una riga. Le voci di elenco consecutive condividono un solo nodo elenco; qualsiasi altro blocco o una tabella in mezzo ne fa partire uno nuovo
Il layout piatto è una decisione di portabilità. Un record ricorsivo che contiene un dynamic array di se stesso compila sotto Delphi, C++Builder e Free Pascal, ma i tre gestiscono i tipi gestiti ricorsivi in modo diversico attraverso un confine di package o DLL. Un array piatto di record semplici si comporta allo stesso modo in tutti e tre, e può essere messo in stream con un solo ciclo for e nessuna ricorsione
uses
  SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Node: TPdfReflowNode;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfReflowOptions.Default;   // tutte le pagine, tabelle attive, CSS attivo
    Doc := Pdf.BuildReflowDocument(Options);

    for I := 0 to High(Doc.Nodes) do
    begin
      Node := Doc.Nodes[I];
      case Node.Kind of
        prnkHeading:
          Writeln(Format('%sH%d [%s] %s', [StringOfChar(' ', Node.Depth * 2),
            Node.HeadingLevel,
            BoolToStr(Node.Source = rosStructure, True), Node.Text]));
        prnkTable:
          // su un nodo tabella RowSpan/ColumnSpan tengono i conteggi di righe e colonne della tabella
          Writeln(Format('%stable %dx%d, page %d, confidence %.2f',
            [StringOfChar(' ', Node.Depth * 2), Node.RowSpan, Node.ColumnSpan,
             Node.PageNumber, Node.Confidence]));
      end;
    end;

    Writeln(Format('%d node(s), %d table(s), %d character(s), pages %d-%d',
      [Length(Doc.Nodes), Doc.TableCount, Doc.CharacterCount,
       Doc.FirstPage, Doc.LastPage]));
  finally
    Pdf.Free;
  end;
end;
Sul contratto senza tag dell'apertura, quel ciclo non stampa alcuna riga H e una riga tabella per ogni listino tariffe rilevato. Esegitelo su una copia taggata dello stesso documento e i titoli appaiono con True accanto. FirstPage e LastPage nelle opzioni fanno default a 0, che significa prima e ultima pagina del documento; un intervallo fuori dal conteggio pagine solleva EPdfError prima che qualsiasi pagina sia letta
Perché il testo delle tabelle non compare due volte?
Il rilevamento delle tabelle gira su ogni pagina dopo che il testo strutturato è stato raccolto, il che significa che le parole dentro una tabella esistono due volte: una come blocchi di testo, una come celle. Emittete entrambe e ogni tabella nell'HTML è seguita dal proprio contenuto di nuovo come paragrafi sciolti, che è esattamente ciò che produce un merge ingenuo «aggiungi le tabelle al testo»
Il modello lo risolve geometricamente. Un blocco di testo la cui bounding box giace almeno per metà dentro i confini di una tabella rilevata viene scartato, e il nodo tabella prende il suo posto. Le tabelle vengono poi intrecciate con i blocchi rimanenti per posizione verticale (più in alto sulla pagina prima, con la sinistra-verso-destra come spareggio quando i bordi superiori stanno entro mezzo punto), così una tabella atterra tra il paragrafo sopra di lei e il paragrafo sotto invece di essere accodata alla fine della pagina
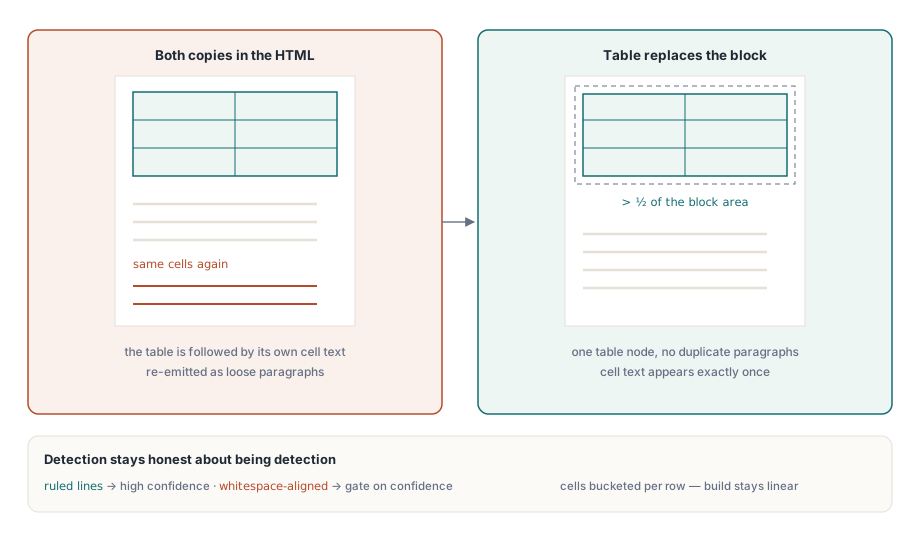
La soglia di mezza area ha un bordo visibile. Un blocco che cavalca il bordo della tabella e sta per lo più fuori sopravvive intatto, così una riga di testo può occasionalmente comparire sia nell'ultima riga sia nel paragrafo che segue. È il lato giusto su cui sbagliare. Una soglia abbastanza bassa da rimuovere ogni blocco in sovrapposizione cancellerebbe anche testo del corpo che tocca soltanto la bounding box di una tabella, e una riga duplicata è molto più facile da notare e perdonare di una frase mancante
Le tabelle rilevate portano anche una confidenza, e le due strategie di rilevamento atterrano in fasce diverse. Una tabella trovata dai filetti segna tra 0.88 e 1.0, a seconda di quante delle sue celle contengono testo. Una tabella dedotta puramente dall'allineamento degli spazi bianchi segna tra 0.58 e 0.88. La Confidence del nodo tabella conserva quel punteggio, ogni nodo cella lo ripete, e l'HTML lo scrive come data-confidence sull'elemento <table>. Le tabelle sotto TableOptions.MinConfidence (0.5 per default) non vengono mai create, e quando una tabella è respinta le sue parole semplicemente restano nel modello come paragrafi ordinari
Per un indice di ricerca o una vista di lettura per telefono, una tabella sbagliata costa poco e una rilevata correttamente è un gran miglioramento, quindi lasciate i default. Per una conversione d'archivio, dove una griglia inventata attorno a un indirizzo su due colonne è peggiore di nessuna griglia, restringete il rilevamento alle tabelle con filetti:
Options := TPdfReflowOptions.Default;
Options.DetectTables := True;
Options.TableOptions.DetectWhitespaceTables := False; // solo tabelle con filetti
Options.TableOptions.MinConfidence := 0.9;            // scarta anche le griglie con filetti rade
Options.TableOptions.MaxTables := 200;                // tetto sull'intero documento
Options.TableOptions.MaxCells := 50000;               // tetto sull'intero documento

Doc := Pdf.BuildReflowDocument(Options);
if Doc.TableCount = 0 then
  Writeln('No ruled tables; all page text is emitted as paragraphs');
Dentro una build di reflow, MaxTables e MaxCells vengono contati su tutto l'intervallo di pagine, non per pagina, quindi un estratto conto di 300 pagine con una tabella con filetti su ogni pagina ha bisogno di un MaxTables di almeno 300 o la build si ferma con EPdfError alla prima tabella sopra il limite. I default sono 1000 tabelle e 100000 celle
Per il lato rilevamento in sé, comprese i rettangoli sottili pieni disegnati come bordi e la continuazione attraverso le pagine, vedere rilevamento ed estrazione delle tabelle
Esportare HTML che non ha bisogno di nient'altro
TPdfReflowDocument.ToHtml percorre il modello già costruito e non tocca mai più PDFium, quindi esportare due volte lo stesso modello produce la stessa stringa. Con FullDocument impostato (il default) il risultato è una pagina completa: doctype, <meta charset="utf-8">, un meta tag viewport, una <title> presa dalla voce Title del documento (o «PDF document» quando è vuota), e un attributo lang dalla lingua del documento. Con FullDocument spento ottenete un singolo frammento <div class="pdf-reflow"> da incastare nel vostro template
Il foglio di stile opzionale da IncludeCss è un solo blocco <style> inline: una colonna di lettura di 72rem, ogni pagina PDF come scheda bianca quando IncludePageSections è attivo, bordi delle tabelle collassati, e una media query sotto 40rem che rimuove il padding della scheda e rimpicciolisce il testo delle tabelle. Non c'è script, né web font, né URL esterno, che è ciò che lascia il file stare dentro una email, un help viewer in stile CHM o un controllo browser in sandbox. I livelli di titolo fuori da 1 a 6 vengono scritti come h2, le celle di intestazione diventano th, e le celle con RowSpan o ColumnSpan sopra 1 prendono rowspan e colspan. Accendere IncludeGeometry aggiunge data-left, data-top, data-right e data-bottom in punti PDF, comodo per evidenziare un risultato di ricerca di nuovo sulla pagina renderizzata
PreserveLineBreaks merita una scelta deliberata. Un'interruzione di riga dentro un paragrafo PDF è stata fatta per una larghezza di colonna fissa; tenetela su uno schermo da 360 pixel e ogni riga va a capo due volte, lo strapiombo irregolare che il reflow esiste per togliere. Lasciatelo spento (il default) per la prosa. Accendetelo per i documenti dove l'interruzione porta significato, come indirizzi, versi o listati di codice, e scrive <br> al posto di uno spazio
Per un documento lungo, costruire l'intera pagina come una WString e poi codificarla raddoppia il picco di memoria. WriteHtml mette in stream lo stesso markup dentro un TPdfReportWriter invece, scrivendo ASCII con ogni carattere non ASCII come character reference numerico, così i byte sono validi a prescindere da come il lato ricevente indovina la codifica:
uses
  Classes, SysUtils, PDFium, FPdfAsync, FPdfReport;

procedure ExportReflowHtml(Pdf: TPdf; const FileName: string;
  const Token: IPdfCancellationToken);
var
  Options: TPdfReflowOptions;
  Doc: TPdfReflowDocument;
  Limits: TPdfReportLimits;
  Stream: TFileStream;
  Writer: TPdfReportWriter;
begin
  Options := TPdfReflowOptions.Default;
  Options.MaxNodes := 500000;
  Options.MaxCharacters := 20000000;
  Doc := Pdf.BuildReflowDocument(Options, Token);   // lo stato della pagina viene ripristinato dopo

  Limits := TPdfReportLimits.Default;
  Limits.MaxCharacters := 64 * 1024 * 1024;  // tetto dei byte di output, massimo 64 MiB
  Limits.MaxItems := Options.MaxNodes;       // una voce per nodo, massimo 1048576

  Stream := TFileStream.Create(FileName, fmCreate);
  try
    Writer := TPdfReportWriter.Create(Limits, Stream);  // lo stream resta di proprietà del chiamante
    try
      Doc.WriteHtml(Writer);
    finally
      Writer.Free;
    end;
  finally
    Stream.Free;
  end;
end;
WriteHtml controlla più di quanto faccia ToHtml. Rifiuta un modello con più nodi di Options.MaxNodes, fa rispettare Options.MaxCharacters sul testo che scrive, limita l'annidamento all'argomento MaxDepth (64 per default), e verifica che ogni ParentIndex punti a un nodo precedente. Quell'ultimo controllo conta se il vostro codice filtra o riscrive Nodes prima dell'export: un array modificato con un indice di padre in avanti solleva EPdfReportLimit invece di produrre markup con tag disaccoppiati
Budget, cancellazione e pagina corrente
Un PDF è input non fidato, e un file malformato o ostile può dichiarare migliaia di pagine di testo minuscolo. BuildReflowDocument controlla i budget di caratteri, nodi, tabelle e celle prima che ogni nodo sia aggiunto, così un file che li supera si ferma con EPdfError e un messaggio che nomina il budget («Reflow node budget exceeded», per esempio) mentre l'uso di memoria resta comunque limitato. Sia MaxCharacters sia MaxNodes devono essere positivi; i default sono 10.000.000 caratteri e 1.000.000 nodi
La IPdfCancellationToken opzionale viene controllata prima di ogni pagina, tra i blocchi, prima di ogni tabella e prima di ogni riga di tabella. Passate il Token di una TPdfCancellationTokenSource posseduta dalla vostra form, chiamate Cancel dall'handler del pulsante, e la build solleva EPdfOperationCancelled al prossimo di quei checkpoint. Intercettatela separatamente da EPdfError così che il cancel di un utente non venga loggato come file rotto. Qualunque eccezione chiuda la build, non viene restituito nulla di parziale; se il fallimento arriva più avanti dentro WriteHtml, il file di destinazione trattiene una pagina troncata, quindi cancellatelo nel vostro exception handler
Lo stato della pagina è il dettaglio da cui dipende il codice GUI. La build visita ogni pagina dell'intervallo muovendo PageNumber, e un try/finally rimette la pagina del chiamante al successo, a un fallimento di budget e a una cancellazione ugualmente. Un viewer che avvia un export mentre l'utente sta leggendo la pagina 340 è ancora sulla pagina 340 quando l'export ritorna
Dove sta il reflow
L'output del reflow sta bene come input per indicizzazione di ricerca, viste di lettura accessibili, schermi di telefono e migrazione di contenuti dentro una CMS. Scarta deliberatamente posizionamento assoluto, font esatti, grafica vettoriale e geometria di pagina, salvo le coordinate data-* opzionali. Quando un lavoro vuole che la pagina appaia identica, renderizzatela; quando vuole che le parole siano leggibili altrove, rifluite
Poiché titoli ed elenchi vengono solo dai tag, la qualità dell'HTML segue la qualità del tagging a monte. I documenti che passano i controlli in la validazione dell'albero di struttura PDF/UA producono modelli con una vera gerarchia di titoli, e lo stesso contenuto taggato alimenta le funzioni di lettura in costruire un reader accessibile
Reflow, testo strutturato, estrazione delle tabelle e rendering girano tutti contro lo stesso oggetto TPdf in Delphi, C++Builder e Lazarus; i record di opzioni, le eccezioni e il report writer sono documentati sulla pagina del prodotto PDFium Component per Delphi