Un utente non vedente apre un report trimestrale nel vostro nuovo e brillante viewer Delphi, attiva NVDA e sente il piè di pagina, poi una colonna di cifre, poi il titolo che qualsiasi lettore vedente avrebbe letto per primo. Oppure non sente proprio nulla. La pagina appare perfetta sullo schermo, ed è esattamente questa la trappola: rendering e lettura sono problemi diversi, risolti da codice diverso. L'ordine con cui un PDF dipinge i propri glifi non ha alcun obbligo di coincidere con l'ordine in cui una persona dovrebbe sentirli, quindi un viewer costruito solo su chiamate di rendering produce un'immagine impeccabile e una narrazione inutilizzabile. PDFium Component, il wrapper VCL/LCL attorno al motore PDFium per Delphi, C++Builder e Lazarus, porta con sé un insieme separato di API di lettura proprio per questo. Le API di disegno non possono recuperare un ordine di lettura che non hanno mai ricevuto
Un lettore accessibile regge o crolla su tre cose. Deve estrarre un ordine che uno screen reader possa pronunciare, tenere un cursore di parola visibile agganciato a qualunque cosa la voce stia dicendo, e ammettere quando un documento non è mai stato taggato invece di tirare a indovinare fingendo. Ciascuna ha una API chiara a cui rivolgersi e un guasto che morde se saltate il dettaglio
L'ordine di lettura vive nell'albero di struttura, non nell'ordine di disegno
ISO 32000-1 §14.8 definisce la struttura logica come un albero di elementi sovrapposto al contenuto della pagina. PDF/UA (ISO 14289-1) va oltre e rende quell'albero obbligatorio: ogni pezzo di contenuto reale deve essere raggiungibile attraverso di esso in ordine di lettura, con gli artifact di pagina marcati come tali e saltati. Un report taggato correttamente sa che "Quarterly Results" è un titolo di secondo livello e che la griglia dei totali è una tabella con celle di intestazione. Un report non taggato è un mucchio di sequenze di glifi posizionati che per caso somigliano a un documento
ReadablePageContent percorre quella struttura quando è presente e restituisce frammenti etichettati con un Kind semantico, valori come cfHeading e cfParagraph, così che la UI possa dire "titolo" prima delle parole anziché leggere una riga in grassetto come normale testo corrente. Senza un albero utilizzabile, la stessa chiamata ripiega su un'analisi euristica del layout: rilevare le colonne, raggruppare le linee di base, ordinare da sinistra a destra e dall'alto in basso. Quel ripiego va bene per un promemoria a colonna singola ed è traballante per una newsletter, un modulo a più colonne, qualsiasi cosa con una barra laterale o una citazione in evidenza. Ciò che conta è sapere quale risultato avete ottenuto, e la API ve lo dice apertamente. Il record TPdfReadableContent porta un campo Source impostato a rosStructure quando l'ordine viene dall'albero taggato, oppure a rosHeuristic quando è stato dedotto dalla geometria. Mostrate un ordine indovinato come se fosse verificato e avrete distribuito la versione accessibilità di un bollino verde su una build che nessuno ha eseguito
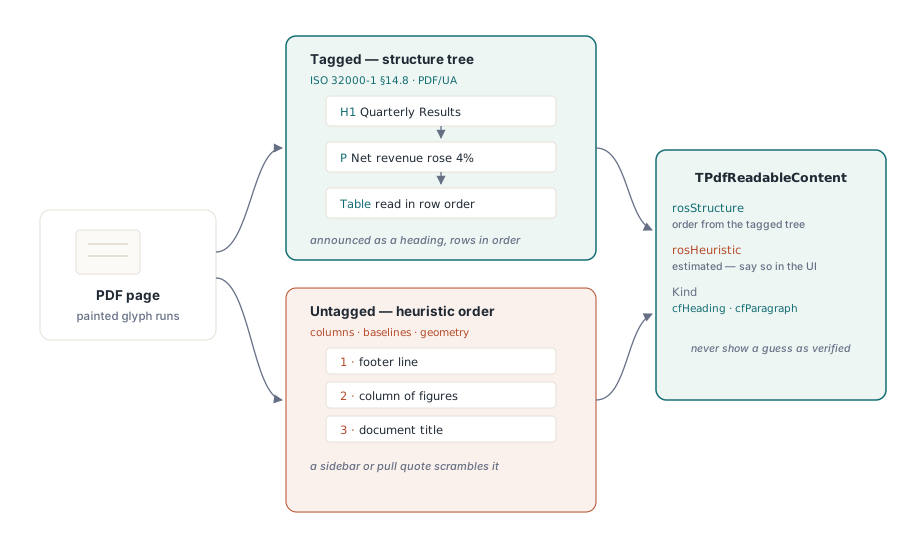
La mossa a buon mercato al momento dell'apertura è leggere IsTagged e chiamare ValidatePdfUa una volta sola, poi mettere in cache la risposta. Un controllo PDF/UA fallito non è motivo per rifiutare il file. È motivo per mettere "ordine di lettura stimato" nella barra di stato, così che quando un cliente invia un reclamo su una narrazione confusa l'assistenza sappia già se ha davanti un problema di tag nel file o un bug nel vostro codice
Dalla pagina alla coda vocale con ReadingUnits
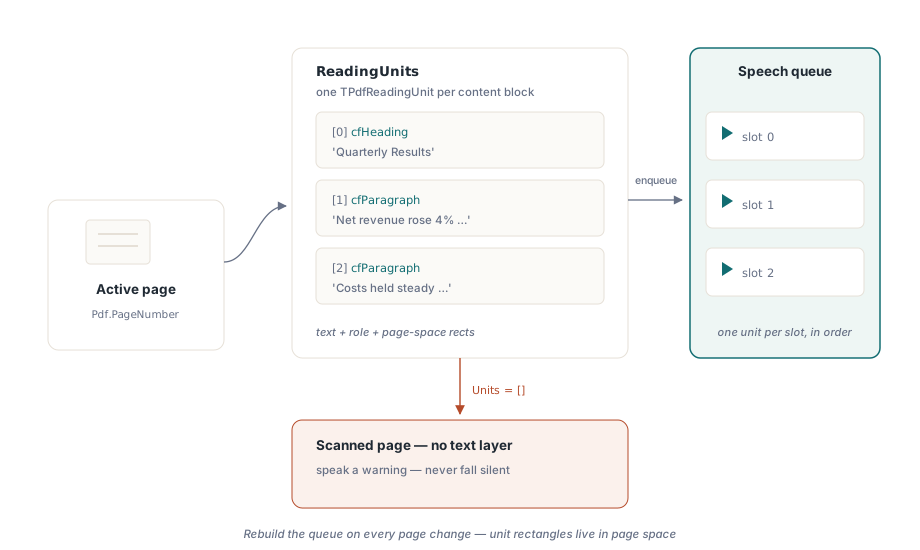
Per la sintesi vocale, ReadingUnits fa il lavoro pesante. Restituisce un array di record TPdfReadingUnit per la pagina attiva, ciascuno contenente il testo da pronunciare, il suo ruolo semantico e i rettangoli che lo collocano sulla pagina. Esiste un compagno a livello di documento, DocumentReadingUnits, per quando volete una lettura continua tra le pagine. Una unità entra direttamente in una posizione della coda vocale:
procedure TReaderForm.QueuePageSpeech(PageNumber: Integer);
var
  Units: TPdfReadingUnits;
  i: Integer;
begin
  Pdf.PageNumber := PageNumber;   // ReadingUnits opera sulla pagina attiva
  Units := Pdf.ReadingUnits;
  FSpeechQueue.Clear;
  for i := Low(Units) to High(Units) do
    FSpeechQueue.Add(Units[i]);  // testo + semantica + rettangoli di evidenziazione
  FCurrentPage := PageNumber;
  SpeakNextUnit;
end;
Due cose in quel ciclo si sbagliano facilmente. Tenete la coda per pagina e ricostruitela ogni volta che l'utente naviga, perché le unità di lettura portano rettangoli nello spazio della pagina; una coda rimasta dalla pagina tre dipingerà le proprie evidenziazioni sulla pagina quattro. E trattate un array Units vuoto su una pagina che chiaramente ha contenuto come il vostro rilevatore di sole immagini. Una pagina scansionata è fatta di pixel senza alcuno strato di testo sotto, e la risposta giusta è pronunciare un avviso ("questa pagina non contiene testo estraibile") anziché ammutolire in un modo che chi ascolta non riesce a distinguere da un blocco
Un cursore di parola che segue la voce
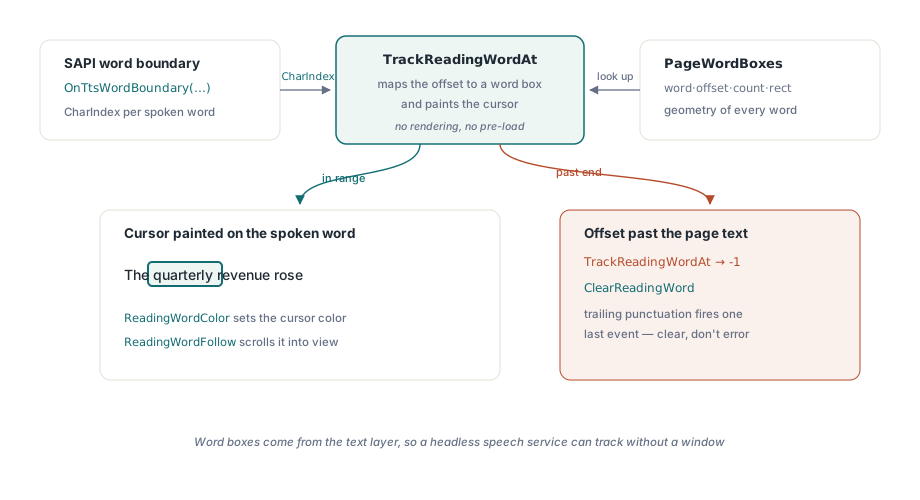
Evidenziare un intero paragrafo alla volta risulta lento a un utente ipovedente che segue le parole con lo sguardo mentre vengono lette ad alta voce. L'evidenziazione a livello di parola, l'effetto karaoke, richiede due pezzi: la geometria di ogni parola e un modo per mappare le segnalazioni di avanzamento del motore TTS su quella geometria. PageWordBoxes vi dà la geometria come record TPdfWordBox, ciascuno con il testo della parola, il suo scostamento di carattere, il suo numero di caratteri e un rettangolo nello spazio della pagina. TrackReadingWordAt vi dà la mappatura. Passategli la posizione di carattere che l'evento di confine di parola di SAPI già riporta, e risolve quello scostamento in un indice nell'array dei riquadri di parola, disegnando il cursore sulla parola corrispondente in una sola chiamata
procedure TReaderForm.PrepareKaraoke(PageNumber: Integer);
begin
  // I riquadri di parola della vista vengono dalla pagina che la vista mostra.
  // Impostare solo Pdf.PageNumber non sposterebbe la vista
  PdfView.PageNumber := PageNumber;
  FWordBoxes := PdfView.PageWordBoxes;
end;

procedure TReaderForm.OnTtsWordBoundary(Sender: TObject; CharIndex: Integer);
var
  WordIdx: Integer;
begin
  // TrackReadingWordAt mappa lo scostamento E disegna il cursore di parola
  WordIdx := PdfView.TrackReadingWordAt(FCurrentPage, CharIndex);
  if WordIdx < 0 then
    PdfView.ClearReadingWord;  // il confine è andato oltre il testo di pagina
end;
Il contratto è generoso su un fronte e inflessibile su un altro. La parte generosa: TrackReadingWordAt mantiene una propria cache di riquadri di parola per la pagina che sta seguendo, quindi non c'è nulla da precaricare, e non avviene alcun rendering perché i riquadri di parola vengono dallo strato di testo. Un servizio vocale headless senza alcuna finestra visibile può comunque seguire le posizioni. La parte inflessibile: l'indice di carattere deve puntare dentro il testo che il componente ha estratto, non dentro una stringa ripulita che avete costruito voi. Quando CharIndex supera la fine del testo di pagina, la funzione restituisce -1 anziché sollevare un'eccezione, il che accade in continuazione quando un motore TTS emette un ultimo evento di confine per la punteggiatura finale. Leggete -1 come "azzera il cursore", mai come un errore
Sul fronte della visualizzazione, ReadingWordColor imposta il colore del cursore. L'ambra predefinita regge sulla maggior parte degli sfondi di pagina, ma provatela sotto ogni filtro di visualizzazione che il vostro viewer offre. Un cursore ambra può sparire del tutto sotto l'inversione dei colori, e l'inversione usata insieme alla voce è esattamente il modo in cui lavora un utente ipovedente, quindi l'unica combinazione che più di ogni altra dovete azzeccare è quella che una demo veloce non esercita mai. Impostate ReadingWordFollow a True e la vista fa scorrere da sola la parola pronunciata dentro il campo visivo, cosa di cui non potete fare a meno su una pagina ingrandita che deborda oltre lo schermo. Attenzione a una regola di ambito: SetReadingWord disegna soltanto sulla pagina TPdfView attiva. Decidete in anticipo se lo scorrimento manuale mette in pausa la voce oppure se il comportamento di inseguimento ha la precedenza, perché non scegliere nessuno dei due lascia la voce che continua a leggere mentre il cursore se ne sta da qualche parte fuori schermo
I documenti che rompono il vostro lettore
Una manciata di forme di input mette in crisi un'implementazione ingenua con una regolarità tale da meritare un posto come campioni permanenti nella suite di regressione, non come bug occasionali che correggete e dimenticate
- File non taggati ma ricchi di testo. L'ordine euristico tende a essere giusto per un report lineare e sbagliato nel momento in cui entra una barra laterale o una citazione in evidenza. Segnalate l'ordine come stimato, sia nella UI sia nel vostro log diagnostico, così che il guasto resti leggibile in seguito
- Scansioni di sole immagini. Nessuno strato di testo, in alcun modo. Individuatele tramite unità di lettura vuote e indirizzate l'utente a un passaggio OCR a monte invece di lasciare che il lettore narri una pagina vuota
- Caratteri combinanti e scritture miste. I segni combinanti Unicode non si riducono sempre uno-a-uno in parole visive, quindi il numero di riquadri di parola può divergere da quello che si aspetta il vostro tokenizzatore. Non indicizzate l'array dei riquadri di parola con scostamenti che avete calcolato spezzando il testo per conto vostro; usate soltanto gli indici che
TrackReadingWordAtrestituisce
Collaudatelo da revisori, non da demo
"Ha letto il mio campione ad alta voce" non dimostra niente. Un esito che potete difendere passa tre file attraverso la build finita con NVDA collegato: un file notoriamente taggato, dove i titoli vengono annunciati come titoli e una tabella viene letta in ordine di riga; un file notoriamente non taggato, dove l'indicatore di ordine stimato è visibile; e una scansione, dove l'avviso di assenza di testo viene davvero pronunciato. Ciascuno esercita un percorso che il caso felice salta
Da lì, verificate che il cursore di parola resti agganciato a velocità di voce doppia e dimezzata, e che lo scorrimento di ReadingWordFollow non litighi con lo scorrimento dell'utente. Poi fate girare la voce mentre passate in rassegna ogni filtro di colore e osservate che il cursore non sparisca mai. L'articolo sui filtri di colore per ipovedenti tratta in dettaglio quel percorso di rendering, e l'approfondimento sul cursore di parola parlata smonta la temporizzazione TTS
Le API di unità di lettura e di riquadri di parola usate qui sopra sono distribuite con PDFium Component per Delphi e C++Builder (VCL) e Lazarus/FPC (LCL). La pagina di prodotto rimanda al riferimento completo delle API, comprese le disposizioni dei record per unità di lettura e riquadri di parola dietro questi esempi