Una funzione di lettura ad alta voce ha un solo compito visibile oltre alla voce: mentre ogni parola viene pronunciata, deve accenderla sulla pagina e tenerla in vista. Per farlo vi serve il rettangolo di delimitazione di ogni parola, indicizzato sullo stesso flusso di caratteri da cui legge il motore vocale. Ottenete i rettangoli ma sbagliate l'indicizzazione e l'evidenziazione resta indietro di una o due parole rispetto all'audio; azzeccate l'indicizzazione ma gestite male lo stato della pagina e l'evidenziazione finisce sulla pagina sbagliata. La parte vocale di tutto questo, il sintetizzatore in sé, è quella che raramente si rompe. SAPI riporta i confini di parola al carattere. Ciò che si rompe è il sottile strato di mappatura fra un offset di carattere nel buffer vocale e un rettangolo sulla pagina renderizzata
PDFium Component fornisce quella mappatura per Delphi, C++Builder e Lazarus, con i word box disponibili dalla v1.53 e il cursore di tracciamento dalla v1.56. La superficie è deliberatamente stretta: una chiamata che restituisce i word box di una pagina, un tracker che trasforma un offset di carattere in un'evidenziazione dipinta, e un paio di proprietà per il colore e lo scorrimento automatico. Per quanto stretta, l'ordine in cui chiamate le cose decide se la funzione funziona, e la maggior parte dei guasti descritti sotto nasce dal chiamare le funzioni giuste nella sequenza sbagliata
I caratteri non sono parole, e i motori TTS parlano in caratteri
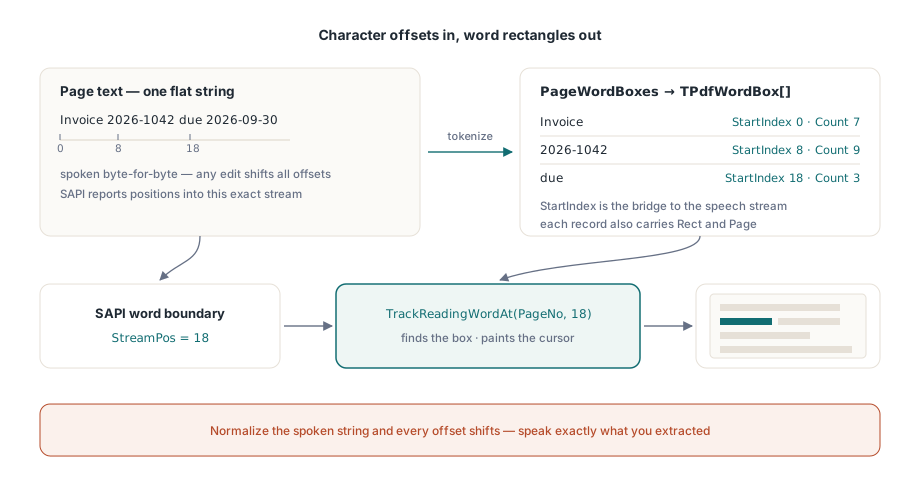
Un motore vocale consuma una stringa piatta e riporta l'avanzamento come posizioni di carattere dentro quella stringa. Una pagina PDF ha glifi collocati nello spazio pagina, dove una parola è un raggruppamento euristico di sequenze di glifi. I due sistemi di coordinate non condividono nulla a meno che il testo che consegnate al sintetizzatore non sia byte per byte il testo da cui sono stati calcolati i word box. Questa è la regola numero uno, ed è implacabile. Normalizzate gli spazi, togliete i trattini morbidi o in qualunque altro modo ripulite il testo estratto prima di pronunciarlo, e ogni offset a valle sarà silenziosamente sbagliato. Pronunciate esattamente ciò che avete estratto, oppure tenete una tabella esplicita di rimappatura degli offset. Non esiste una terza opzione che sopravviva a documenti reali
La tabella di rimappatura non è un caso limite ipotetico. Nel momento in cui la vostra interfaccia inserisce un annuncio di pagina parlato (pagina cinque) o espande un'abbreviazione per il sintetizzatore, la stringa pronunciata diverge da quella estratta. Registrate posizione e lunghezza di ogni inserimento, poi sottraete l'aggiustamento accumulato prima di ogni chiamata di tracciamento. Sono forse venti righe di contabilità, e sono la differenza fra un'evidenziazione che sopravvive alla prossima richiesta di funzionalità e una che si rompe la prima volta che qualcuno chiede i titoli pronunciati
Che cosa vi dà un word box
Ogni record TPdfWordBox porta con sé il testo della parola, il suo StartIndex e il Count di caratteri dentro il testo della pagina, un Rect nello spazio pagina e il numero di Page in base 1. Il campo StartIndex è il ponte fra i due sistemi di coordinate: è lo stesso offset che SAPI restituirà mentre legge. PageWordBoxes restituisce l'array completo della pagina attiva:
procedure TReaderForm.PreparePage(PageNo: Integer);
begin
  PdfView.PageNumber := PageNo;   // i word box della vista seguono la pagina mostrata

  FWords := PdfView.PageWordBoxes;
  FPageText := BuildSpeechText(FWords);   // concatena Word.Text in ordine

  if Length(FWords) = 0 then
    HandleImageOnlyPage(PageNo);          // una scansione senza livello di testo
end;
Il commento sull'ordine regge tutto il peso. PageWordBoxes del viewer tokenizza il livello di testo della pagina che la vista sta mostrando, quindi navigate prima la vista ed estraete dopo; non serve alcun rendering, soltanto un documento aperto. (Il componente documento, TPdf, espone il proprio PageWordBoxes legato a Pdf.PageNumber per uso headless. I due numeri di pagina sono indipendenti, e questa è una trappola a sé.) Un risultato vuoto su una pagina che visibilmente contiene contenuto significa una scansione di sole immagini. Instradatela verso l'OCR, o almeno annunciatela (la pagina 4 non contiene testo leggibile), invece di lasciare che la voce taccia senza spiegazioni
Collegare i confini di parola SAPI al tracker
TrackReadingWordAt, sul viewer, è il perno dell'intera funzionalità. Dategli un numero di pagina e un indice di carattere; trova il word box che contiene quel carattere, dipinge su di esso il cursore di lettura e restituisce l'indice della parola, oppure −1 quando l'indice cade fra due parole. La notifica di confine di parola di SAPI fornisce esattamente la posizione di carattere che gli serve:
procedure TReaderForm.OnSpeechWordBoundary(StreamPos: Integer);
var
  WordIdx: Integer;
begin
  // Mappa l offset su un word box e sposta l evidenziazione in una chiamata
  WordIdx := PdfView.TrackReadingWordAt(FPageNo, StreamPos);
  if WordIdx < 0 then
    Exit;                     // confine fuori da ogni parola: tieni l evidenziazione
end;
Qui due dettagli difensivi si guadagnano il posto. Primo, TrackReadingWordAt mantiene una propria cache dei word box per la pagina tracciata, ricostruita automaticamente quando la pagina cambia, così il costo per confine resta piatto per quanto rapidamente arrivino i confini. Secondo, non controlla i limiti con generosità. Un indice pari o superiore al numero di caratteri della pagina restituisce −1 invece di ridursi all'ultima parola. Trattate −1 come mantieni l'evidenziazione precedente, mai come un errore, perché sequenze di punteggiatura e spazi fra parole producono legittimamente confini che non appartengono a nessuna parola. Registrare ogni −1 vi sommergerà. Contateli invece per pagina, e guardate con attenzione qualsiasi pagina in cui il rapporto si impenna, perché di solito significa una discrepanza di normalizzazione del testo che riporta alla regola numero uno
Il cursore in sé: colore, inseguimento e pulizia
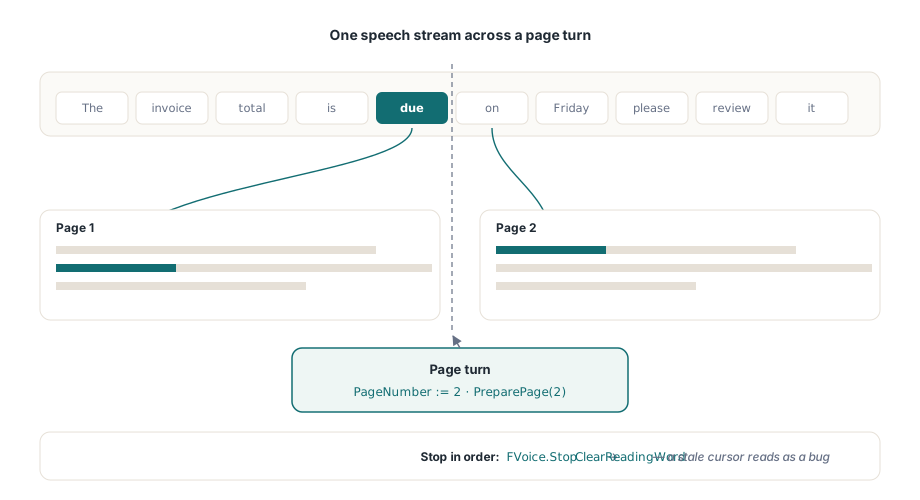
SetReadingWord dipinge l'evidenziazione direttamente quando tenete voi il word box, ReadingWordColor ne definisce lo stile, e ReadingWordFollow := True scorre la vista quanto basta per tenere visibile la parola pronunciata. Quest'ultima proprietà si guadagna il posto. Uno scorrimento fatto a mano che centra la parola corrente fa sobbalzare la pagina a ogni interruzione di riga, e i lettori sensibili al movimento disattiveranno l'intera funzione nel giro di un minuto. L'evidenziazione viene disegnata soltanto sulla pagina attualmente mostrata nel TPdfView attivo, quindi la lettura su più pagine deve far avanzare PageNumber di pari passo con la voce, e poi rieseguire il passo di preparazione per la nuova pagina prima che arrivi il suo primo evento di confine. Saltate quel passaggio e le prime evidenziazioni di ogni pagina punteranno a coordinate obsolete
procedure TReaderForm.StopReading;
begin
  FVoice.Stop;                // prima ferma la riproduzione SAPI
  PdfView.ClearReadingWord;   // poi togli l evidenziazione; un cursore obsoleto sembra un bug
end;
La simmetria alla chiusura è ciò che tiene onesta l'evidenziazione. Ogni percorso di pausa, arresto e cambio pagina deve terminare in ClearReadingWord. Ometterlo e un rettangolo ambra resta su una pagina ferma con l'aspetto esatto di un difetto, che è il genere di cosa che ogni tester segnalerà anche se in realtà non è rotto nulla
La velocità di lettura mette sotto sforzo questa pipeline più di quanto faccia la dimensione del documento. A 300 parole al minuto gli eventi di confine arrivano ogni 200 ms, e alle velocità SAPI più alte arrivano più in fretta di quanto l'occhio segua comodamente. La risposta giusta è fondere, non accodare. Se un nuovo confine arriva mentre un aggiornamento dell'evidenziazione è ancora in sospeso, scartate quello vecchio e dipingete l'ultimo. Un cursore che visita ogni parola in ordine ma resta indietro di mezzo secondo dà l'impressione di essere rotto; uno che ogni tanto salta una parola restando in sincronia con la voce no
Casi limite che separano i demo dai prodotti
Alcune categorie di documento mettono a nudo le cuciture. I caratteri combinanti sono i più sottili: sequenze Unicode come una lettera base più un segno diacritico combinante possono occupare più indici di carattere di quanti la parola visiva suggerisca, quindi qualsiasi aritmetica sugli offset che assuma un indice per glifo va lentamente alla deriva. È l'argomento più forte per lasciare che sia TrackReadingWordAt a possedere la mappatura invece di calcolare a mano i numeri di parola. La sillabazione è più banale ma più comune: una parola spezzata da un a capo diventa due box, e se la pronunciate come un unico token, l'evento di confine della sua seconda metà si risolve sul primo box. Di solito va bene, ma è una decisione, quindi prendetela di proposito invece di scoprirla. La taggatura cambia lo stesso ordine di lettura. Quando un documento porta tag di struttura corretti (il territorio di ISO 14289, PDF/UA), la sequenza delle parole segue la struttura logica; senza di essi ricade su euristiche di layout, e una pagina non taggata a due colonne può essere letta orizzontalmente attraverso entrambe le colonne. Le pagine ruotate sono l'ultimo caso comune: il Rect di ogni parola la delimita ancora correttamente nello spazio pagina, ma una politica di inseguimento del viewport tarata sul flusso orizzontale scorre in modo stridente quando il testo va in verticale, quindi tenete almeno un documento ruotato nella suite di regressione. Per la gestione dell'ordine di lettura, le unità a livello di frase tramite ReadingUnits e lo stack assistivo più ampio, vedete costruire un reader PDF accessibile in Delphi
Un vincolo di piattaforma modella il deployment. SAPI esiste solo su Windows. L'API dei word box e del tracciamento è identica byte per byte sotto Lazarus e FPC, ma le build Linux e macOS hanno bisogno di un sintetizzatore diverso collegato dietro gli stessi eventi di confine; quella configurazione è trattata in eseguire il viewer sotto Lazarus e FPC. Il costo dell'evidenziazione interagisce anche con la vostra cache di pagina quando la velocità di lettura sale, e l'aritmetica del budget in cache di rendering e prestazioni dello zoom si trasferisce qui senza modifiche
Quando evidenziare una sola parola è la granularità sbagliata
Il karaoke a livello di parola non è sempre ciò che un lettore vuole. Ad alte velocità di lettura il cursore che sfarfalla parola per parola diventa esso stesso rumore visivo, e alcuni ascoltatori seguono una frase più comodamente di uno stroboscopio di parole singole. Per quel caso il componente espone un'unità più grossolana. ReadingUnits restituisce unità a livello di frase e di blocco, ciascuna con i propri rettangoli di evidenziazione, e le dipingete con SetReadingHighlight invece che con SetReadingWord. Il collegamento ha la stessa forma: un offset di confine guida ancora quale unità si accende, ma l'unità che evidenziate copre una proposizione o una riga invece di un singolo token. Sia i lettori più lenti sia la riproduzione ad alta velocità tendono a preferirla, e nulla vi impedisce di offrire entrambe le modalità dietro un'impostazione
Vale la pena fissare i requisiti minimi di versione prima di costruirci sopra: i word box richiedono PDFium Component v1.53 o successiva, e il cursore di tracciamento richiede la v1.56. L'API di lettura completa, le unità a livello di frase e un demo funzionante di lettura ad alta voce si trovano nella pagina di prodotto di PDFium Component