Un articolo di conferenza a due colonne ordinato per posizione verticale torna con una prima riga come Abstract We measure the 2 Related work Earlier studies: le parole di apertura della colonna di sinistra e quelle della colonna di destra, incollate insieme perché entrambe stanno sulla stessa baseline. Niente è andato storto nel parser. Una pagina PDF offre due ordini difendibili per il suo testo, la sequenza in cui il content stream lo dipinge e la posizione di ogni glyph sulla pagina, e per molti layout quei due ordini sono in disaccordo. Un estrattore che restituisce blocchi posizionati invece di una stringa ti lascia vedere quale ordine hai ottenuto e cambiare quando è quello sbagliato per la pagina che hai davanti
Cosa restituisce GetStructuredText
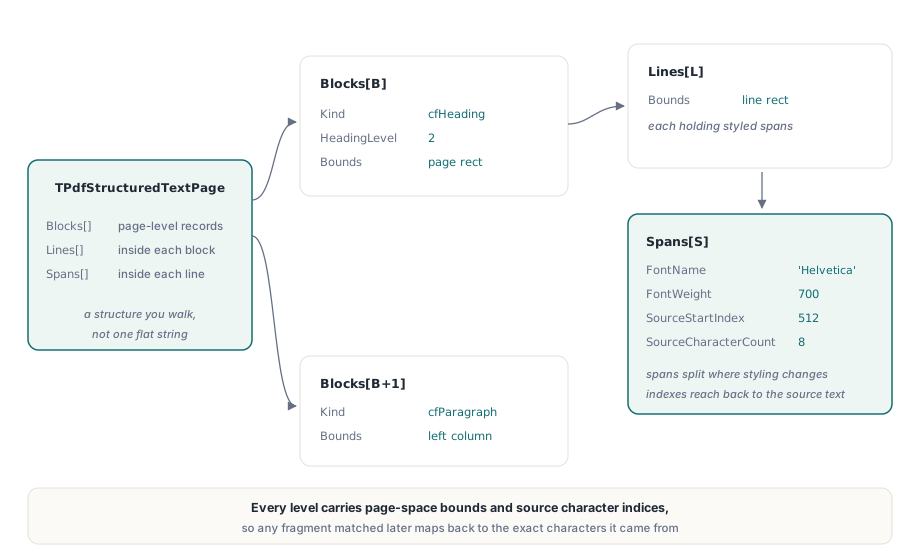
TPdf.GetStructuredText in PDFium Component restituisce una TPdfStructuredTextPage per la pagina corrente: un array di blocchi, ogni blocco un array di righe, ogni riga un array di span stilizzati. Ogni livello porta il proprio Text e un rettangolo Bounds nello spazio pagina in punti PDF, così un titolo, una singola riga o una frase in grassetto si possono collocare sulla pagina senza una seconda ricerca. Il record di pagina aggiunge Width, Height, CharacterCount e due contatori di qualità descritti più avanti
Il Page.Text appiattito viene costruito dai blocchi anziché dallo stream di caratteri grezzo. Le righe dentro un blocco sono giunte con un solo CRLF e i blocchi sono separati da una riga vuota, il che significa che un dump testo semplice di Page.Text mostra già dove l'estrattore ha tracciato i suoi confini di blocco. Questo lo rende la cosa più rapida da stampare quando una pagina si legge stranamente
Tutto questo è guidato da un piccolo record di opzioni. TPdfStructuredTextOptions.Default imposta ReadingOrder a roPhysicalLayout, accende IncludeFontInfo e IncludeSemantics, e porta MaxCharacters a 1.000.000. Il campo dell'ordine di lettura è quello che cambia di più la forma dell'output
Come i due ordini di lettura costruiscono righe e blocchi
roContentOrder conserva la sequenza di disegno del producer, mentre roPhysicalLayout ricostruisce l'ordine dalle posizioni dei glyph, e la differenza appare prima di tutto in come si formano le righe. In ordine di contenuto, i caratteri vengono presi nell'ordine in cui la pagina li disegna. Una nuova riga inizia a un a capo esplicito o quando il prossimo carattere non si sovrappone più verticalmente alla riga corrente. Una riga poi si unisce al blocco direttamente precedente solo se i due si sovrappongono orizzontalmente per almeno un quinto della larghezza minore e il gap verticale non supera circa due e un quarto di altezze di riga; altrimenti apre un nuovo blocco. I blocchi restano in ordine di disegno
Il layout fisico butta via la sequenza di disegno. Ogni carattere con un box noto viene ordinato per il centro verticale di quel box, cima della pagina prima, poi per il suo bordo sinistro. I caratteri le cui estensioni verticali si sovrappongono abbastanza condividono una riga, e quel test guarda solo l'altezza. La distanza orizzontale non ci gioca nessuna parte. Ogni riga poi si unisce al blocco esistente, ovunque sulla pagina, che le calza meglio secondo la stessa regola di sovrapposizione-e-gap, e i blocchi finiti vengono ordinati per il loro bordo superiore, col bordo sinistro che scioglie i pareggi entro mezzo punto
Quella seconda regola è la provenienza dell'esempio iniziale. Quando le due colonne di un articolo condividono una griglia di baseline, la prima riga della colonna di sinistra e la prima della colonna di destra si sovrappongono verticalmente, quindi il layout fisico le mette su una riga. Il gap alla colonna di mezzo è più largo di un quarto della dimensione del font, così l'estrattore inserisce uno spazio e continua. Ogni riga del corpo fa lo stesso, le righe fuse si sovrappongono tutte orizzontalmente fra loro, e l'intero corpo a due colonne diventa un unico blocco largo che legge dritto attraverso la colonna di mezzo
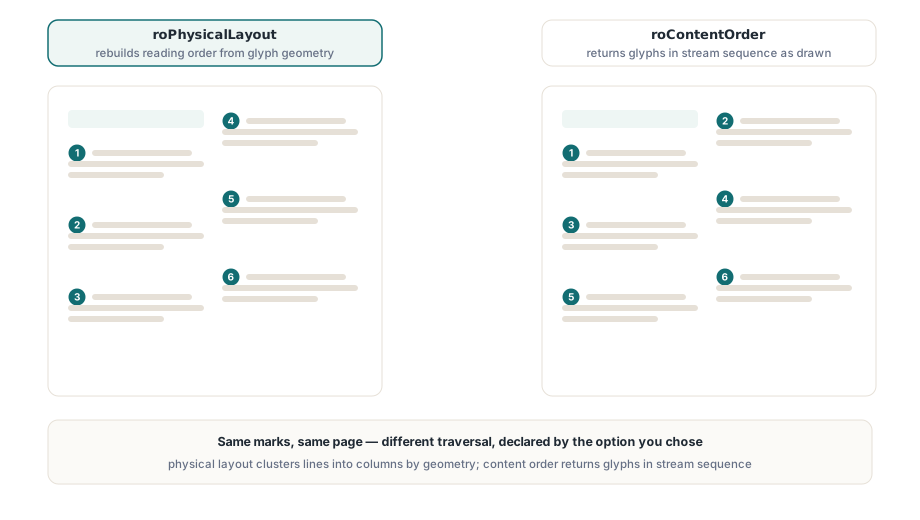
L'ordine di contenuto gestisce bene quella pagina ogni volta che il producer ha scritto la colonna uno prima della colonna due, che è ciò che word processor e sistemi di composizione fanno di norma. Le righe della colonna sinistra si impilano in blocchi, la prima riga della colonna destra non ha sovrapposizione orizzontale con loro e apre un blocco fresco, e i blocchi escono nell'ordine in cui l'autore li ha scritti. Il layout fisico si guadagna il posto su un altro tipo di pagina: fatture, estratti conto, form e slide, dove un'etichetta e il suo valore stanno sulla stessa baseline e leggere la riga da sinistra a destra è esattamente ciò che vuoi. È anche la modalità da usare quando la sequenza di disegno è priva di senso, per esempio testo dipinto font per font o una pagina assemblata da molti piccoli overlay
Per una collezione mista, dividi la scelta per tipo di documento. Articoli, report e manuali da uno strumento di authoring noto passano per roContentOrder; le form e i documenti transazionali restano sul predefinito roPhysicalLayout. La routine che segue stampa i blocchi di una pagina in ordine di contenuto, con i titoli marcati quando il file è con tag
uses
  SysUtils, PDFium;

procedure DumpBlocks(Pdf: TPdf; PageNumber: Integer);
var
  Options: TPdfStructuredTextOptions;
  Page: TPdfStructuredTextPage;
  B, L: Integer;
begin
  Pdf.PageNumber := PageNumber;                 // 1-based
  Options := TPdfStructuredTextOptions.Default;
  Options.ReadingOrder := roContentOrder;      // producer che vanno colonna per colonna

  Page := Pdf.GetStructuredText(Options);
  if Page.Source = rosStructure then
    Writeln('block kinds come from the structure tree')
  else
    Writeln('block kinds are inferred from layout');

  for B := 0 to High(Page.Blocks) do
  begin
    if Page.Blocks[B].Kind = cfHeading then
      Writeln(Format('[%d] H%d  %s',
        [B, Page.Blocks[B].HeadingLevel, Page.Blocks[B].Text]))
    else
    begin
      Writeln(Format('[%d] x=%.0f..%.0f, %d line(s)',
        [B, Page.Blocks[B].Bounds.Left, Page.Blocks[B].Bounds.Right,
         Length(Page.Blocks[B].Lines)]));
      for L := 0 to High(Page.Blocks[B].Lines) do
        Writeln('      ', Page.Blocks[B].Lines[L].Text);
    end;
  end;
end;
Come si rileva una riga che corre oltre la colonna di mezzo?
Una riga fusa si tradisce attraverso i suoi span. GetStructuredText inizia un nuovo span ogni volta che il prossimo carattere non è il successore diretto del precedente nella sequenza di caratteri originale della pagina, in aggiunta ai cambi di stile trattati sotto. Dentro una colonna, le parole consecutive sono di solito consecutive nella sorgente. Alla colonna di mezzo di una riga fusa l'indice sorgente salta di centinaia di caratteri, e il gap orizzontale tra i due span è molto più largo di qualunque word space
Quei due segnali insieme formano un test affidabile, e puoi farlo girare sull'output predefinito prima di decidere se una pagina ha bisogno invece dell'ordine di contenuto. Lo snapshot dei dati di caratteri che GetStructuredText legge viene messo in cache per pagina, otto pagine come predefinito, quindi chiedere la stessa pagina una seconda volta con un ReadingOrder diverso raggruppa di nuovo dati già in memoria invece di estrarre di nuovo la pagina
// LineCrossesGutter è un aiutante che aggiungi tu: segnala una riga che tiene due
// span vicini che sulla pagina sono lontani e nella sequenza di caratteri
// sorgente non sono adiacenti
function LineCrossesGutter(const Line: TPdfStructuredTextLine;
  MinGap: Double): Boolean;
var
  S: Integer;
  Prev, Cur: TPdfStructuredTextSpan;
begin
  Result := False;
  for S := 1 to High(Line.Spans) do
  begin
    Prev := Line.Spans[S - 1];
    Cur := Line.Spans[S];
    if (Prev.SourceStartIndex < 0) or (Cur.SourceStartIndex < 0) then
      Continue;                                 // blocchi di testo alternativo
    if (Cur.Bounds.Left - Prev.Bounds.Right > MinGap) and
       (Cur.SourceStartIndex <>
        Prev.SourceStartIndex + Prev.SourceCharacterCount) then
      Exit(True);
  end;
end;

function ExtractWithFallback(Pdf: TPdf): TPdfStructuredTextPage;
var
  Options: TPdfStructuredTextOptions;
  B, L, Lines, Crossing: Integer;
begin
  Options := TPdfStructuredTextOptions.Default;   // roPhysicalLayout
  Result := Pdf.GetStructuredText(Options);

  Lines := 0;
  Crossing := 0;
  for B := 0 to High(Result.Blocks) do
    for L := 0 to High(Result.Blocks[B].Lines) do
    begin
      Inc(Lines);
      if LineCrossesGutter(Result.Blocks[B].Lines[L], 18) then
        Inc(Crossing);
    end;

  // un quarto delle righe che attraversano un gap sembra colonne, non righe di form
  if (Lines > 0) and (Crossing * 4 >= Lines) then
  begin
    Options.ReadingOrder := roContentOrder;
    Result := Pdf.GetStructuredText(Options);
  end;
end;
Diciotto punti sono un quarto di pollice, comodamente più larghi di un word space nel testo corrente e più stretti della maggior parte delle colonne di mezzo. La soglia di uno su quattro tiene una fattura con qualche riga etichetta-importo sul layout fisico mentre un vero corpo a due colonne, dove attraversa quasi ogni riga, commuta. Se il producer ha scritto la pagina riga per riga attraverso entrambe le colonne, gli indici sorgente restano contigui, il test non scatta mai, e nessun dei due ordini ti separerà le colonne; quella pagina richiede la modalità a colonne dell'API dei contenuti leggibili, descritta in leggere due colonne con un titolo a cavalcamento
Cosa cambia IncludeSemantics, e cosa lascia stare?
IncludeSemantics etichetta i blocchi; non li riordina. Con l'opzione accesa, GetStructuredText legge i contenuti leggibili della pagina e dà a ogni blocco il tipo del frammento con cui si sovrappone per l'area maggiore. I tipi disponibili sono cfParagraph, cfHeading con un HeadingLevel, cfListItem, cfTableCell, cfCaption, cfFigure, cfLink, cfOther per qualunque altro tag, e cfPlain quando nulla ha combaciato. Ogni blocco raccoglie anche una Language e uno StructElementIndex che lo lega a un elemento dell'albero di struttura
Il campo Source dice da dove è arrivata l'etichetta: rosStructure quando la pagina ha un albero di struttura utilizzabile nel senso di ISO 32000-1 §14.7, rosHeuristic quando i tipi sono stati dedotti. Page.Source dà la stessa risposta per la pagina intera. Un titolo riportato con rosStructure è un titolo perché l'autore l'ha taggato; uno riportato con rosHeuristic è un'ipotesi istruita, e una pipeline di indicizzazione che pesa i titoli dovrebbe trattare i due diversamente. L'ordine dei blocchi, in entrambi i casi, arriva comunque da ReadingOrder. Il passaggio semantico usa i predefiniti dei contenuti leggibili, quindi un'impostazione di colonna applicata attraverso ReadableContentOptions non arriva a GetStructuredText
Le figure hanno una regola extra. Su una pagina con tag, un elemento Figure o un testo alternativo non abbinato ad alcun blocco di testo viene aggiunto come blocco a sé, che porta la descrizione alternativa come proprio testo. Un blocco del genere ha una sola riga e un solo span con SourceStartIndex a -1, perché nessun glyph sulla pagina l'ha prodotto. Il codice che rimappa gli span ai caratteri deve saltare quel valore, ed è per questo che il test della colonna di mezzo sopra lo controlla. I controlli dell'albero di struttura in sé sono trattati in validazione dell'albero di struttura PDF/UA
Span, bounds e la strada di ritorno ai caratteri
Ogni TPdfStructuredTextSpan porta il suo testo, i suoi bounds, FontName, FontSize, FontWeight e Angle, più SourceStartIndex e SourceCharacterCount. Con IncludeFontInfo acceso, uno span finisce ovunque cambi uno qualsiasi dei quattro valori di stile, così una frase con tre parole in grassetto in mezzo arriva come tre span e l'enfasi si può ricostruire da FontWeight invece che indovinarla dai nomi dei font. Con IncludeFontInfo spento, i campi di stile restano vuoti e gli span si spezzano solo dove la sequenza sorgente è interrotta
L'angolo conta sulle pagine con timbri. Una filigrana diagonale DRAFT vive nello stesso spazio di coordinate del testo del corpo, e nel layout fisico le sue lettere possono atterrare su righe del corpo che attraversano verticalmente. Gli span con Angle diverso da zero sono facili da scartare prima di unire il testo per l'indicizzazione
I due campi sorgente sono ciò che trasforma un risultato di ricerca in qualcosa che puoi disegnare. Indicizzano la sequenza di caratteri della pagina, quindi una frase trovata in un blocco si converte direttamente in box di caratteri per un'evidenziazione, con l'approccio di selezione visuale di righe di testo con character box. Quando l'obiettivo è la forma reflowed o HTML della pagina, gli stessi blocchi alimentano il modello di reflow e il suo export HTML
Un budget di caratteri e due contatori di qualità
MaxCharacters rifiuta una pagina in blocco quando contiene più caratteri del consentito. GetStructuredText controlla il conteggio prima di allocare qualsiasi array di lavoro, e una pagina sovradimensionata solleva EPdfError con il messaggio Structured text character budget exceeded; una pagina parziale non viene mai restituita. Il valore dev'essere positivo. Lo snapshot di caratteri per pagina che il metodo legge ha un suo tetto predefinito di 1.000.000 di caratteri e 100.000 oggetti testo, riportato come Text snapshot budget exceeded, quindi portare MaxCharacters sopra il milione non lascia passare una pagina più grande
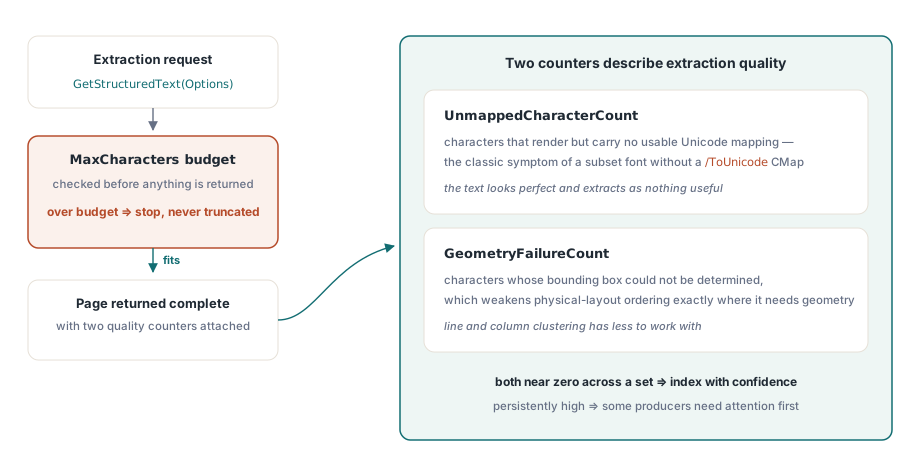
UnmappedCharacterCount conta i caratteri per cui PDFium non ha potuto produrre alcun valore Unicode. Quei caratteri compaiono come U+FFFD in ogni campo Text. La causa usuale è un font subset con codifica personalizzata e nessuna CMap /ToUnicode, il caso che ISO 32000-1 §9.10.2 descrive, dove il testo si renderizza correttamente e non si può estrarre in modo affidabile. Il contatore misura solo le mappature mancanti: un glyph la cui voce /ToUnicode nomina il code point sbagliato conta come mappato, quindi una pagina di spazzatura dall'aspetto plausibile può comunque riportare zero
GeometryFailureCount conta i caratteri senza un box utilizzabile, a capo esclusi. In ordine di contenuto quei caratteri semplicemente seguono i loro vicini. Nel layout fisico non hanno una posizione per cui ordinarsi, così vengono collocati dopo ogni carattere posizionato e finiscono attaccati all'ultima riga della pagina. Una pagina con conteggio di geometria diverso da zero e frammenti strani sulla sua ultima riga sta mostrando esattamente questo
// LogRejected e LogQuality sono le tue routine di logging
function ExtractForIndex(Pdf: TPdf; PageNumber: Integer;
  out Page: TPdfStructuredTextPage): Boolean;
var
  Options: TPdfStructuredTextOptions;
begin
  Result := False;
  Pdf.PageNumber := PageNumber;
  Options := TPdfStructuredTextOptions.Default;
  Options.MaxCharacters := 200000;              // limite di intake per questa pipeline
  try
    Page := Pdf.GetStructuredText(Options);
  except
    on E: EPdfError do
    begin
      LogRejected(PageNumber, E.Message);       // budget di caratteri o di snapshot
      Exit;
    end;
  end;

  if Page.UnmappedCharacterCount * 20 > Page.CharacterCount then
    LogQuality(PageNumber, Format('%d of %d characters have no Unicode value',
      [Page.UnmappedCharacterCount, Page.CharacterCount]));
  if (Options.ReadingOrder = roPhysicalLayout) and
     (Page.GeometryFailureCount > 0) then
    LogQuality(PageNumber, Format('%d characters without a box; check the last line',
      [Page.GeometryFailureCount]));
  Result := True;
end;
Per una pagina che ti serve solo come stringa, estrarre testo dai documenti PDF copre le chiamate più semplici, e leggere e scrivere il marked content BDC e MCID va un livello sotto l'albero di struttura. Il modello di pagina strutturata, il lettore dei contenuti leggibili e l'export di reflow viaggiano tutti nel componente Delphi e Lazarus descritto sulla pagina del prodotto PDFium Component