L'oggetto numero 1 non è la pagina 1. Questo unico fatto fa inciampare più codice di elaborazione PDF di qualsiasi altra parte del formato, e la ragione si vede solo quando smetti di guardare ciò che un viewer renderizza e inizi a guardare il grafo di oggetti che il viewer legge davvero
Un file PDF è una collezione di oggetti indiretti numerati. Ognuno porta un numero di oggetto e un numero di generazione, e gli altri oggetti lo puntano con un riferimento scritto come N G R — 3 0 R significa la versione corrente dell'oggetto 3. Le pagine sono oggetti come tutti gli altri, ma dove stanno nel file e quali numeri portano non dicono niente sull'ordine di visualizzazione. L'ordine viene dall'albero /Pages. Se scorri gli oggetti in ordine numerico assemblerai le pagine nella sequenza sbagliata per una buona fetta dei file reali
L'albero è anche il posto in cui vive parecchio comportamento meno ovvio. La sua forma decide quanto rapidamente un viewer può saltare alla pagina 8.214, i suoi nodi interni passano in silenzio dimensioni di pagina e font alle foglie sottostanti, e i totali /Count che rendono veloce tutta la struttura non sono garantiti da niente affatto. Vedremo tutte e tre le cose, partendo dall'ordine stesso
L'albero delle pagine decide l'ordine
Ogni PDF ha un catalog del documento (ISO 32000-2 §7.7.2), e la voce /Pages del catalog punta al nodo radice dell'albero delle pagine. Quella radice è un dizionario con /Type /Pages, un array /Kids di riferimenti indiretti, e un /Count che dà il numero di pagine foglia sottostanti. L'ordine di visualizzazione è una visita in profondità, da sinistra a destra, di quell'albero. Tutta la regola è questa
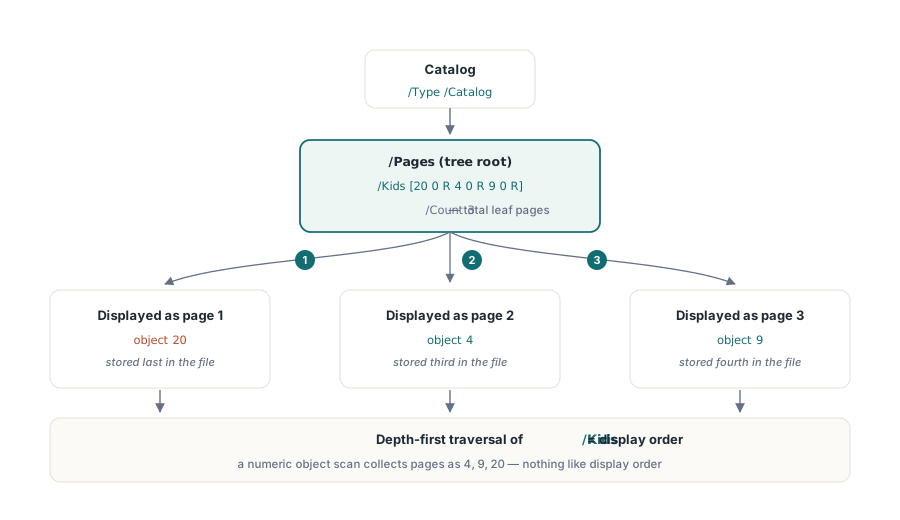
Un file minimo di tre pagine rende il discorso concreto:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% Oggetto 4: terzo nel file, ma pagina 2 per ordine di visualizzazione
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Oggetto 9: quarto nel file, ma pagina 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% Oggetto 20: ultimo nel file, ma pagina 1; decide Kids[0], non il numero di oggetto
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
L'array /Kids si legge [20 0 R 4 0 R 9 0 R], quindi l'oggetto 20 è la pagina 1, l'oggetto 4 è la pagina 2 e l'oggetto 9 è la pagina 3. Il codice che scorre gli oggetti in ordine numerico e raccoglie tutto ciò che ha /Type /Page sbaglia questo file. E la cosa peggiore è che l'output sembra comunque plausibile: numero di pagine giusto, contenuto riconoscibile su ogni pagina, sequenza sbagliata
I generatori producono disposizioni così per ragioni ordinarie. Una libreria che riserva in anticipo i numeri di oggetto per tutte le pagine li numera in ordine di creazione, poi scrive i byte nell'ordine che conviene al suo serializzatore. Uno strumento di merge rinumera gli oggetti di ogni documento sorgente per evitare collisioni, così gli oggetti pagina finiscono sparsi nella tabella oggetti combinata mentre il nuovo array /Kids radice contiene la sequenza corretta. E gli aggiornamenti incrementali accodano nuovi oggetti alla fine del file con numeri freschi, quindi una pagina aggiunta in una revisione sta vicino alla fine del flusso di byte anche se gli spetta la posizione 1
L'ultimo caso è quello che morde. Un corpus di test prodotto da un unico strumento può passare al completo, e poi i file arrivati da un flusso di merge, o i documenti passati per qualche revisione, escono rimescolati. Le correzioni euristiche non reggono, perché il guasto dipende dal generatore e dalla storia delle modifiche del file. La correzione vera è breve: parti dal catalog, risolvi /Pages, percorri /Kids ricorsivamente ed emetti le foglie nell'ordine in cui le incontri. Il nostro studio di caso sul debug dell'ordine delle pagine segue esattamente questo sintomo attraverso una diagnosi sbagliata fino alla causa radice, con il codice di attraversamento ricorsivo e i passi qpdf per controllare il risultato
Il fan-out è una decisione di prestazioni
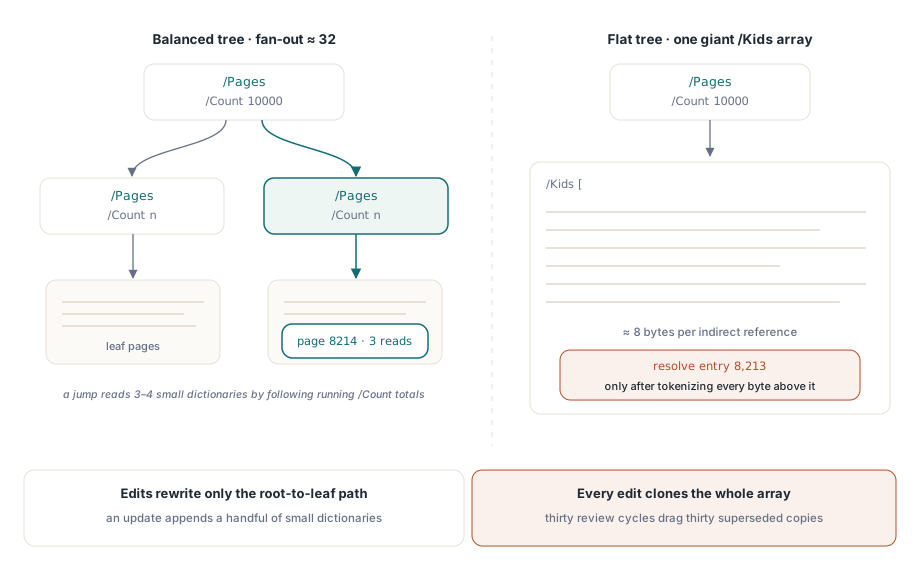
La specifica permette due forme. I generatori semplici emettono un albero piatto, un nodo radice /Pages il cui /Kids non contiene altro che foglie /Page. Nulla obbliga uno scrittore ad annidare, e un documento di 10.000 pagine con 10.000 riferimenti foglia in un singolo array è conforme. La PDF Reference raccomanda comunque un albero bilanciato per i documenti di grandi dimensioni, e i generatori più diffusi seguono questo consiglio con un fan-out modesto — tipicamente qualche decina di figli per nodo intermedio, dove ogni nodo intermedio ha il suo /Kids e il suo /Count
La ragione sta in ciò che un viewer deve leggere prima di poter mostrare qualcosa. Prendi un salto diretto alla pagina 8.214 di quel file da 10.000 pagine. Con un albero piatto il viewer deve prima analizzare la radice, e la radice è un unico array enorme: a circa otto byte per riferimento indiretto, un oggetto di 80 KB che va tokenizzato da capo a fondo prima che la voce 8.213 si risolva. Con un albero bilanciato di fan-out 32, lo stesso salto legge la radice, confronta i totali /Count parziali per scegliere il figlio giusto, e scende. Tre o quattro piccoli dizionari, poche centinaia di byte ciascuno. Quell'accesso casuale O(log n) è ciò per cui l'albero è stato progettato, ed è l'intera ragione per cui /Count esiste sui nodi intermedi — un lettore può saltare un intero sottoalbero senza aprire nemmeno un oggetto al suo interno
La forma dell'albero determina anche il costo della modifica. Un aggiornamento incrementale che inserisce una pagina deve riscrivere ogni nodo il cui /Kids o /Count è cambiato, cioè il percorso dal genitore della nuova foglia fino alla radice. In un albero bilanciato quel percorso è una manciata di piccoli dizionari accodati al file. In un albero piatto il "percorso" è la gigantesca array radice, duplicata per intero a ogni revisione. Un contratto che attraversa trenta cicli di revisione e annotazione può finire per trascinare trenta copie superate dello stesso array da 80 KB nel proprio flusso di byte
Per il codice di elaborazione, l'annidamento ha una conseguenza più diretta. Non puoi dare per scontato che il primo livello di /Kids contenga pagine, quindi ogni figlio va controllato: /Type /Pages significa ricorrere, /Type /Page significa foglia. Il codice che si ferma al primo livello funziona su ogni file piatto che incontra, e poi butta via silenziosamente interi sottoalberi la prima volta che un generatore decide di annidare
I nodi interni portano attributi ereditati
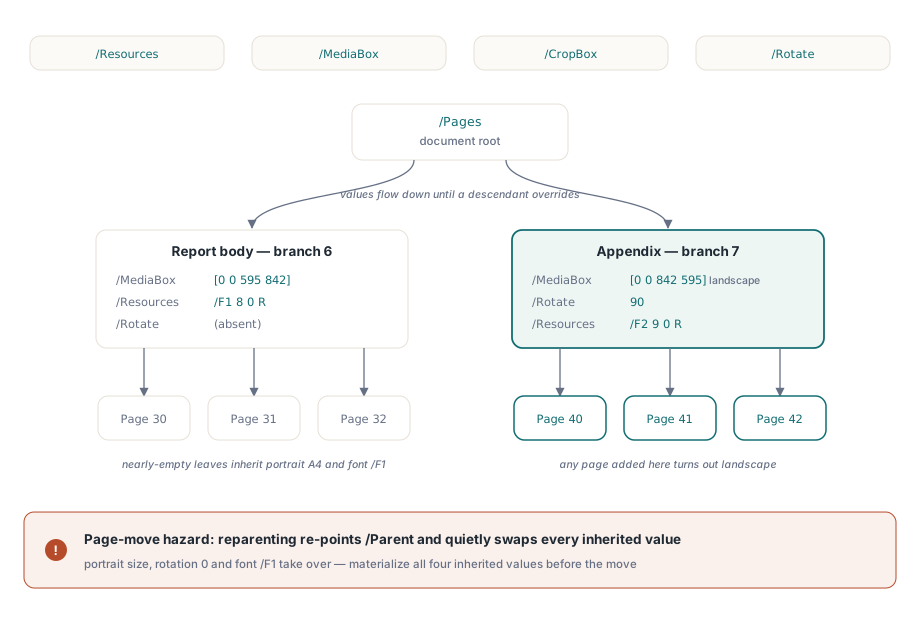
I nodi intermedi non servono solo a instradare le ricerche. Quattro attributi di pagina sono ereditabili (ISO 32000-2 §7.7.3.4): /Resources, /MediaBox, /CropBox e /Rotate. Ognuno può stare su un nodo /Pages, dove si applica a ogni foglia sottostante a meno che un discendente non lo sovrascriva. Uno scrittore che produce un rapporto con un'appendice orizzontale può esprimere quella disposizione nell'albero stesso:
5 0 obj   % radice del documento
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % corpo del rapporto: A4 verticale, font del corpo
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % appendice: A4 orizzontale, ruotata, font proprio
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % pagina dell'appendice: eredita dimensione, rotazione, font
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
Gli oggetti da 40 a 42 sono quasi vuoti. Dimensione di pagina, rotazione e risorse dei font arrivano tutte dal nodo 7, il che mantiene il file compatto e in grado di mantenersi da solo: aggiungi una quarta pagina sotto il nodo dell'appendice ed esce orizzontale senza che nessuno la tocchi
Significa anche che le proprietà di una pagina non stanno tutte sulla pagina. L'oggetto 40 non ha nessuna chiave /MediaBox, ed è perfettamente legale — un lettore che tratta la chiave mancante come input malformato rifiuterà file validi. La ricerca deve risalire la catena /Parent finché trova la voce o raggiunge la radice. Quella risalita richiede una guardia contro i cicli. Un file corrotto può portare un riferimento /Parent che punta indietro a un nodo già visitato, e senza un insieme di oggetti visitati la ricerca gira per sempre
Lo stesso meccanismo crea il classico rischio dello spostamento di pagina. Diciamo che uno strumento sposta l'oggetto 40 nel corpo del rapporto modificando i due array /Kids e ripuntando /Parent al nodo 6. Lo spostamento è strutturalmente valido, eppure l'oggetto 40 ora eredita il /MediaBox verticale, nessuna rotazione e il font /F1 — mentre il suo content stream continua a selezionare /F2, che non si risolve più. La pagina si restringe, si drizza e perde il proprio testo in un'unica modifica. Il codice di riordino che tiene scrive i valori risolti di tutti e quattro gli attributi ereditabili sul dizionario della pagina prima di riassegnarle il genitore. Se avete mai trascinato una pagina in un editor e l'avete vista cambiare dimensione o orientamento, questo è il meccanismo che avete visto
Flattening: legale, comune, a volte costoso
Tanti strumenti vanno nella direzione opposta. Gli scrittori minimali emettono un albero a un livello perché è semplice, e molte utility di merge e split ricostruiscono qualunque albero leggano in un unico array /Kids piatto, perché l'output bilanciato è lavoro extra e quello piatto è sempre conforme. Una ricostruzione corretta deve risolvere l'ereditarietà allo stesso tempo. Ogni attributo che una foglia stava ereditando va copiato sulla foglia, oppure issato sulla nuova radice se è uniforme in tutto il documento; salta quel passo e l'output cambia geometria esattamente come nel caso dello spostamento di pagina
Per i documenti tipici l'appiattimento è innocuo. Fa male su larga scala, nei due modi già descritti: l'array radice diventa un unico grande oggetto che ogni apertura e ogni salto di pagina analizza per intero, e ogni modifica strutturale lo riscrive completamente. Ciò che l'appiattimento non distrugge è la condivisione tramite riferimenti indiretti. Un albero piatto in cui tutte le 10.000 pagine puntano allo stesso oggetto dizionario /Resources resta comunque deduplicato — l'unica cosa perduta è l'opzione di omettere la voce dalla pagina e lasciare che la fornisca un antenato
Quando /Count mente
Il /Count è pura contabilità. Deve essere uguale al numero di pagine foglia nel sottoalbero del nodo, e nulla nel formato file lo impone. Due schemi di corruzione spiegano la maggior parte dei conteggi mendaci visti sul campo
Il primo è il conteggio stantio lasciato da un aggiornamento incrementale. Un editor inserisce una pagina, riscrive il genitore immediato con un nuovo /Kids e un /Count aggiornato, accoda entrambi al file — e non tocca mai gli antenati:
% Revisione originale
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Revisione aggiunta: una pagina inserita nel ramo centrale.
% Oggetto 14 sostituito; oggetto 12 mai riscritto
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
L'albero ora contiene dieci foglie, ma la radice dice ancora nove. Un viewer che si fida della radice mostra nove nel suo contatore di pagine. Uno che usa i conteggi interni per cercare a salti una pagina calcola l'indice sbagliato per ogni pagina dopo il punto di inserimento. Una visita completa ne trova dieci. Tre risposte diverse, un solo file
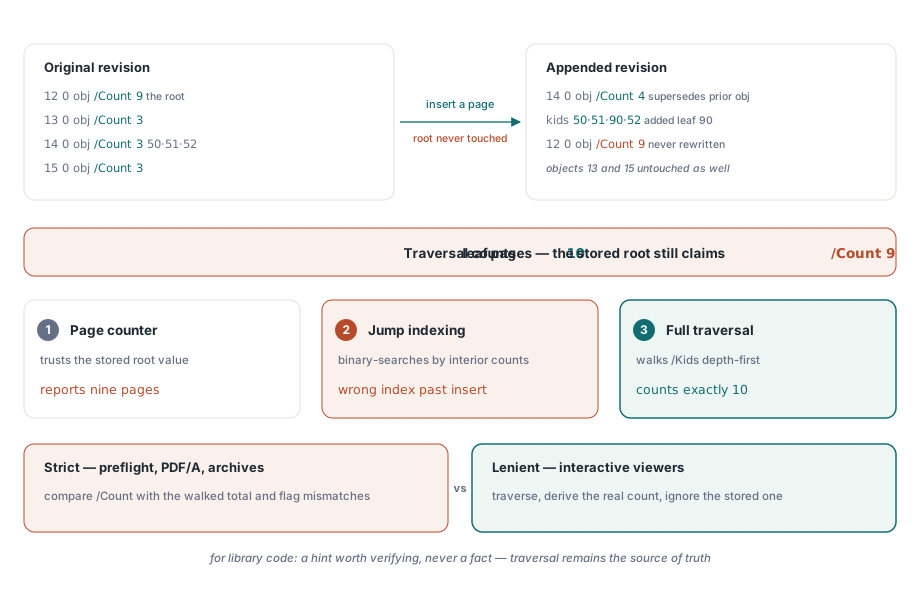
C'è un modo più silenzioso per farsi mordere dallo stesso file. Codice che legge il conteggio della radice, inizia a percorrere l'albero, e si ferma appena ha raccolto quel numero di pagine non vedrà mai la pagina dieci. Nessuna eccezione, nessun avviso, solo un documento corto di una pagina. Usare /Count come limite di ciclo o come controllo sui limiti è l'errore; la visita deve girare finché l'albero non si esaurisce, qualunque cosa dica il numero memorizzato
Il secondo schema è il conteggio che non potrebbe mai essere giusto: negativo, zero su un nodo popolato, o assurdamente enorme. Vengono dal fuzzing, dai danni di trasmissione, e ogni tanto da bug aritmetici negli editor. Sono pericolosi specificamente per il codice che si fida del /Count per l'allocazione. Dimensionare un array da un /Count di -3 solleva nel migliore dei casi un errore di intervallo, e farlo da un /Count di due miliardi è un'allocazione da denial-of-service. Tratta il valore come input non affidabile, come ogni altro numero nel file
I parser si dividono in due schieramenti su tutto questo. I consumatori rigorosi — strumenti di preflight, validatori PDF/A, pipeline di archiviazione — confrontano il /Count con il risultato della visita e rifiutano o segnalano il file. I viewer interattivi sono quasi tutti permissivi: attraversano l'albero, ricavano il conteggio reale e ignorano in silenzio quello memorizzato, ed è esattamente per questo che un file con conteggio stantio può circolare per anni senza lamentele finché non incontra un parser più rigoroso dentro qualche flusso di lavoro automatizzato. Per il codice di libreria riteniamo che la via di mezzo sia il default giusto. Usa /Count come suggerimento per la preallocazione, e per saltare i sottoalberi una volta verificato, e lascia che la visita resti la fonte di verità
In produzione questi guasti raramente si annunciano come problemi dell'albero. Si presentano come pagine rimescolate, una pagina mancante alla fine di un merge, o una pagina che cambia dimensione o orientamento dopo un riordino. Lo studio di caso di debug ripercorre una di queste segnalazioni risalendo l'albero. Per l'anatomia del file che li circonda (oggetti, dati di cross-reference, trailer) la panoramica della struttura dei file PDF è il punto di partenza
L'HotPDF Delphi Component gestisce tutto questo internamente: attraversa alberi annidati di qualsiasi profondità, risolve gli attributi ereditati quando le pagine vengono copiate o spostate, e verifica il /Count contro il numero reale delle foglie invece di fidarsene, così gli indici di pagina nella sua API significano sempre pagine logiche