L'oggetto numero 1 non è la pagina 1. Questo singolo fatto mette in difficoltà il codice di elaborazione PDF più di qualsiasi altro aspetto del formato, e capirne il motivo richiede di guardare oltre ciò che mostra un visualizzatore, esplorando il grafo degli oggetti che il visualizzatore legge effettivamente
Un file PDF è una raccolta di oggetti indiretti numerati. Ogni oggetto porta un numero di oggetto e un numero di generazione, e gli altri oggetti lo referenziano con un riferimento scritto come N G R: 3 0 R indica la versione corrente dell'oggetto 3. Le pagine fanno parte di questi oggetti, ma la loro sequenza di visualizzazione non ha nulla a che fare con la loro posizione nel file o con i numeri che portano. L'ordine di visualizzazione è determinato interamente dall'albero /Pages, una struttura collegata che ha come radice il catalogo del documento. Se si ignora l'albero e si esaminano gli oggetti numericamente, si assembleranno le pagine nell'ordine errato per una frazione significativa di file reali
L'albero delle pagine: cosa determina effettivamente l'ordine
Ogni PDF inizia con un catalogo del documento (ISO 32000-2 §7.7.2). Il catalogo contiene una voce /Pages che punta al nodo radice dell'albero delle pagine. Tale nodo radice è un dizionario con /Type /Pages, un array /Kids di riferimenti indiretti e un /Count che fornisce il numero totale di pagine foglia sottostanti. L'ordine di visualizzazione è l'attraversamento depth-first (in profondità) da sinistra a destra di quell'albero, senza eccezioni
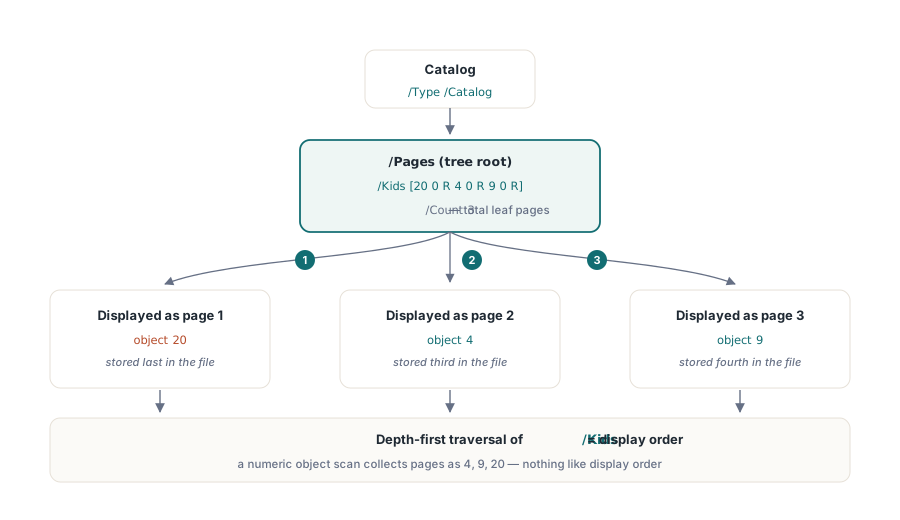
Un file minimo di tre pagine rende questo concetto concreto:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% L'oggetto 4 è il terzo nel file ma è la pagina 2 nell'ordine di visualizzazione
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% L'oggetto 9 è il quarto nel file ma è la pagina 3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% L'oggetto 20 è l'ultimo nel file ma è la pagina 1; decide Kids[0], non il numero d'oggetto
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
L'array /Kids contiene [20 0 R 4 0 R 9 0 R], quindi l'oggetto 20 è la pagina 1, l'oggetto 4 è la pagina 2 e l'oggetto 9 è la pagina 3. La numerazione degli oggetti è irrilevante. Qualsiasi codice che iteri gli oggetti in ordine numerico e raccolga quelli con /Type /Page produrrà una sequenza errata su questo file
Perché i generatori producono layout non sequenziali? Per diverse ragioni. Una libreria che pre-alloca i numeri degli oggetti per tutte le pagine prima di scriverne il contenuto le numererà in ordine di creazione, per poi scrivere i byte effettivi nell'ordine più adatto al serializzatore. Uno strumento di unione che unisce documenti diversi rinumera gli oggetti di ciascun documento di origine per evitare collisioni; gli oggetti pagina rinumerati finiscono per essere sparsi nella tabella degli oggetti combinata, mentre il nuovo array radice /Kids mantiene la corretta sequenza di visualizzazione. Gli aggiornamenti incrementali aggiungono nuovi oggetti alla fine del file con nuovi numeri, quindi una pagina aggiunta come revisione si trova vicino alla fine del flusso di byte anche se appartiene alla posizione 1 dell'ordine di visualizzazione
Alberi piatti e sottoalberi nidificati
La specifica consente due forme per l'albero delle pagine. I generatori semplici producono una struttura piatta: un singolo nodo radice /Pages il cui array /Kids contiene solo oggetti foglia /Page. Questo è facile da attraversare: profondo un solo livello, un unico passaggio
I documenti di grandi dimensioni utilizzano invece abitualmente un albero bilanciato. L'array /Kids del nodo radice /Pages contiene nodi intermedi /Pages, ognuno dei quali contiene a sua volta un proprio array /Kids. Il valore /Count su ciascun nodo intermedio indica il numero totale di pagine foglia nel suo sottoalbero, in modo che un visualizzatore possa saltare interi sottoalberi quando passa a una pagina tramite indice, senza dover analizzare ogni singolo oggetto. Un documento di 1.000 pagine strutturato come un albero bilanciato con 10 pagine per nodo foglia può individuare la pagina 750 tramite ricerca binaria attraverso tre o quattro ricerche di dizionari, anziché scorrere 750 voci /Kids
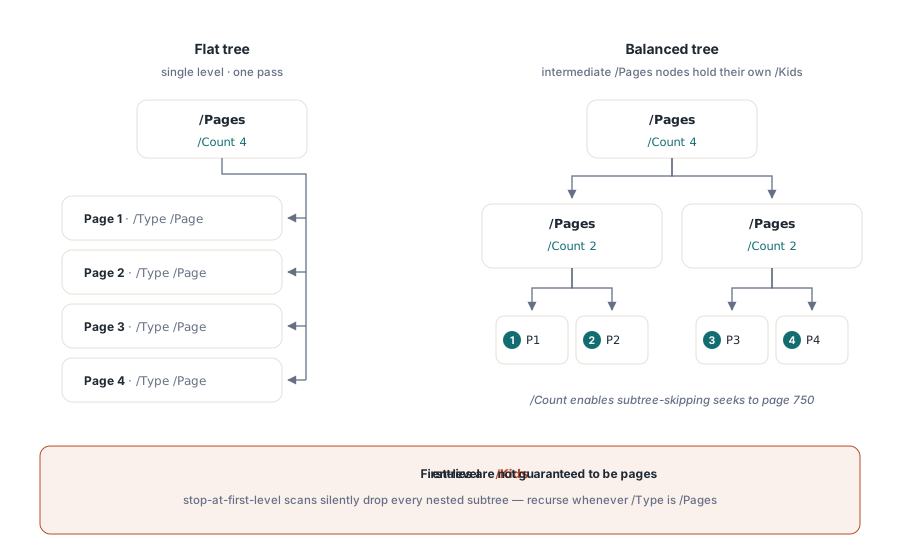
La conseguenza per il codice di elaborazione: non si può presumere che il primo livello di /Kids contenga oggetti /Page. Ciascun figlio deve essere controllato. Se il suo /Type è /Pages, occorre procedere ricorsivamente al suo interno. Se il suo /Type è /Page, si tratta di una foglia. Fermarsi al primo livello esclude silenziosamente interi sottoalberi in qualsiasi documento in cui il generatore abbia scelto di nidificare la struttura. Perché i writer scelgano alberi profondi, a cosa rinunciano gli strumenti di flattening e come si manifesta in pratica la corruzione di /Count è trattato nell'articolo di accompagnamento su struttura dell'albero di pagine PDF, fan-out e integrità del /Count
Attributi di pagina ereditati
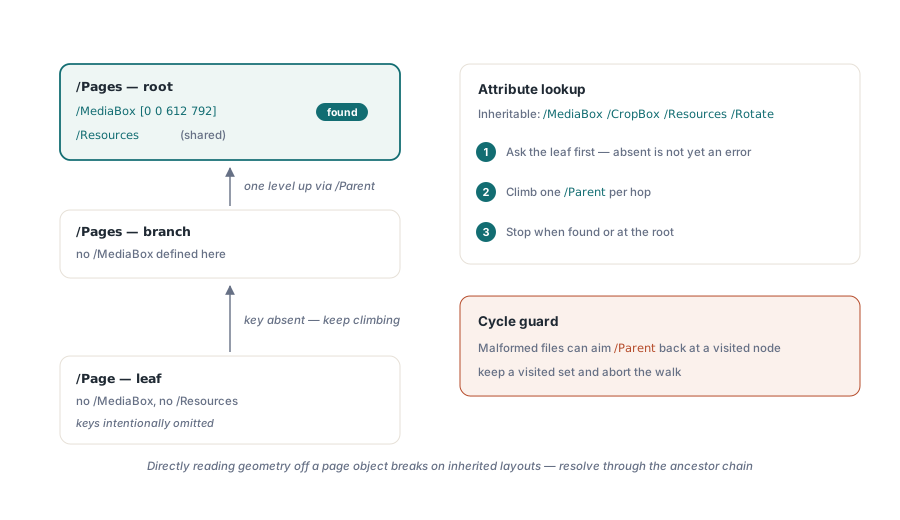
L'albero delle pagine supporta anche un meccanismo di condivisione delle risorse. Alcuni attributi di pagina come /MediaBox, /CropBox, /Resources e /Rotate sono ereditabili (ISO 32000-2 §7.7.3.4). Se un dizionario /Page ne omette uno, il lettore risale la catena di /Parent finché non trova l'attributo o raggiunge la radice. Posizionare un dizionario di font condiviso nel nodo radice /Pages anziché copiarlo in ogni pagina foglia può ridurre notevolmente le dimensioni del file per i documenti che utilizzano gli stessi caratteri in tutto il testo
La regola dell'ereditarietà introduce una sottigliezza per il codice che legge le proprietà delle pagine. Leggere /MediaBox direttamente da un oggetto /Page e trattare una chiave mancante come un errore è errato; la chiave potrebbe semplicemente essere ereditata. Il codice che risolve correttamente la geometria della pagina deve seguire la catena dei genitori. Necessita inoltre di una protezione contro i cicli: un file corrotto può avere un riferimento /Parent che punta a un nodo già visitato, il che provocherebbe un ciclo infinito senza un controllo sugli oggetti visitati
La tabella xref e i flussi di riferimento incrociato
La ricerca degli oggetti indiretti passa attraverso la tabella dei riferimenti incrociati (o il suo successore, il flusso di riferimenti incrociati introdotto in PDF 1.5). La tabella xref mappa ogni numero di oggetto a un offset di byte all'interno del file. Un lettore conforme utilizza la tabella xref per saltare direttamente a qualsiasi oggetto, senza scansionare il file in modo sequenziale. Questo design ad accesso casuale consente il salto rapido da una pagina all'altra: il visualizzatore legge il catalogo, risolve il riferimento /Pages tramite la tabella xref, legge il nodo radice /Pages, risolve una voce /Kids e così via, toccando solo gli oggetti necessari
Gli aggiornamenti incrementali aggiungono nuovi oggetti alla fine del file con un trailer che si collega a quello precedente. Un oggetto aggiornato in una revisione ottiene una nuova voce nella sezione xref aggiunta; i byte originali rimangono al loro posto ma vengono sostituuiti. In questo modo i PDF con firma digitale rimangono verificabili even dopo l'aggiunta di annotazioni o revisioni di compilazione moduli: l'intervallo di byte firmato non viene mai modificato e il nuovo contenuto risiede nella sezione aggiunta. Anche l'albero delle pagine può essere aggiornato, per cui le aggiunte o le eliminazioni di pagine in una revisione producono una nuova radice /Pages con un array /Kids modificato, mentre il vecchio oggetto radice occupa ancora la sua posizione originale nel file
Cosa va storto senza l'attraversamento dell'albero
La modalità di guasto per gli approcci basati sulla scansione degli oggetti è silenziosa. Il documento di output sembra plausibile: ha il numero corretto di pagine e ognuna di esse contiene contenuti riconoscibili. L'ordine è semplicemente errato, e lo è in un modo che dipende dal generatore, dal numero di revisioni e dall'eventuale unione di pagine provenienti da fonti esterne. Un corpus di test composto da file prodotti da un unico strumento può superare i test completamente; i file provenienti da uno strumento diverso o da un flusso di lavoro di unione falliranno. Questa incoerenza è il motivo per cui le soluzioni euristiche non funzionano mai a lungo. Per una ricostruzione di questo esatto guasto su un documento reale di un cliente — sintomo, diagnosi errata e correzione basata sull'attraversamento — vedi il nostro studio di caso sul debug dell'ordine delle pagine
I file con aggiornamenti incrementali sono particolarmente inclini a questo problema perché le pagine aggiunte o riordinate nelle revisioni successive portano numeri di oggetto elevati, mentre l'ordine di visualizzazione è controllato dall'array /Kids aggiornato. Una scansione che elabora gli oggetti in ordine numerico posizionerà le pagine con numero finale in coda, indipendentemente da dove l'albero indica che debbano trovarsi
La soluzione non è complicata. Si parte dal catalogo, si risolve il riferimento /Pages, si percorre l'array /Kids in modo ricorsivo e si restituiscono le foglie nell'ordine in cui si incontrano. Questo è l'ordine di visualizzazione per definizione, indipendentemente dai numeri degli oggetti, dagli offset di byte o dalla struttura del file. La maggior parte delle librerie PDF mature espone un conteggio delle pagine e un lettore di pagine indicizzato che eseguono già questa operazione correttamente; il rischio risiede nel codice che bypassa il modello di pagina della libreria e interagisce direttamente con il livello degli oggetti
Un'anomalia strutturale che vale la pena gestire esplicitamente: il valore /Count su un nodo intermedio /Pages può essere errato in file malformati. Affidarsi a /Count per il controllo dei limiti per poi interrompere l'attraversamento completo ometterà silenziosamente le pagine quando il conteggio è sottostimato. Usare /Count solo come indicazione prestazionale per la pre-allocazione della capacità o la ricerca binaria, ricavando il conteggio effettivo dall'attraversamento, rappresenta il pattern più sicuro per i documenti importanti