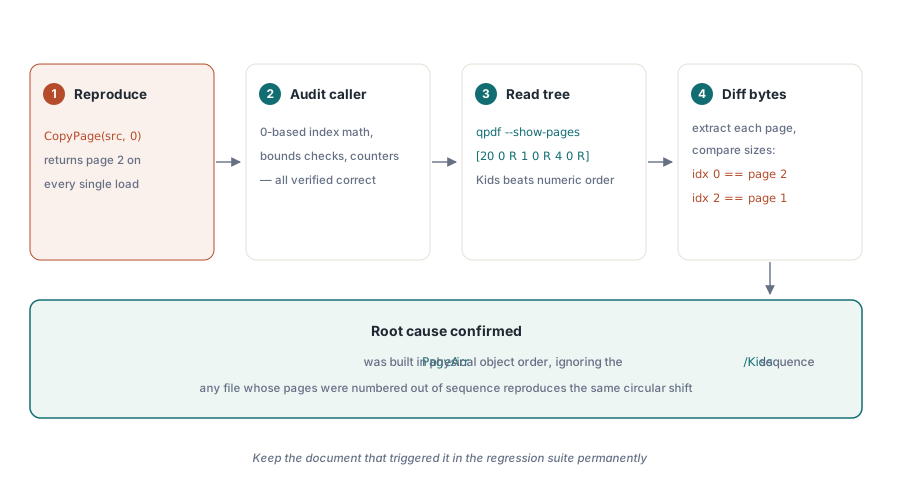
Il sintomo classico sembra un off-by-one: una routine di copia pagine chiede la pagina 1 di un documento di tre pagine e riceve costantemente la pagina 2. La logica di indicizzazione torna: la chiamata usa un indice logico a base 0, l'aritmetica è corretta, le condizioni al bordo sono a posto. E invece la pagina sbagliata esce ogni volta
La causa non sta affatto nel codice di copia. Sta in come il loader costruisce il suo array di pagine, ed è una delle trappole più facili del parsing dei PDF
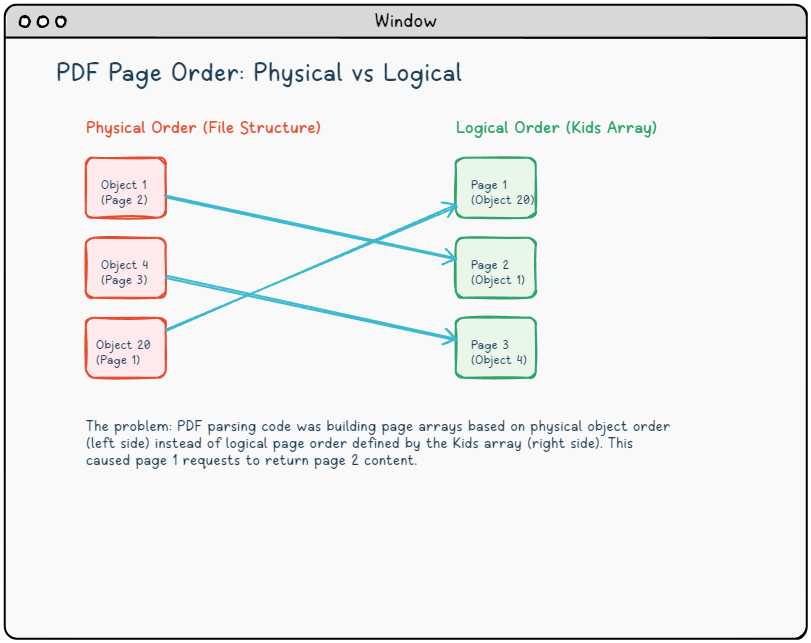
Due ordinamenti, una fonte di confusione
Un file PDF è una raccolta di oggetti indiretti, ciascuno identificato da un numero di oggetto. La struttura del file non impone alcun obbligo a quei numeri di riflettere l'ordine di lettura. L'oggetto 1 può contenere la pagina 2; l'oggetto 20 può contenere la pagina 1. Ciò che definisce effettivamente l'ordine di lettura è l'albero delle pagine: una gerarchia di dizionari /Pages i cui array /Kids elencano i riferimenti di pagina nella sequenza in cui un visualizzatore dovrebbe visualizzarli (ISO 32000-1 §7.7.3)
Ecco un albero delle pagine che espone la trappola:
{ Radice dell'albero Pages, oggetto 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { pagina logica 1 }
         1 0 R    { pagina logica 2 }
         4 0 R]   { pagina logica 3 }
>>
endobj
Nel file è capitato di elencare l'oggetto 1 e l'oggetto 4 prima dell'oggetto 20 nel flusso di byte (byte stream). Qualsiasi parser che avesse iterato attraverso gli oggetti indiretti nell'ordine del file e li avesse stampigliati in un PageArr man mano che trovava i dizionari di tipo pagina, si sarebbe ritrovato con l'oggetto 1 all'indice 0, l'oggetto 4 all'indice 1 e l'oggetto 20 all'indice 2. La pagina logica 1 si trova in PageArr[2]. Chiedere l'indice della pagina 0 recupera invece la pagina logica 2
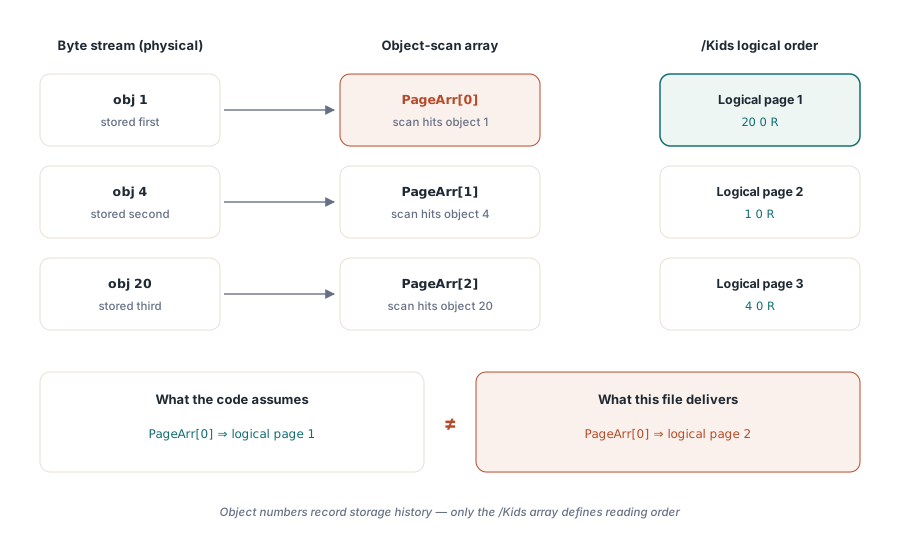
Confermare l'ipotesi
Prima di cambiare codice, dimostra la discrepanza invece di darla per scontata. Lo strumento a riga di comando qpdf rende la cosa immediata:
{ shell }
qpdf --show-pages input.pdf
{ L'output rivela l'ordine dei Kids: 20 0 R, poi 1 0 R, poi 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Mostra il dizionario Pages con i /Kids in ordine di lettura }
Estrarre ogni pagina singolarmente e confrontare le dimensioni dei file conferma la mappatura: quello che una scansione per oggetti chiama PageArr[0] produce il contenuto della pagina logica 2, e PageArr[2] contiene la pagina logica 1. La rotazione circolare è la prova definitiva. Spiega anche perché il sintomo compare su tanti documenti sorgente diversi: qualsiasi PDF in cui gli oggetti pagina hanno per caso numeri di oggetto più bassi di una pagina logica precedente lo innesca
C'è un motivo diretto per cui i PDF finiscono in questo stato. Un aggiornamento incrementale conserva i numeri degli oggetti che modifica, ma tutto ciò che aggiunge, una copertina inserita in testa per esempio, riceve un numero nuovo sopra quelli già presenti nel file, mentre il suo riferimento va in cima all'array Kids. I tool che uniscono o riorganizzano documenti rinumerano gli oggetti nell'ordine che gli torna comodo. Alcuni generatori scrivono semplicemente le pagine in un ordine comodo per lo streaming dei contenuti piuttosto che per la sequenza logica. Il formato PDF non richiede a nessuno di fare diversamente
L'approccio corretto: seguire l'array Kids
Costruisci la lista delle pagine percorrendo la catena /Kids dalla radice del catalogo, non scannerizzando gli oggetti indiretti. La scansione deve essere ricorsiva, perché un documento grande di norma sparge le sue pagine su nodi /Pages intermedi, e deve guardarsi da un albero malformato che punta a uno dei suoi stessi antenati. Nello schema qui sotto TPdfDict e TPdfArray rappresentano i tipi dizionario e array che usa il tuo parser:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // un ciclo o un albero patologicamente profondo
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // segui il riferimento indiretto
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // nodo intermedio
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // foglia: prossima pagina in ordine di visualizzazione
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// Uso: parti dalla voce /Pages del catalogo
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
Due dettagli sono voluti. Una foglia senza voce /Type viene comunque trattata come pagina, perché alcuni writer la omettono e i viewer aprono comunque quei file. E il confronto finale con /Count non costa nulla ma becca gli alberi troncati o modificati a mano prima che un chiamante ci indicizzi dentro
Se carichi documenti con HotPDF, questo ordine è già risolto al caricamento: gli indici di pagina seguono l'ordine di visualizzazione dell'albero pagine, nodi /Pages annidati compresi, quindi l'indice 0 è sempre la prima pagina che un viewer mostra. La scansione qui sopra conta quando è il tuo codice a fare il parsing diretto della struttura PDF
Copiare per indice logico con CopyPageFromDocument
Siccome HotPDF risolve l'ordine delle pagine al caricamento, gli indici logici significano ciò che i chiamanti si aspettano. Il CopyPageFromDocument di livello più alto prende un indice logico a base 0 e copia la pagina corretta nel documento di destinazione:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Copia la pagina logica 0 (la prima pagina che l'utente vede) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
Siccome l'indice è un indice in ordine di visualizzazione, CopyPageFromDocument si comporta correttamente anche contro documenti in cui ordine fisico e logico divergono. Per le operazioni batch, InsertPagesFromDocument accetta un array di indici logici e li copia in una passata
Cosa ci rivela tutto questo sull'analisi dei PDF
La specifica PDF è esplicita: l'ordine logico delle pagine è definito dall'array /Kids dell'albero pagine, non dai numeri di oggetto né dagli offset di byte (ISO 32000-1 §7.7.3.2). Qualsiasi parser che usi un ordinamento diverso come scorciatoia produrrà risultati corretti sulla maggioranza dei documenti che vede, perché la maggior parte dei generatori scrive le pagine in ordine naturale e assegna numeri di oggetto sequenziali. L'errore si nasconde finché qualcuno non carica un PDF modificato per via incrementale, riorganizzato da un altro tool o generato da software che ha scelto un layout diverso
Testare solo contro PDF auto-generati perde completamente questa classe di problemi. La gestione dell'ordine delle pagine ha bisogno di un corpus di test di documenti provenienti da fonti varie: salvataggi incrementali, documenti scannerizzati con copertine inserite, PDF prodotti da tool che linearizzano o ottimizzano il grafo degli oggetti in modo diverso. Qualsiasi documento in cui ordine fisico e logico divergono merita un posto permanente in quel corpus
La pagina di HotPDF Delphi Component illustra l'API completa per le operazioni sulle pagine, tra cui CopyPageFromDocument, InsertPagesFromDocument e MovePage