Due thread condividono uno TFileStream su un pacchetto .xlsx. Il thread A imposta Position sul primo byte compresso di sheet1.xml, il thread B lo imposta sul primo byte di sheet2.xml un momento dopo, e la Read di A restituisce un buffer che appartiene all'altro membro. L'inflater di A sta ora decodificando il mezzo dello stream deflate di qualcun altro; zlib di solito si ferma con Z_DATA_ERROR dopo qualche blocco, e se per caso produce output, il CRC32 del membro non combacierà. Deflate non è il problema qui. La race vive interamente nel cursore di posizione dello stream, e un lock attorno alla coppia seek-e-lettura basta per far inflate a molti worker i membri dello stesso pacchetto insieme
La ragione per cui qualcuno lo vuole è la memoria. Supponete una cartella di lavoro da 80 MB su disco il cui XML dei fogli si espande di cinque-dieci volte quando viene inflato. Un percorso di apertura che estrae ogni foglio in un buffer prima di analizzarlo paga quei byte inflati sopra la cartella di lavoro che sta costruendo, e il picco arriva prima che esista una singola cella. Questo articolo copre la concorrenza a livello di pacchetto che elimina il passaggio di estrazione. Il tetto dell'allocatore che sta sopra è trattato in l'articolo sul parsing XLSX parallelo e il memory manager, e l'API read-once che non costruisce affatto una cartella di lavoro è nella procedura del streaming direct reader
Il design a stadi, e cosa tiene in memoria
Il modo cauto di parallelizzare un'apertura XLSX è una pipeline a tre fasi in cui solo la fase centrale gira sui worker. La fase A percorre la lista dei fogli sul thread chiamante, crea ogni foglio di lavoro, legge la sua relationship part, e copia l'intero XML del foglio inflato in uno TMemoryStream privato. La fase B distribuisce il parsing XML su un thread pool. La fase C torna all'archivio, ancora sul thread chiamante, per le piccole parti satellite: commenti, commenti in thread, disegni, grafici e tabelle
La tesi a favore di quella forma sembra inattaccabile. Un archivio ZIP e il suo stato di inflate non sono thread-safe, quindi tenete ogni tocco all'archivio su un thread e saltate del tutto i lock. Il conto è una cartella di lavoro con otto fogli impegnati che tiene otto buffer di fogli completamente inflati nello stesso momento, e quei buffer sono i più grandi oggetti transitori dell'intero percorso di apertura. Con il pacchetto da 80 MB assunto sopra, sono diverse centinaia di megabyte di testo XML che esistono solo perché un parser possa leggerli una volta
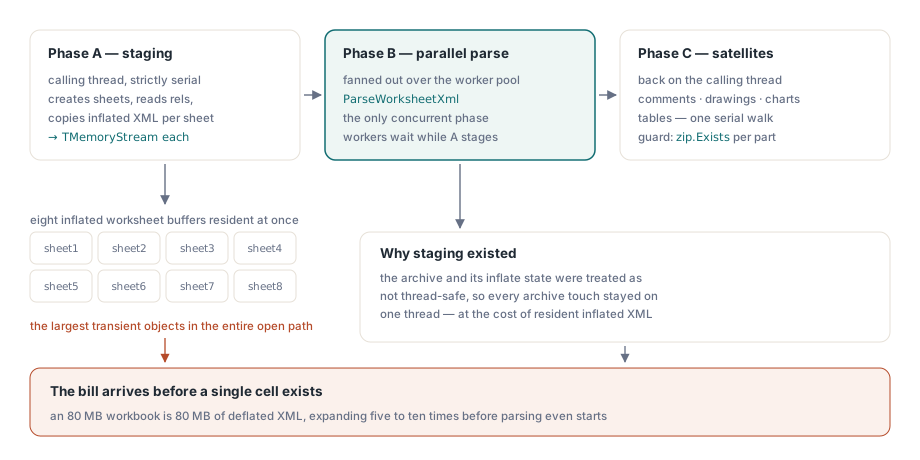
HotXLS conserva le fasi A e C ma elimina la copia. Ogni worker della fase B apre il proprio entry stream sul pacchetto condiviso e lo passa dritto al lettore XML, così il foglio inflato non esiste mai come blocco unico. Funziona solo perché l'argomento del "non thread-safe" si scopre parlare di due cose diverse
Due thread possono fare inflate da uno stream ZIP?
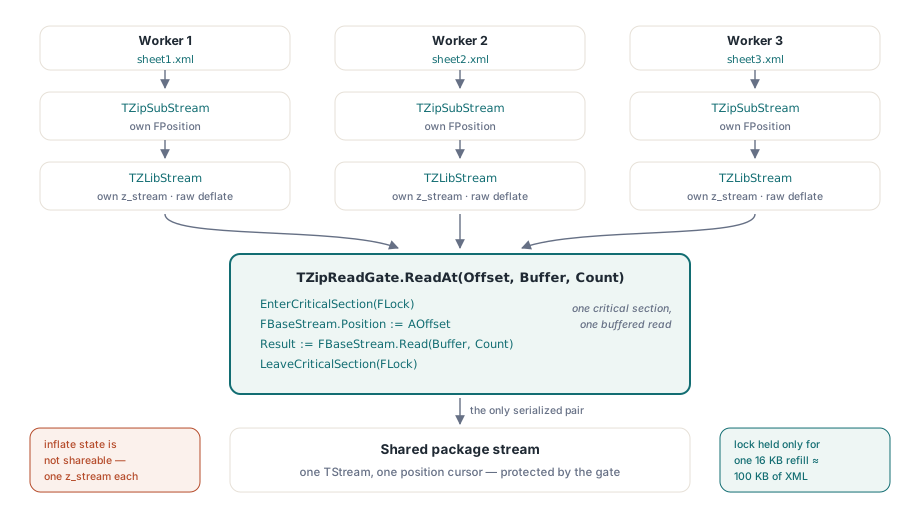
Sì, purché ogni thread possieda il proprio inflater e la sorgente di byte condivisa sia serializzata alla lettura. L'argomento cauto piega due tipi di stato in una frase sola. Lo stato di inflate davvero non si può condividere: uno z_stream zlib porta la finestra scorrevole da 32 KB che l'RFC 1951 definisce, le tabelle Huffman correnti e la posizione in bit dentro un solo membro compresso, e due thread che spingono byte attraverso lo stesso producono spazzatura. La sorgente di byte è un'altra cosa. Uno stream di file ha esattamente un pezzo di stato mutabile da proteggere, la sua posizione
Il contenitore ZIP rende legale la spaccatura. L'APPNOTE di PKWARE (sezione 4.3) dispone un pacchetto come membri indipendenti, ciascuno con il proprio local file header, i propri dati compressi al proprio offset, e il proprio CRC32 e le proprie dimensioni registrate nel central directory. Nessun dizionario attraversa i membri come fa un blocco solid 7z, così la voce N si può inflare senza leggere un byte della voce M. Date a ogni worker un inflater privato sul proprio intervallo di byte e l'unica collisione rimasta è la seek. In HotXLS quella collisione è gestita da TZipReadGate in lxZipArchive.pas, e l'intera classe sta in uno schermo
type
  TZipReadGate = class
  private
    FBaseStream: TStream;
    FLock: TXLSCriticalSection;   // wrapper lxPlatform su una sezione critica
  public
    constructor Create(ABaseStream: TStream);
    destructor Destroy; override;
    function ReadAt(AOffset: Int64; var Buffer; Count: Longint): Longint;
  end;

function TZipReadGate.ReadAt(AOffset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  if Count <= 0 then
  begin
    Result := 0;
    Exit;
  end;
  XLSEnterCriticalSection(FLock);
  try
    FBaseStream.Position := AOffset;
    Result := FBaseStream.Read(Buffer, Count);
  finally
    XLSLeaveCriticalSection(FLock);
  end;
end;
Cosa blocca il read gate, e cosa resta fuori
TZipReadGate.ReadAt protegge una sola operazione indivisibile, posizionare lo stream condiviso e leggere da esso. TZipArchive.OpenArchive costruisce il gate una volta che il central directory è stato analizzato, sia per l'overload con nome file sia per quello con TStream, e liberare l'archivio lo rilascia. Gli archivi creati per la scrittura non ne prendono mai uno, perché nessuno li legge in concorrenza
Tutto il resto sta fuori dal lock perché già privato o già congelato. Ogni entry stream che TZipArchive.OpenFile restituisce tiene la propria posizione dentro il proprio membro e la converte in un offset assoluto del pacchetto solo al momento in cui chiama ReadAt. L'inflater avvolto attorno viene creato per voce con una dimensione di finestra di -15, che zlib legge come deflate grezzo senza header zlib, e non viene mai consegnato a un altro thread. Il central directory, header locali inclusi, è completamente analizzato prima che qualsiasi worker parta, così cercare una voce per nome è, al momento in cui inizia la concorrenza, una ricerca hash read-only. Le ricerche non distinguono le maiuscole e respingono i nomi con segmenti .. nel percorso
Una conseguenza conta quando chiamate TXLSXWorkbook.Open(Stream) con il vostro stream. Il gate viene avvolto attorno a quello stream, e il suo lock coordina tra loro i worker della libreria. Non sa niente del vostro codice. Se un altro thread della vostra applicazione legge o riposiziona lo stesso TStream mentre Open gira, la race sul cursore del primo paragrafo è tornata, quindi passate lo stream e lasciatelo stare finché Open non restituisce
Quanto costa un lock sotto contesa?
Meno di quanto "un lock globale sull'archivio" suggerisca, grazie a quanto lavoro copre ogni acquisizione. L'inflater riempie il proprio input a blocchi di 64 KB di byte compressi, quindi un passaggio per il gate alimenta 64 KB di dati deflate a un worker che poi li decodifica e li analizza senza tenere nulla. All'espansione di cinque-dieci volte assunta prima, quel refill diventa circa 320-640 KB di markup del foglio. Il lock in sé copre una lettura posizionata che di solito viene servita dalla file cache del sistema operativo
Il rapporto si inverte in tre punti, tutti sulla input o sulla macchina. I membri conservati senza compressione passano per il gate una volta per chiamata di lettura senza lavoro di inflate tra le acquisizioni; la maggior parte dei writer deflatta le parti dei fogli, ma un pacchetto prodotto da uno strumento che conserva tutto serializzerà di più. Un file freddo su storage lento o di rete allarga la sezione critica, dato che la lettura dentro diventa un trasferimento vero. E oltre una manciata di worker il gate comunque non è il primo muro: il parsing dei fogli alloca pesantemente, e il memory manager Delphi serializza le allocazioni tra thread ben prima che il read gate saturi
Quell'ultimo punto decide il numero di thread. TXLSXWorkbook.ParallelParseThreads vale 0 per default, che avvia un worker per processore logico, mai più del numero di fogli. Su un laptop con quattro-otto processori logici quel default va bene. Su un server di build a 32 thread che apre cartelle di lavoro con decine di fogli, impostate un tetto esplicito piccolo come 4: i worker extra in gran parte fanno la coda sull'allocatore e ognuno tiene il proprio inflater e i propri buffer. Per trovare il numero giusto per i vostri file, aprite una cartella di lavoro rappresentativa in un ciclo con la proprietà a 1, 2, 4 e 8, e confrontate il wall time con il peak working set in Task Manager o Process Explorer
Leggere una voce fino in fondo è ciò che fa scattare il controllo CRC
Ogni entry stream che l'archivio restituisce controlla se stesso, ma solo alla fine. Accumula un CRC32 progressivo mentre i byte passano, e quando la sua posizione raggiunge la dimensione non compressa registrata nel central directory confronta entrambi i valori e sonda un byte in più. I guasti emergono come eccezioni con messaggi letterali: 'ZIP entry uncompressed size mismatch', 'ZIP entry CRC32 mismatch', 'ZIP entry exceeds its declared size', e 'ZIP entry ended before its declared size' per un membro che finisce in anticipo
Un lettore XML si ferma al tag di chiusura </worksheet>. Tutto ciò che viene dopo, spesso solo un newline finale, resta non letto, la posizione non raggiunge mai la dimensione dichiarata, e il confronto non gira mai. Il design a stadi si prendeva quel controllo gratis, dato che copiare una voce in un buffer legge ogni byte. Un parser che legge direttamente l'entry stream no, quindi ogni worker HotXLS svuota ciò che il parser ha lasciato con un buffer di scarto da 32 KB prima di liberare lo stream, e liberare lo stream più esterno rilascia l'inflater e il sub-stream sotto di lui
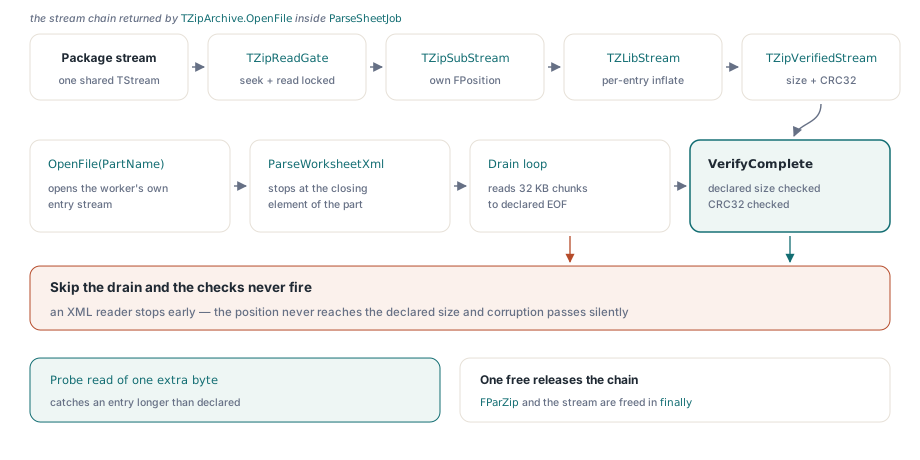
La stessa regola vale quando il vostro codice usa TZipArchive da lxZipArchive, per esempio per un controllo di sanità su un pacchetto in arrivo prima di passarlo al loader della cartella di lavoro. Una funzione che legge solo i primi kilobyte di ogni parte per annusarne l'elemento radice non prova niente sull'integrità. Leggete fino in fondo:
uses
  Classes, SysUtils, lxZipArchive;

// Legge una parte del pacchetto fino alla sua fine dichiarata così i controlli
// di dimensione e CRC32 girano (helper vostro, non della libreria)
function PartIsIntact(Zip: TZipArchive; const PartName: WideString;
  out Problem: string): Boolean;
var
  Stream: TStream;
  Buffer: array [0..32767] of Byte;
begin
  Result := False;
  Problem := '';
  Stream := Zip.OpenFile(PartName);   // nil quando la parte non esiste
  if Stream = nil then
  begin
    Problem := 'part not found';
    Exit;
  end;
  try
    try
      while Stream.Read(Buffer, SizeOf(Buffer)) > 0 do
        ;
      Result := True;
    except
      on E: Exception do
        Problem := E.Message;          // per esempio 'ZIP entry CRC32 mismatch'
    end;
  finally
    Stream.Free;
  end;
end;

var
  Zip: TZipArchive;
  Problem: string;
begin
  Zip := TZipArchive.Create;
  try
    Zip.OpenArchive('quarterly-consolidation.xlsx');
    if not PartIsIntact(Zip, 'xl/worksheets/sheet1.xml', Problem) then
      Writeln('sheet1.xml: ', Problem);
  finally
    Zip.Free;
  end;
end;
La seconda trappola in quel codice è il rewind. Gli entry stream sono forward-only: leggere Size funziona, perché la dimensione dichiarata è nota in anticipo, ma impostare Position := 0 dopo un'occhiata solleva 'ZIP entry stream is forward-only'. Se un componente insiste per la seek, aprite la voce una seconda volta con OpenFile, che costa poco e vi dà uno stream fresco all'offset zero. Più thread possono chiamare ciascuno OpenFile su un archivio aperto in lettura, visto che è esattamente ciò che fa il loader della cartella di lavoro, purché nessuno liberi l'archivio finché i loro stream sono in vita
Cosa gira ancora in serie, e l'interruttore che lo spegne
La fase A gira ancora, senza l'estrazione. Crea ogni foglio di lavoro e legge le sue relationship sul thread chiamante, che è ciò che lascia ogni mappa condivisa immutabile una volta che i worker partono. La tabella delle stringhe condivise e le tabelle dei formati di cella sono complete prima che la fase B inizi e non vengono mai scritte durante. La fase C percorre comunque i fogli in ordine dopo, per commenti, disegni, grafici e tabelle, saltando qualsiasi foglio la cui part manca dal pacchetto
uses
  SysUtils, lxHandleX;

var
  Wb: TXLSXWorkbook;
begin
  Wb := TXLSXWorkbook.Create;
  try
    Wb.ParallelParse := True;        // default; False analizza un foglio alla volta
    Wb.ParallelParseThreads := 4;    // 0 = un worker per processore logico
    Wb.SelectedSheets.Add('Q3 Detail');  // opzionale: analizza le celle solo di questo foglio
    if Wb.Open('quarterly-consolidation.xlsx') <> 1 then
      raise Exception.Create('Workbook open failed');
    // La cartella di lavoro caricata è identica quale che sia il percorso che l'ha analizzata
  finally
    Wb.Free;
  end;
end;
Impostare ParallelParse a False prima di Open esegue lo stesso lavoro per foglio con un conteggio di thread di uno, e il pool degenera in un semplice ciclo sul thread chiamante. Una cartella di lavoro con un solo foglio prende quel percorso a prescindere. Tenete a mente l'interruttore quando diagnose un problema di apertura: toglie il threading dal quadro in una riga, ed entrambi i percorsi girano lo stesso codice di parsing, così la cartella di lavoro che ricevete indietro non dipende dall'impostazione
Gli errori mantengono anche loro la forma seriale. Quando un worker solleva, non vengono più distribuiti fogli, ogni worker si ricongiunge, e l'eccezione dell'indice di foglio più basso viene risollevata sul thread chiamante, così un sheet3.xml corrotto emerge comunque come una sola eccezione da Open. Con RecoveryMode a True, un foglio che fallisce l'analisi viene invece saltato e registrato come avvertimento nelle diagnostica della cartella di lavoro. I fogli lasciati fuori da SelectedSheets non aprono mai il proprio entry stream, e MetadataOnly salta del tutto la fase parallela. La messa a punto più ampia del percorso di apertura è trattata nella guida alle prestazioni con cartelle di lavoro grandi in Delphi
Il read gate, la fase di apertura parallela e l'accesso ZIP a livello di voce mostrati qui fanno parte dello HotXLS Delphi Excel component per Delphi e C++Builder, che viaggia con sorgente completa, così potete leggere lxZipArchive.pas accanto alle proprietà di apertura di TXLSXWorkbook descritte nella pagina prodotto