Un loader Delphi che analizza un pacchetto XLSX di otto fogli su otto worker thread può mostrare un grafico CPU che resta poco sopra un solo core, e spazzare il numero di thread da due a otto lascia il cronometro quasi dov'era. Con due thread il caricamento può persino risultare più lento di un semplice ciclo seriale. Il codice di parsing non prende alcun lock proprio e i fogli non condividono dati, quindi l'attesa avviene in un punto che il sorgente non menziona mai: dentro il gestore di memoria, che ciascuno di quei worker chiama per ogni nome di elemento, valore di attributo e cella
Il numero di thread è la manopola su cui tutti agiscono per primi. Per codice limitato dalle allocazioni sposta pochissimo. Ciò che sposta la curva è il numero di allocazioni heap che ogni cella costa
Come HotXLS spezza Open in tre fasi
HotXLS analizza i fogli di lavoro di un pacchetto XLSX multifoglio sui worker thread per default. TXLSXWorkbook.ParallelParse parte True, e ParallelParseThreads parte da 0, il che significa un worker per processore logico segnalato dal sistema operativo, mai più worker di quanti siano i fogli da analizzare. Solo una delle tre fasi di Open gira su quei worker. La fase A è seriale: legge la parte workbook, le shared string e gli stili, crea ogni foglio con nome e visibilità, e analizza il file delle relationship di ciascun foglio così i target di hyperlink e tabelle sono già risolti. Quando un worker parte, ogni tabella di lookup che consulta è completa e viene solo letta
La fase B consegna ogni foglio a un worker. I worker rivendicano indici di foglio da un contatore condiviso con un increment interlocked, così una cartella con un foglio grande e sette piccoli si bilancia da sola senza scheduler: chi finisce un foglio piccolo prende semplicemente l'indice successivo. Il contenitore ZIP è la parte che non può essere condivisa ingenuamente, perché uno stream deflate porta stato da un blocco al successivo e due thread non possono far avanzare lo stesso decompressore. Ogni worker apre quindi il proprio decompressore sulla propria entry del foglio e fa fluire l'XML direttamente nel proprio reader. L'handle del file è l'unica risorsa condivisa, e il lock che lo copre riguarda una singola seek-and-read di byte compressi alla volta. Decompressione e parsing girano entrambi in parallelo, e l'XML di nessun foglio resta mai completamente inflate in memoria. Finito il parsing, il worker legge la sua entry fino alla fine così i controlli su size e CRC dello ZIP girano comunque
La fase C torna a un thread singolo per le parti che pendono da ciascun foglio: commenti e threaded comment, disegni e grafici, tabelle e impostazioni di stampa. Nella maggior parte delle cartelle sono piccole accanto all'XML delle celle
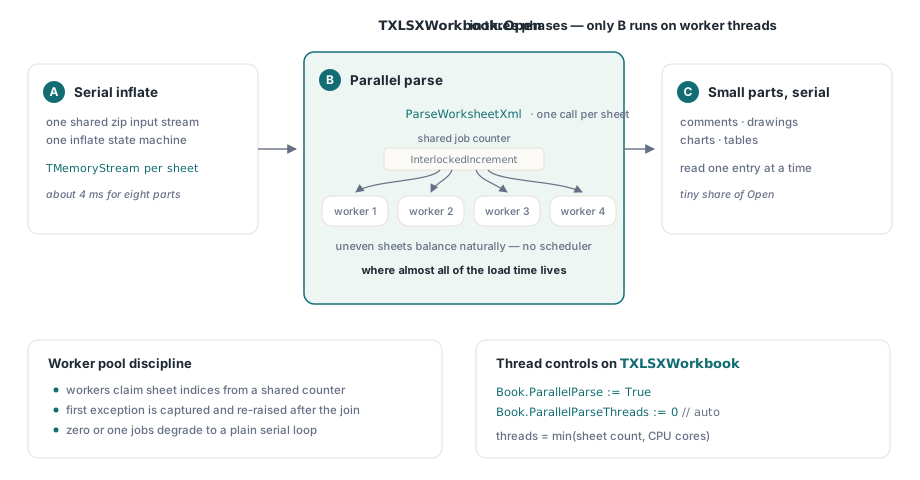
Gli errori tornano sul thread chiamante. Quando un foglio solleva un'eccezione durante il parsing, il pool smette di distribuire nuovi indici, aspetta i worker ancora in esecuzione e poi rilancia da Open l'eccezione del foglio con numero più basso tra quelli falliti, così il report segue l'ordine dei fogli e chi chiama non deve mai gestire un'eccezione che scappa da un thread worker. Con RecoveryMode a True, un foglio che non si riesce ad analizzare viene saltato, un avviso finisce in Diagnostics, e i fogli rimanenti si caricano normalmente. Impostare ParallelParse a False esegue lo stesso parser sui fogli uno alla volta e produce risultati identici
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Entrambi i valori sono i default; scriverli esplicitamente tiene
    // la scelta visibile in code review
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = un worker per CPU logica, con tetto al numero di fogli
    Book.RecoveryMode := False;      // un foglio che fallisce il parsing solleva da Open
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // ogni foglio è completamente caricato qui; leggi le celle come al solito
  finally
    Book.Free;
  end;
end;
Perché thread extra rendono più lento un parser ricco di allocazioni?
Il parsing dei fogli è fatto in gran parte di allocazioni piccole, e il gestore di memoria predefinito di Delphi fa fare i turni ai thread su quelle. Un reader XML naive produce una stringa per ogni nome di elemento, un'altra per ogni nome e valore di attributo, un Variant per la cella e una stringa per il suo testo. Il gestore di memoria predefinito tiene i small block in pool raggruppati per dimensione e protegge ogni pool con un lock. Un thread che trova il lock occupato rallenta e dorme prima di riprovare. Quando otto worker chiedono tutti la stessa manciata di dimensioni minuscole, continuano a scontrarsi sugli stessi pool, e thread che nel sorgente sembrano indipendenti finiscono per girare uno dopo l'altro
Questo spiega entrambi i sintomi dell'apertura. Il tempo CPU resta vicino al tempo reale perché un thread addormentato non consuma CPU, e la spazzata dei thread resta piatta perché sono i lock del pool, non i core, a dare il ritmo. Due thread possono perdere contro uno in modo netto: ogni allocazione ora paga il passaggio del lock di mano in mano tra i core, mentre il ciclo seriale non contende mai nulla
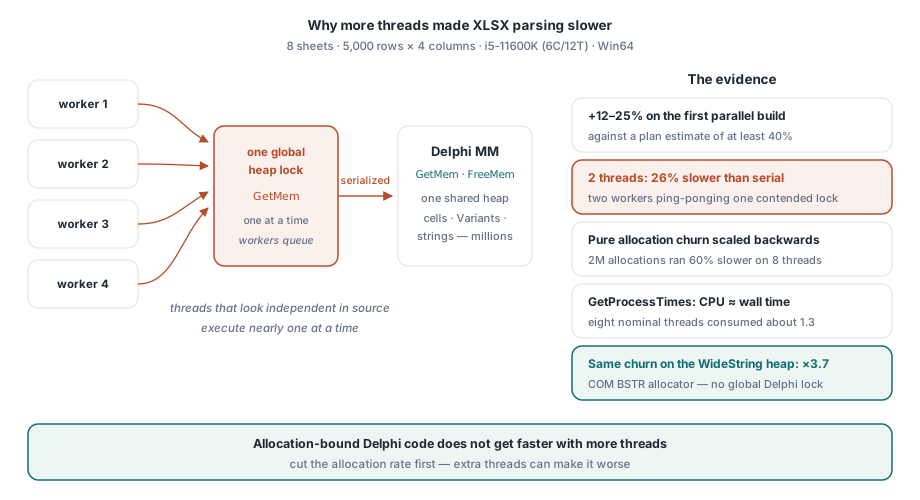
Un tipo di stringa sta fuori da tutto questo su Windows. Una WideString è una COM BSTR, allocata dall'allocatore di stringhe OLE di sistema e non dal gestore di memoria di Delphi, quindi il traffico WideString non fa mai la coda sui pool Delphi. HotXLS memorizza il testo delle celle come WideString, il che conta più per il caricamento parallelo di quanto non abbia mai contato per il percorso seriale
Misurare la contesa sulle tue cartelle di lavoro
Due numeri dicono se un caricamento è limitato dalle allocazioni: come cambia il tempo reale al salire del numero di worker e quanta CPU il processo ha consumato nello stesso intervallo. Se il tempo CPU diviso il tempo reale resta vicino a 1,0 mentre otto worker sono nominalmente occupati, stanno facendo la coda anziché analizzare. La spazzata qui sotto apre lo stesso file con da uno a otto worker e stampa entrambe le cifre. È un harness di misurazione per il tuo progetto di test; solo i membri di TXLSXWorkbook vengono da HotXLS
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Helper tuo: tempo CPU user + kernel di questo processo, in millisecondi
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // 100 ns tick to ms
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 esegue il semplice ciclo seriale
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Esegui la spazzata più volte e tieni la cifra migliore per ogni numero di worker, dato che la prima esecuzione paga anche una cache disco fredda. Una curva di tempo reale piatta con CPU/wall vicino a 1 significa che il tetto è il gestore di memoria. Se il tempo reale continua a scendere mentre CPU/wall sale verso il numero di worker, il file è limitato dal parsing e i worker extra stanno rendendo
Una curva piatta porta alla domanda successiva: quali allocazioni sono responsabili? Un wrapper del gestore di memoria che conta le chiamate per dimensione risponde in pochi minuti senza alcun profiler. La versione qui sotto conta solo GetMem e lascia FreeMem e ReallocMem puntare al gestore originale, che basta per vedere da dove arriva il traffico
// Diagnostica da aggiungere al tuo test harness; non fa parte di HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // il churn di small block da tenere d'occhio
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Installa il contatore subito prima di Open, rimuovilo subito dopo e dividi AllocCount per il numero di celle del file. Quella cifra per cella è quella da seguire da build a build, e la quota di blocchi a 32 byte o meno mostra se dominano le stringhe corte. Controlla prima di scrivere un pool di oggetti cella: ogni oggetto cella è un'allocazione, e le stringhe effimere create mentre la cella viene analizzata possono superarlo più volte
Dove si nascondono le allocazioni nell'XML dei fogli di lavoro
Una cella come <c r="B7" s="3" t="s"><v>42</v></c> sembra minuscola su disco. Un reader diretto la trasforma comunque in una serie di stringhe nuove: i nomi degli elementi c e v, tre nomi di attributo, tre valori di attributo e il contenuto testuale. Convertire ogni token UTF-8 attraverso la RTL aggiunge un UnicodeString intermedio prima che esista la WideString finale. Nessuna di quelle stringhe sopravvive alla cella, e ognuna è un giro dal gestore di memoria
Il reader XML di HotXLS attacca le due fonti più grosse. I nomi degli elementi nell'XML dei fogli vengono da un vocabolario piccolissimo (row, c, v, f, is), così il reader tiene una breve cache dei nomi già incontrati, confronta i byte grezzi di ogni nuovo nome con quella cache e restituisce la stringa in cache a corrispondenza avvenuta. Le copie in cache sono deliberatamente AnsiString. AnsiString è reference-counted, quindi consegnare un'istanza in cache costa un incremento di contatore e nessuna allocazione. Una cache di nomi WideString non comprerebbe nulla: WideString non ha reference count, e ogni assegnazione fa una nuova allocazione di sistema
Nomi di attributo, valori di attributo e testo delle celle prendono l'altra strada. Il reader decodifica UTF-8 direttamente dal suo buffer di scansione in due passaggi: il primo conta le code unit UTF-16, il secondo riempie una WideString allocata una volta a esattamente quella lunghezza. È un'allocazione per token, e atterra sull'allocatore di stringhe di sistema invece che sui pool Delphi. I character reference come A e le entità predefinite vengono risolti dallo scanner prima che la decodifica parta, così il decodificatore vede solo UTF-8 puro. Per le sequenze di byte che non sono UTF-8 valido, il decodificatore copia i byte incriminati uno alla volta dove la conversione RTL li scarterebbe o li sostituirebbe, così un file danneggiato produce comunque ASCII leggibile attorno al punto cattivo. L'input valido si decodifica allo stesso testo in entrambi i modi
Entrambi i trucchi valgono per il tuo codice di parsing Delphi. Mettere in cache le stringhe fa risparmiare allocazioni solo quando il tipo di stringa è reference-counted, e decodificare direttamente nel tipo di destinazione elimina il temporaneo che le comode funzioni di conversione della RTL creano a ogni chiamata
Quali cartelle traggono vantaggio, e quali impostazioni scegliere
Il parsing parallelo lavora a granularità di foglio, quindi la forma della cartella decide gran parte del risultato. Parecchi fogli di dimensioni simili sono il caso migliore, inclusi i file che ottieni duplicando un foglio modello una volta per regione o per mese. Una cartella che è un unico foglio gigante viene analizzata da un solo worker a prescindere da ciò che dice ParallelParseThreads; per quella forma lo strumento di lettura diretta in streaming calza meglio, perché non costruisce mai l'intera cartella in memoria. Il tempo speso su commenti, grafici e disegni resta nella fase C seriale. Un file con zero o un foglio da analizzare salta il pool ed esegue il semplice ciclo seriale
Quando contano solo alcuni fogli, elenca i loro nomi in SelectedSheets prima di chiamare Open. Gli altri fogli vengono comunque creati con nome e visibilità ma senza celle, i worker li passano oltre, e LoadSheet ne riempie uno più tardi se l'utente lo apre
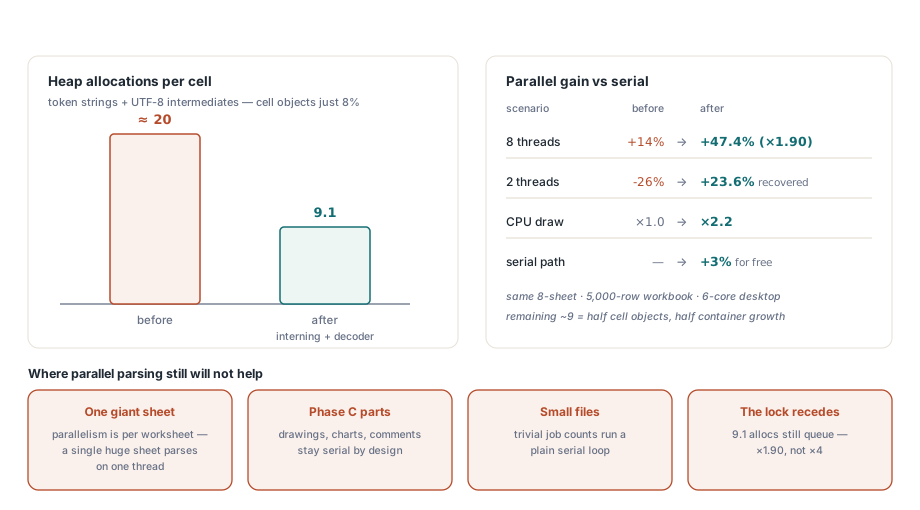
Lascia ParallelParse attivo per i tool desktop e i batch job che aprono una cartella alla volta. Quel default è il più sicuro: i risultati corrispondono al percorso seriale, e una proprietà lo spegne se mai emerge una domanda sul threading. Un server che apre già parecchie cartelle in concorrenza è un'altra storia. Ogni thread di richiesta sta allocando a sua volta, così ogni worker di parsing in più aggiunge un altro contendente per gli stessi pool del gestore di memoria; lì imposta ParallelParseThreads a 2, e alzalo solo dopo che la spazzata vista sopra, eseguita su quel server sotto il suo carico normale, mostra che i worker extra si ripagano. Meno allocazioni per cella alzano il tetto senza rimuoverlo. Gli oggetti cella e la crescita dei contenitori passano ancora per i pool Delphi, ed è per questo che il guadagno con otto worker resta ben al di sotto di otto volte. Per il resto del kit di caricamento e salvataggio, dal riutilizzo degli stili ai callback di riga in blocco, si veda la guida sulle prestazioni delle cartelle di grandi dimensioni in Delphi
Il pool di worker, gli interruttori ParallelParse e ParallelParseThreads e il reader XML a basso consumo di allocazioni si trovano tutti nell'HotXLS Delphi Excel Component, che legge e scrive XLS, XLSX e ODS direttamente da codice Delphi e C++Builder senza Excel installato sulla macchina