L'attributo axis="rowAxis" su un elemento pivotField si legge come XML perfettamente sensato, e un lettore che lo mappa a "campo riga" caricherà la pivot con ogni campo sull'asse giusto. Passate la stessa parte per un validatore costruito dallo schema di ECMA-376 Parte 1 §18.10 e fallisce al primo attributo: ST_Axis ha esattamente quattro token, axisRow, axisCol, axisPage e axisValues, e rowAxis non è uno di loro. Uno scrittore di pivot deve soddisfare lo schema, non il proprio lettore, perché le persone che aprono il file usano Excel e i loro parser
Le definizioni dei campi pivot sono piene di regole come quella. Tre tendono a scivolare oltre un test di round trip: i token dell'enumerazione, il requisito che un elemento items non sia mai vuoto, e le voci subtotal in coda che Excel elenca dopo gli item dati. Altre due stanno sul lato lettura, in attributi che Excel omette perché tengono il loro default di schema. Il resto dell'articolo percorre ogni regola, mostra come deve essere l'XML e mostra le chiamate Delphi che lo producono
Perché un round trip non può beccare un token di asse sbagliato
Un round trip prova che lo scrittore e il lettore sono d'accordo tra loro, e nient'altro. Se il lettore accetta sia axisRow sia rowAxis, uno scrittore che emette quello sbagliato passa ogni controllo salva-e-ricarica che possiate scrivere, perché il lettore ripara l'errore alla reingresso. Il difetto appare solo quando un consumatore più severo apre la parte: un validatore di schema, un parser generato dall'XSD, o Excel che decide che la parte va riparata
HotXLS separa i due lati di proposito. Lo scrittore XLSX emette solo i quattro token ST_Axis, mentre il lettore pivot mappa anche le grafie dall'aspetto inglese rowAxis, colAxis, pageAxis e dataAxis all'asse corrispondente, così i file di produttori che le usano caricano comunque col layout intatto. L'output è tenuto allo schema; l'input deve solo essere riconoscibile. Il contrario, un lettore severo abbinato a uno scrittore sciatto, almeno fallirebbe rumorosamente nei vostri test; un lettore indulgente abbinato a uno scrittore sciatto non fallisce da nessuna parte che possiate vedere
<!-- invalido: rowAxis non è un valore ST_Axis, e CT_Items non può essere vuoto -->
<pivotField axis="rowAxis" defaultSubtotal="1"><items count="0"></items></pivotField>

<!-- valido: token ST_Axis, item veri, subtotal default in coda -->
<pivotField axis="axisRow" defaultSubtotal="1">
  <items count="4"><item x="0"/><item x="1"/><item x="2" h="1"/><item t="default"/></items>
</pivotField>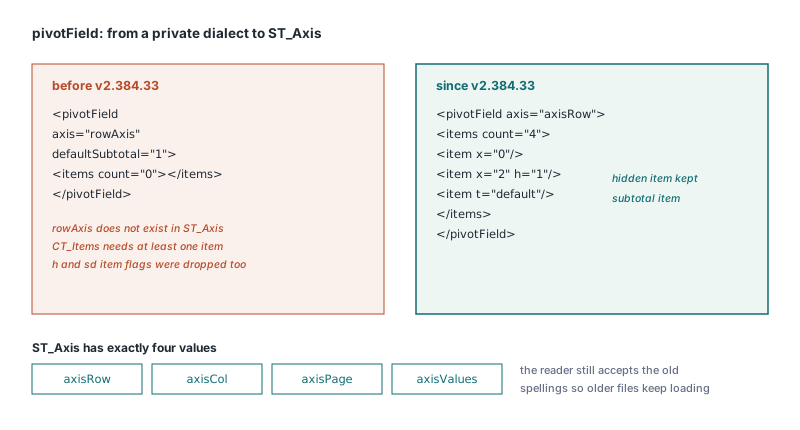
Che cosa si aspetta CT_PivotField oltre l'asse
CT_PivotField ha altri tre requisiti facili da perdere. Un campo aggregato nell'area dei valori deve dirlo sulla propria definizione con dataField="1", anche se la lista <dataFields> già lo referenzia. HotXLS imposta quel flag su ogni campo pivot a cui una voce in DataFields punta, così un campo aggiunto con AddDataFieldByName è marcato in entrambi i posti
La seconda regola è strutturale. CT_Items esige almeno un figlio item, il che rende <items count="0"></items> non valido anche se è XML ben formato e si analizza ovunque. Quando un campo non ha item, HotXLS lascia fuori l'intero elemento items. La terza regola riguarda lo stato di ogni item: un membro nascosto porta h="1" e un membro con dettagli collassati porta sd="0". Entrambi vengono da TXLSPivotItem.IsHidden e TXLSPivotItem.IsDetailHidden e vengono scritti a ogni salvataggio, così un filtro impostato nel codice sopravvive fino a Excel
Item subtotal in coda e la trappola del conteggio
Quando un campo ha item, Excel fa seguire agli item dati un item extra per ogni funzione subtotal, tipizzato con ST_ItemType. Il subtotal automatico è <item t="default"/>; le funzioni esplicite usano sum, countA, avg, max, min, product, count, stdDev, stdDevP, var e varP. Queste voci non portano alcun indice x nella cache, e sono incluse nell'attributo count di items. Uno scrittore che le lascia fuori produce una lista items che non corrisponde più ai flag subtotal sullo stesso elemento
HotXLS ricava la coda da TXLSPivotField.Subtotals al salvataggio: un item t="…" per funzione nel set, in ordine di enumerazione, aggiunto al conteggio, più il corrispondente attributo in stile sumSubtotal="1" sul campo. I campi creati da AddPivotTable partono con un set vuoto, che scrive defaultSubtotal="0" e nessun item in coda affatto. Per i report generati, lasciate il set vuoto: le righe di subtotal cambiano l'altezza della pivot e spostano qualsiasi cosa piazzata sotto. Aggiungete funzioni a Subtotals solo sui campi dove un lettore ha bisogno delle righe extra
La nomenclatura merita un secondo sguardo prima di scegliere una funzione. xlpsCount mappa a countA, che conta tutte le voci non vuote, e xlpsCountNums mappa a count, che conta solo i numeri. Chi legge "count" nell'XML e stende la mano verso xlpsCount prende l'altra funzione
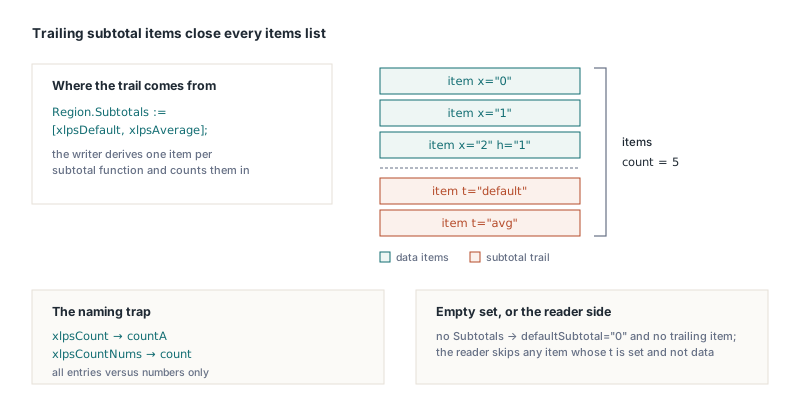
Il programma sotto costruisce una pivot da un foglio dati esistente con un campo riga, un campo colonna e un campo valore. Il campo Region riceve il subtotal automatico più una media, il che produce due item in coda dopo i suoi item dati e dataField="1" su Revenue
uses
  SysUtils, lxHandleX, lxPivot;

var
  Book  : TXLSXWorkbook;
  Sheet : TXLSXWorksheet;
  Pivot : TXLSPivotTable;
  Region: TXLSPivotField;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    Sheet := Book.Sheets[1];                  // Sheets è a base 1
    Pivot := Sheet.AddPivotTable('Data!$A$1:$D$800', 3, 6, 'RegionTotals');
    if Pivot = nil then
      raise Exception.Create('Bad source range or anchor');

    Region := Pivot.AddRowField('Region');    // nil se un campo simile non esiste
    if Region <> nil then
      Region.Subtotals := [xlpsDefault, xlpsAverage];  // -> t="default", t="avg"
    Pivot.AddColumnField('Quarter');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);      // Revenue riceve dataField="1"

    Book.SaveAs('orders-pivot.xlsx');
  finally
    Book.Free;
  end;
end;
Leggere ciò che Excel omette
Il lettore ha il problema speculare. Un campo pivot fatto da Excel elenca le sue voci subtotal in items, e caricarle come membri ordinari darebbe al campo item fantasma che non puntano a nessun valore di cache. HotXLS salta qualsiasi item il cui attributo t è presente e non è data, il che copre le voci subtotal, grand-total e blank. Le funzioni subtotal arrivano attraverso i flag del campo stesso e atterrano in Subtotals, così il codice che percorre Items vede solo membri veri e ogni CacheItemIndex si riferisce a un valore di cache
Gli attributi mancanti sono l'altra metà. Nello schema, defaultSubtotal su CT_PivotField e containsString su CT_SharedItems valgono entrambi true per default, e Excel li omette quando tengono quel valore. HotXLS legge un defaultSubtotal assente come true e aggiunge xlpsDefault a Subtotals quando il campo non porta flag subtotal espliciti, che è come Excel stesso mostra un campo simile. Un containsString assente si legge anche come true, così un campo cache di testo semplice viene classificato come dati stringa. Leggete uno dei due attributi come false e ogni pivot salvata da Excel perde i suoi subtotal automatici al caricamento, mentre i campi di testo diventano qualche altro tipo. Uno scrittore che scrive sempre ogni attributo per esteso non tocca mai questo percorso; solo i file di un altro produttore lo esercitano
Una cartella di lavoro Excel caricata è il test input giusto qui, perché è l'unico tipo di file che lascia fuori quegli attributi. Il controllo sotto apre uno e percorre un campo riga:
var
  Book : TXLSXWorkbook;
  Pivot: TXLSPivotTable;
  Fld  : TXLSPivotField;
  I, J : Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('saved-by-excel.xlsx');
    Pivot := Book.Sheets[1].PivotTables.FindByName('PivotTable1');
    if Pivot = nil then
      Exit;
    for I := 0 to Pivot.FieldCount - 1 do
    begin
      Fld := Pivot.Fields[I];
      if Fld.Axis <> xlpfaRowField then
        Continue;
      // Un campo Excel senza attributi subtotal riporta comunque il default
      if xlpsDefault in Fld.Subtotals then
        Writeln(Fld.Name, ': automatic subtotal');
      // Le voci subtotal sono state saltate, quindi ogni item mappa a un valore di cache
      for J := 0 to Fld.ItemCount - 1 do
        Assert(Fld.Items[J].CacheItemIndex >= 0);  // controllo suggerito per i vostri test
    end;
  finally
    Book.Free;
  end;
end;
Perché numFmtId="General" non è valido sui campi cache
numFmtId="General" non è valido perché ST_NumFmtId è un intero senza segno, per quanto naturale sia prendere in prestito il nome che gli utenti vedono nella finestra Formato celle. Un parser che tipizza gli attributi dallo schema rifiuta il nome in blocco, e quella classe di fallimento è esattamente ciò che diventa una finestra di riparazione in Excel; l'articolo su le regole OPC e di markup dietro la finestra di riparazione di Excel copre come quelle finestre vengono innescate. HotXLS scrive ogni cacheField con un numFmtId numerico preso dal NumberFormat del campo cache, che è 0, il formato General incorporato, a meno che qualcosa lo abbia impostato
Le tabelle pivot sotto la riga 65535 vogliono posizioni a 32 bit
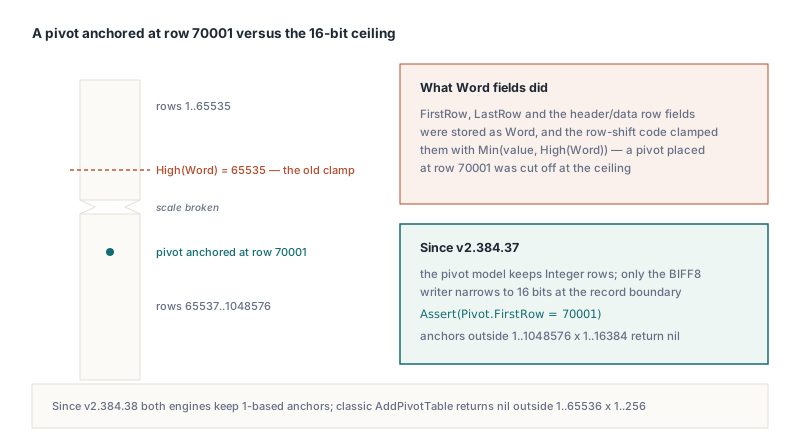
Un modello pivot condiviso dai motori XLS e XLSX è tentato di prendere in prestito le larghezze dei suoi campi dal record SxView BIFF8, dove 16 bit coprono ogni riga che un foglio classico può tenere. Un foglio XLSX corre fino a 1.048.576 righe. Conservate FirstRow, LastRow, FirstHeaderRow, FirstDataRow e le controparti di colonna come Word, limitatele con Min(Value, High(Word)), e una pivot ancorata alla riga 70001 viene tagliata a 65535
Su TXLSPivotTable quelle proprietà sono Integer, e solo lo scrittore BIFF8 le restringe al confine del record. TXLSXWorksheet.AddPivotTable restituisce nil per un'ancora fuori da 1..1048576 per 1..16384, e AddPivotTableCopy restituisce nil quando l'estensione della copia uscirebbe dalla griglia
var
  Book, Check: TXLSXWorkbook;
  Pivot      : TXLSPivotTable;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Open('orders.xlsx');
    // La riga 70001 è oltre l'intervallo a 16 bit
    Pivot := Book.Sheets[1].AddPivotTable('Data!$A$1:$D$800', 70001, 1, 'LateTotals');
    if Pivot = nil then
      Exit;  // ancora fuori dal foglio o intervallo sorgente irrisolvibile
    Pivot.AddRowField('Region');
    Pivot.AddDataFieldByName('Revenue', xlpaSum);
    Book.SaveAs('late.xlsx');
  finally
    Book.Free;
  end;

  Check := TXLSXWorkbook.Create;
  try
    Check.Open('late.xlsx');
    Pivot := Check.Sheets[1].PivotTables.FindByName('LateTotals');
    // Assert è un controllo suggerito per i vostri test
    Assert((Pivot <> nil) and (Pivot.FirstRow = 70001));
  finally
    Check.Free;
  end;
end;
Il motore XLS classico segue la stessa convenzione a base 1. I record SxView e DConRef conservano valori a base 0, mentre il modello, come il motore XLSX e Cells[Row, Col], mantiene posizioni a base 1: il lettore BIFF8 aggiunge 1 e lo scrittore sottrae 1 al confine del record. La AddPivotTable classica restituisce nil per un'ancora fuori da 1..65536 per 1..256, quindi ancorate le pivot a (1, 1) invece che a (0, 0). Il layout dei record in sé è descritto in i record SX BIFF8 dietro le tabelle pivot dei .xls classici
Testare contro lo schema invece che contro il vostro lettore
Ogni trappola sopra sopravvive a un round trip quando il lato indulgente e il lato difettoso vivano nella stessa libreria. Tre tipi di controllo li beccano. Una validazione di schema delle parti generate pivotTableN.xml e pivotCacheDefinitionN.xml becca i token inventati, gli elementi items vuoti e gli id di formato nominati. File salvati da Excel, passati per il vostro lettore, esercitano gli attributi che Excel omette ai loro default. Asserzioni che piantano il token esatto nell'XML scritto, tipo axis="axisRow", beccano uno scrittore che deriva verso una grafie che solo il vostro lettore capisce; asserire sull'asse analizzato non può
Le pivot costruite tramite l'API, campi calcolati, item calcolati e layout percent-of-total mostrati in costruire e rinfrescare tabelle pivot XLSX con campi calcolati inclusi, escono con queste regole applicate e nessun codice extra da parte vostra. Il lavoro che resta a voi è scegliere quali campi ricevono i subtotal e quale funzione di conteggio intendete davvero
Il componente foglio di calcolo HotXLS per Delphi costruisce, legge e salva tabelle pivot XLS e XLSX da codice Delphi e C++Builder, senza installazione di Excel né automazione COM sulla macchina che lo esegue